德国AI实验室Black Forest Labs今天发布了FLUX家族的新成员——FLUX 3。这不仅是版本号的递进,更意味着产品线的战略扩张:从单一的图像生成模型,升级为一个能同时处理图像、视频、音频甚至预测“行动”的多模态基础模型。
- 官方介绍:https://bfl.ai/blog/flux-3
- 申请测试:https://bfl.ai/models/flux-3
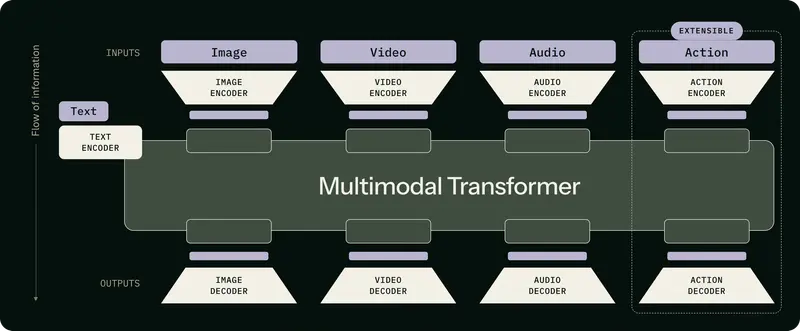
与市面上许多通过接口拼装独立模型的做法不同,BFL强调,FLUX 3是在图像、视频和音频这三种模态上联合训练完成的。该公司的核心观点是:无论是创意生成、模拟环境,还是机器人控制,本质上都属于“视觉智能”的范畴。FLUX 3正是朝着这个方向迈出的第一步,目标是打造一个“能够感知、预测并在物理和数字环境中行动”的模型。
四大产品线,开源版本排在最后
FLUX 3的能力将通过四条产品线提供给不同需求的用户,但目前大多数都还处于“只闻其声”的阶段。
- FLUX 3 Video:核心功能是文生视频、图生视频,以及最长20秒的带音频视频生成。
- FLUX 3 Image:图像生成与编辑,是前代FLUX的升级版。
- FLUX 3 Action:用于机器人视觉和行动预测,BFL已与机器人公司mimic合作开发了基于此模型的“FLUX-mimic”。
- FLUX 3 Dev:计划中的开源版本,提供开放权重访问。
目前,视频和行动模型已开放“早期访问”计划,开发者可以申请,但需经BFL审核批准。图像模型则要等到未来几周才会推出API或合作伙伴接口。至于很多开发者期待的开源版本,BFL表示要等到今年晚些时候,且其开放程度(多模态骨干网络)会比以往的FLUX Dev版本更广。
视频生成能力是本次主角
虽然FLUX 3是一个多模态模型,但从发布信息来看,视频生成无疑是当前阶段的重头戏。它支持从文本、图像、甚至关键帧生成视频,也支持输入视频和音频进行延续生成,并强调了在排版和动画设计上的能力。
BFL给出了一组早期的内部对比评估数据(生成10秒720p带音频视频),其中几个数据值得留意:
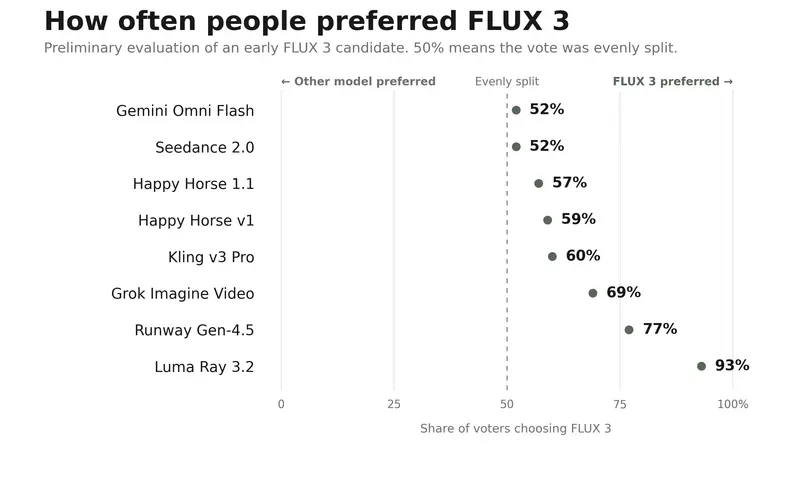
在与Grok Imagine Video、Kling v3 Pro、Happy Horse v1、Seedance 2.0等模型的对比中,FLUX 3的胜率在52%到69%之间,领先幅度不算悬殊。但在与Runway Gen-4.5和Luma Ray 3.2的对比中,胜率分别达到了77%和93%。需要指出的是,这些均为BFL自行报告的初步评估结果,未见详细的评估方法、样本量或第三方背书,参考价值有待进一步验证。
图像能力稳步提升,行动预测是远期布局
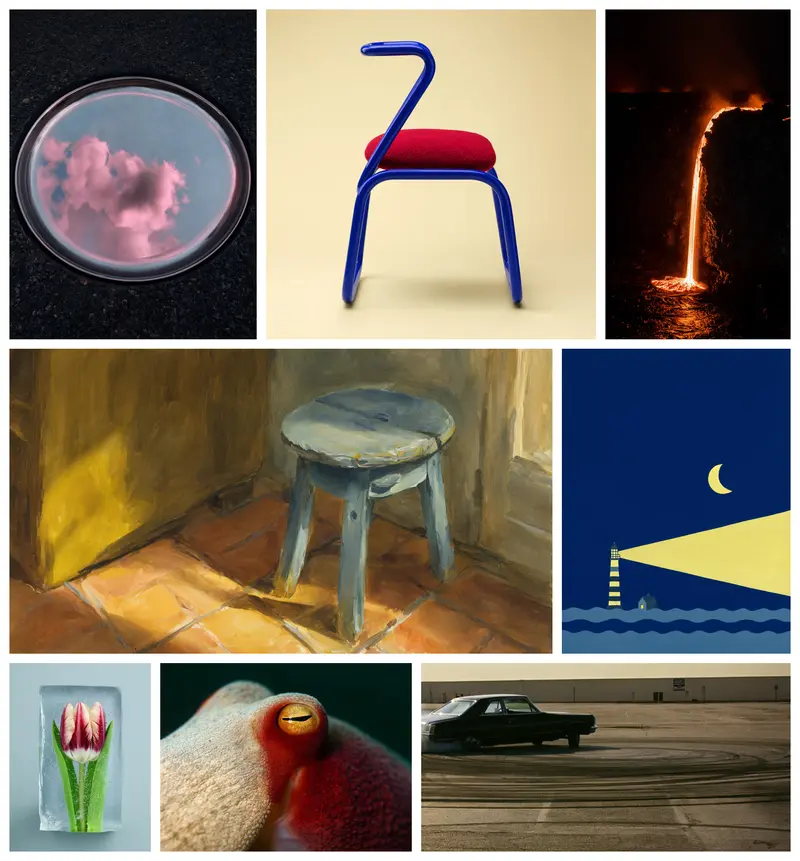
在图像方面,官方表述是“相对早期FLUX版本有显著改进”,尤其在处理复杂提示词和文本渲染方面。这更像是一次常规的模型升级,具体提升幅度还需等到公开评测后才能判断。
“行动”模块则更像一个远期技术演示。其思路是,将FLUX 3的视频骨干网络作为“动态感知基础”,再叠加少量特定任务数据微调,从而让模型学会预测和执行物理动作。这与近年来“多模态大模型即机器人大脑”的研究趋势一致,但距离实际产品化还有相当距离。
两个不容忽视的“省略号”
对于潜在的企业用户和开发者,这次发布还留有两个重要的悬念。
其一,是商业化的细节。BFL尚未公布FLUX 3的定价、服务等级协议(SLA),也没有提供任何可供复现的评估基准。对于需要做成本预估的采购方来说,目前还缺乏关键信息。
其二,是开源策略的延迟。FLUX 1.5时代的开源变体曾极大推动了其生态的采用。此次宣布开源,但将其排在产品线最后,且没有明确时间表,对于习惯了本地部署FLUX的开发者而言,无疑是一个令人失望的消息。当然,这并不否定其最终开源的承诺,只是意味着等待的时间可能会比预期的更长。
© 版权声明
文章版权归作者所有,未经允许请勿转载。