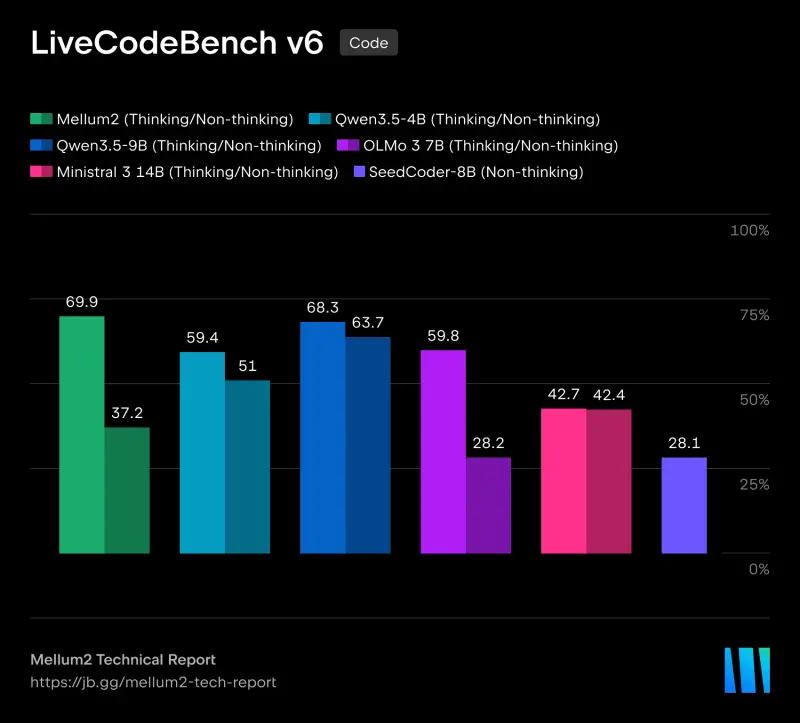
JetBrains 开源 Mellum 2:120亿参数 MoE 编码模型,激活仅 25 亿参数,支持 128K 上下文与智能体工作流,Apache 2.0 许可赋能私有部署JetBrains 正式宣布开源 Mellum 2,一款专为软件工程系统设计的 120 亿参数混合专家(MoE) 大语言模型。作为 Mellum 系列的继任者,Mellum 2 不仅在参数量上实现了三...大语言模型# JetBrains# Mellum 25个月前2100
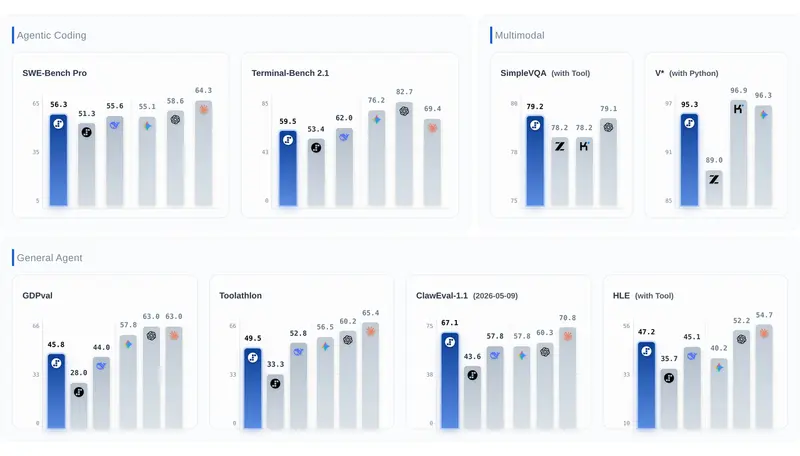
阶跃星辰发布 Step 3.7 Flash:198B 参数 MoE 视觉语言模型,支持 256K 上下文与三级推理,吞吐量达 400 tok/s,专为高频代理工作流打造阶跃星辰(StepFun)正式推出 Step 3.7 Flash,一款拥有 1980 亿参数 的稀疏混合专家(MoE)视觉语言模型。该模型将 1960 亿参数的语言主干与 18 亿参数的视觉编码器深度...大语言模型# Step 3.7 Flash# 阶跃星辰5个月前2500
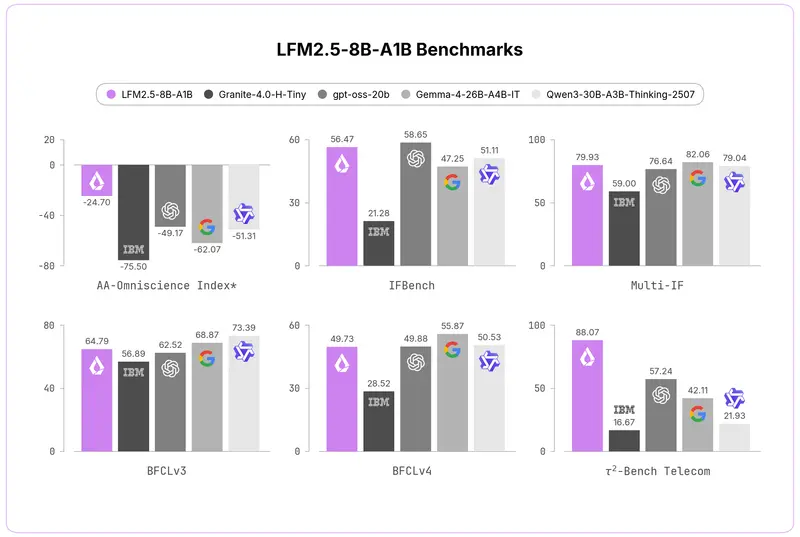
Liquid AI 发布 LFM2.5-8B-A1B:端侧 MoE 模型新标杆,128K 上下文支持链式工具调用,M5 Max 解码速度达 253 tok/sLiquid AI 正式发布了 LFM2.5-8B-A1B,这是一款专为消费级硬件设计的端侧混合专家(MoE)模型。作为 LFM2-8B-A1B 的进化版,LFM2.5 将上下文窗口扩展至 128K...大语言模型# LFM2.5-8B-A1B# Liquid AI5个月前3770
Anthropic发布Opus 4.8:新增“动态工作流”工具,AI处理复杂任务能力再升级在激烈的 AI 模型竞赛中,Anthropic 仅距 Opus 4.7 发布 41 天后,迅速推出了其最新旗舰模型 Claude Opus 4.8。此次更新不仅带来了基准测试性能的提升,更引入了旨在处...大语言模型早报# Anthropic# Opus 4.85个月前2480
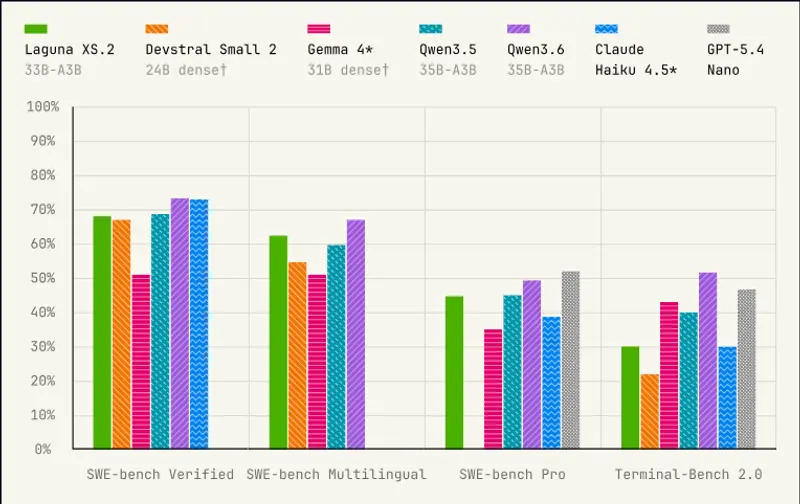
Laguna XS.2:330亿参数MoE模型,激活仅30亿,专为本地代理编码与长程任务设计,支持256K上下文与FP8量化在 AI 编程助手日益普及的今天,大多数模型仍停留在“代码片段生成”阶段,难以应对复杂的软件工程任务。Poolside 公司发布的 Laguna 系列模型(包括 Laguna M.1 和 Laguna...大语言模型# Laguna XS.2# Poolside5个月前1950
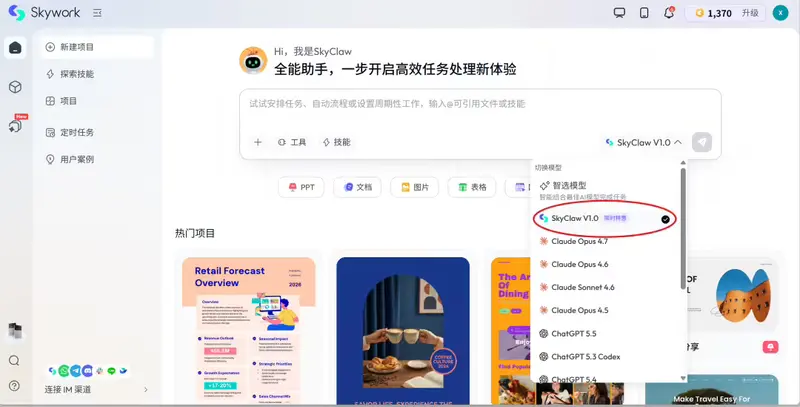
昆仑万维发布 SkyClaw-v1.0:百万 Token 上下文 Agent 模型,性能比肩 Claude Opus 4.6,价格减半在 AI Agent(智能体)技术日益成为应用核心的今天,昆仑万维集团正式推出了专为真实工作场景打造的高性能 Agent 模型 —— SkyClaw-v1.0,并同步发布轻量化版本 SkyClaw-v...大语言模型# SkyClaw-v1.0# 昆仑万维5个月前2640
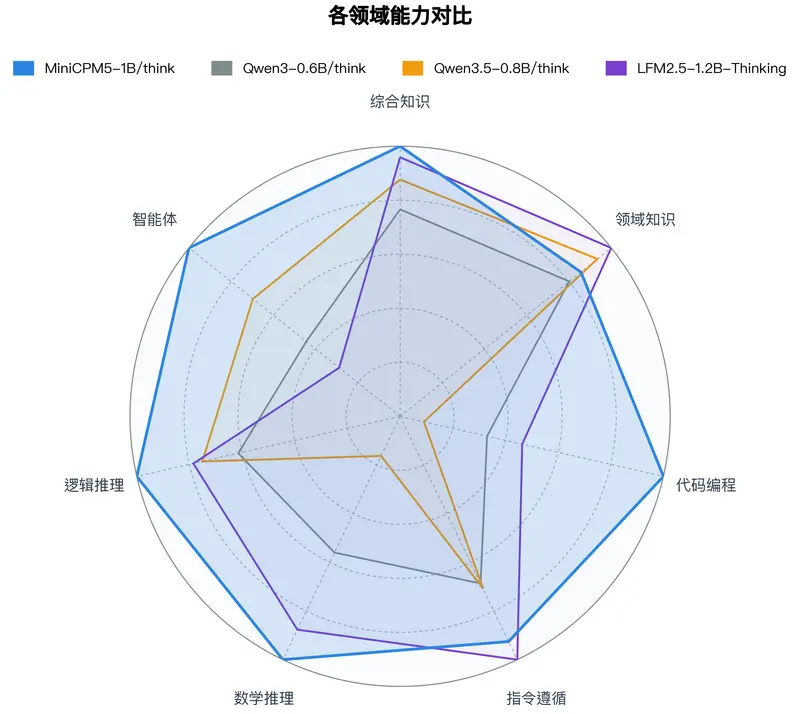
面壁智能发布 MiniCPM5-1B:1B 参数端侧 SOTA 模型,支持混合推理与 128K 长上下文,代码/工具调用能力显著增强面壁智能正式发布了 MiniCPM5-1B,这是 MiniCPM5 系列的首个成员,也是目前 1B 参数量级开源模型中的状态最佳(SOTA)。专为设备端、本地部署及资源受限场景设计,它在保持极小体积的...大语言模型# MiniCPM5-1B# 面壁智能5个月前3380
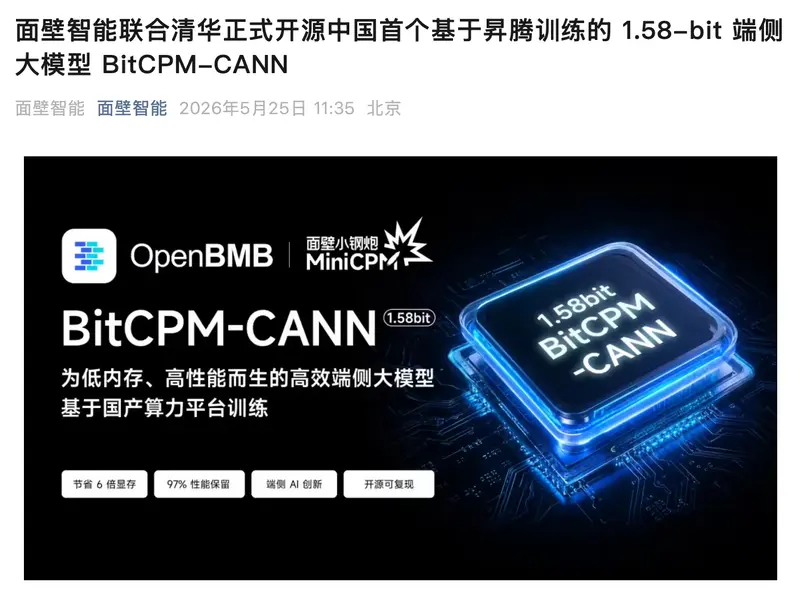
中国首个昇腾原生三值大模型开源:BitCPM-CANN 实现 1.58-bit 端到端训练,8B 模型可跑通旗舰手机在国产算力与大模型高效部署的交汇点上,一项里程碑式的成果正式诞生。面壁智能联合清华大学及 OpenBMB 开源社区,正式发布并开源了 BitCPM-CANN —— 中国首个完全基于**华为昇腾(Asc...大语言模型# BitCPM-CANN# 昇腾5个月前2270
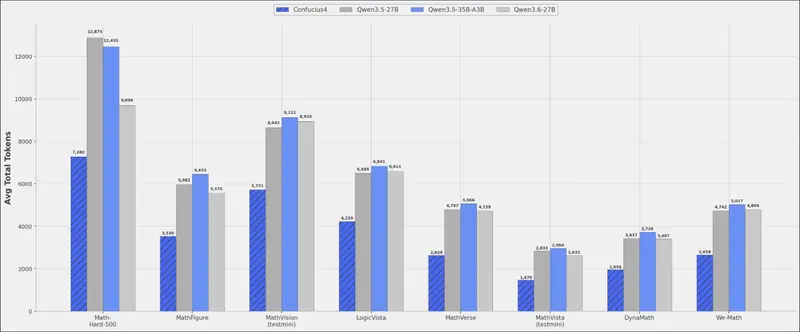
网易有道开源 Confucius4:基于 Qwen3.5-27B,SFT-RL 迭代优化实现多模态数学推理 SOTA网易有道 AI 团队正式开源 Confucius4,这是一款基于 Qwen3.5-27B 架构开发的多模态大语言模型,专为复杂的数学推理任务设计。通过创新的 SFT-RL 迭代训练框架 与 紧凑思维链...大语言模型# Confucius4# Qwen3.5-27B# 网易有道5个月前2040
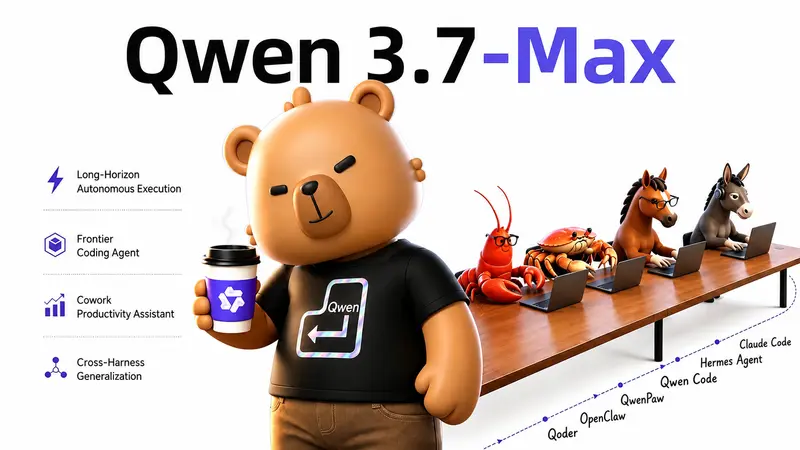
阿里发布 Qwen3.7-Max:35小时自主优化GPU内核,千步工具调用零失误的新一代智能体旗舰阿里巴巴正式推出 Qwen3.7-Max,这是面向智能体(Agent)时代的新一代旗舰模型。不同于传统大语言模型仅专注于对话或单次任务生成,Qwen3.7-Max 致力于成为全能的智能体基座,具备在跨...大语言模型# Qwen3.7-Max5个月前2410
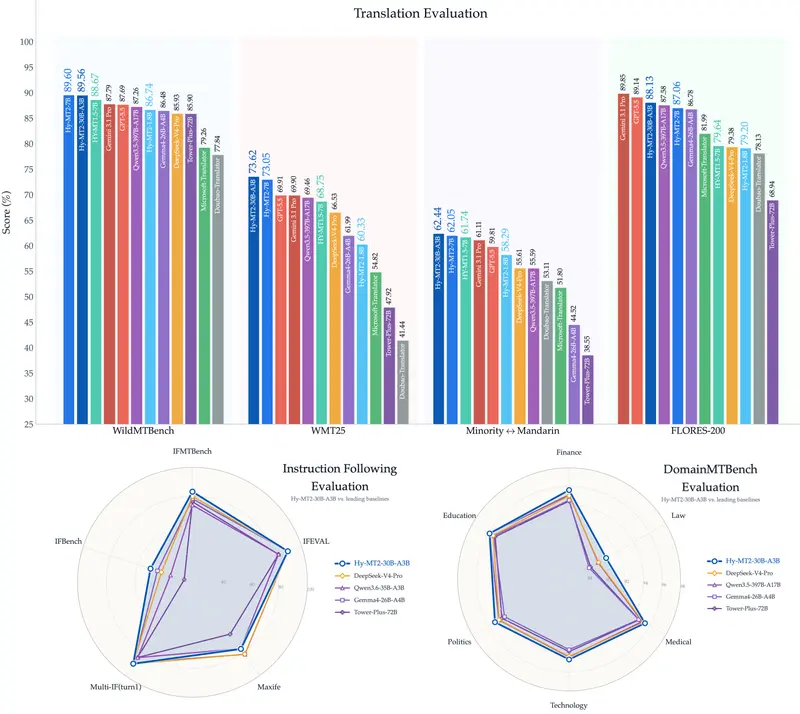
腾讯混元开源 Hy-MT2:支持 33 种语言的“快思”翻译模型,1.8B 版本仅需 440MB 即可端侧部署腾讯混元团队正式推出 Hy-MT2,这是一系列专为复杂现实场景设计的“快思”(Fast-Thinking)多语言翻译模型。该系列包含 1.8B、7B 和 30B-A3B(MoE) 三种规模,支持 33...大语言模型# Hy-MT2# 多语言翻译模型# 腾讯混元5个月前3590
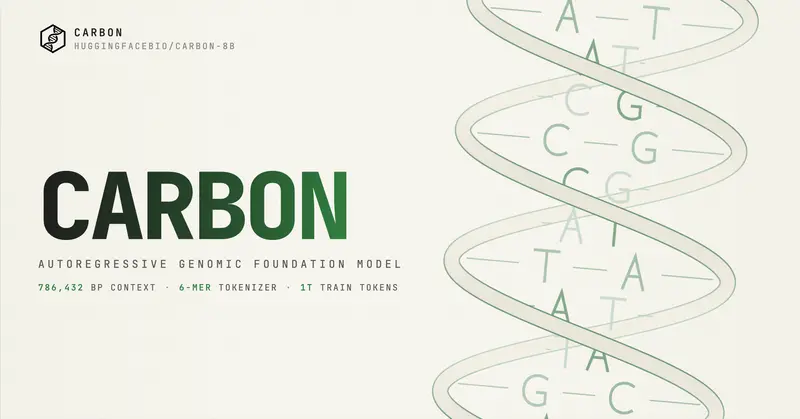
Hugging Face 发布 CARBON:3B 参数媲美 Evo2-7B,推理速度提升百倍的高效 DNA 大模型由 Hugging Face、中关村学院、意大利基因研究所等机构联合研发的 CARBON 系列模型正式亮相。这是一套专为基因组序列设计的高效生成式 DNA 大模型,包含 3B 和 8B 两个版本。 G...大语言模型# CARBON# DNA 大模型# Hugging Face5个月前3990