Liquid AI 正式为其 LFM2.5 系列模型(包括 1.2B、2.6B 和 8B-A1B)发布了 DSpark draft 模型。这是一种基于推测解码(Speculative Decoding)技术的创新方案,通过引入一个仅约 3 亿参数的轻量级“草稿”模型,在不改变最终输出质量的前提下,显著提升了大语言模型的推理速度。在 NVIDIA H100 上,解码速度最高提升 3.18 倍;在 Apple M4 Max MacBook Pro 上,最高提升 2.87 倍。
- 模型:https://huggingface.co/LiquidAI/LFM2.5-8B-A1B-DSpark
核心技术:DSpark 架构
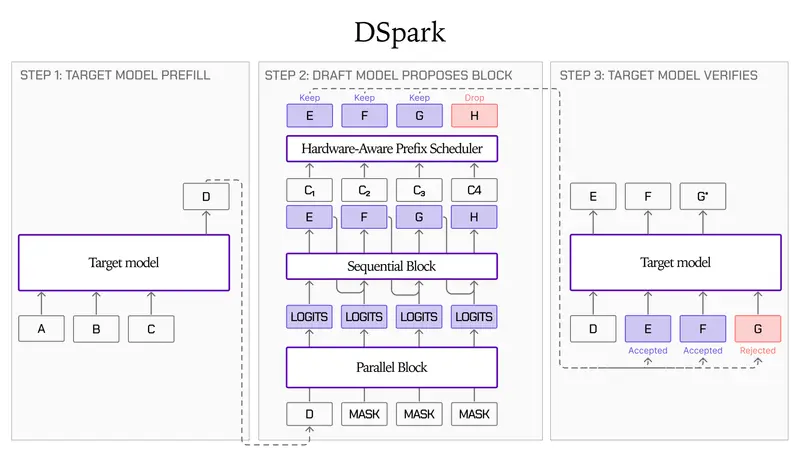
DSpark 并非简单的模型蒸馏,而是一套精心设计的推测解码系统,由三个关键部分组成:
- DFlash 风格并行骨干网:
- 以目标模型的上下文特征为条件,在单次前向传播中同时生成包含 9 个候选 Token 的块(Block)。
- Draft 模型本身仅有 5 个全注意力层,隐藏层大小为 2048,参数量控制在 3 亿左右。
- 轻量级顺序头(Sequential Head):
- 建模为相邻 Token 之间 Rank 为 256 的马尔可夫链。
- 用于恢复 Token 间的依赖性,显著提高块中后部 Token 的接受率。
- 置信度调度验证器:
- 预测每个 Token 的存活概率。
- 当验证成本高于节省的成本时,自动修剪低置信度的后缀,确保效率最大化。
注:Draft 模型不附带独立的词汇权重,而是直接绑定目标模型的嵌入层和 LM 头,进一步减少了内存占用。
性能表现实测
加速效果高度依赖于任务的可预测性(即 Acceptance Rate,接受率)。以下是 Liquid AI 报告的基准测试数据:
| 目标模型 | H100 平均加速 | H100 最佳加速 (MATH500) | M4 Max 平均加速 | M4 Max 最佳加速 (HumanEval) |
|---|---|---|---|---|
| LFM2.5-1.2B-Instruct | 2.10x | 2.56x | 2.54x | 2.87x |
| LFM2.5-2.6B | 2.67x | 3.06x | 2.27x | 2.63x |
| LFM2.5-8B-A1B | 2.54x | 3.18x | 1.18x | 1.44x |
- 高可预测任务:如数学推理(MATH500),LFM2.5-8B-A1B 在 H100 上每步能接受 8.27/10 个 Token,带来极致加速。
- 低可预测任务:如复杂对话(MT-Bench),接受率下降,加速比随之降低(H100 上降至 1.66x)。
- Apple Silicon 瓶颈:由于
llama.cppMetal 后端对 MoE(混合专家)模型的支持尚不完善,验证多个 Token 会激活更多专家,导致权重流量增加,因此 LFM2.5-8B-A1B 在 M4 Max 上的平均加速仅为 1.18x。
部署与集成
- 支持框架:首发支持 SGLang 和 llama.cpp。
- 模型格式:提供 Safetensors 和 GGUF 格式。
- 内存开销:以 LFM2.5-2.6B 为例,BF16 格式的 Draft 模型仅增加约 655 MB 显存/内存。
- 许可证限制:采用 LFM 开放许可证 v1.0。年收入低于 1000 万美元 的企业可免费商业使用;大型企业需联系 Liquid AI 获取商业授权。
SGLang 启动示例
python -m sglang.launch_server \
  --model-path LiquidAI/LFM2.5-2.6B \
  --speculative-algorithm DSPARK \
  --speculative-draft-model-path LiquidAI/LFM2.5-2.6B-DSpark \
  --speculative-draft-attention-backend flashinfer \
  --disable-radix-cache --mem-fraction-static 0.75 --port 30000
最佳应用场景
- AI 代理(Agents)与工具调用:
- 在多轮规划、调用工具、重新规划的循环中,解码延迟是主要瓶颈。
- 实测显示,DSpark 可使 LFM2.5-2.6B 在此类场景下的延迟降低 57%。
- 本地设备端应用:
- 适用于笔记本电脑、机器人或嵌入式系统,尤其是对延迟敏感的单用户聊天或离线副驾驶。
- 数据隐私敏感领域:
- 医疗、金融和国防等需要将数据保留在本地或私有云中的工作负载。
© 版权声明
文章版权归作者所有,未经允许请勿转载。