DeepReinforce 正式发布了 Ornith-1.5,这是一个包含 397B、35B 和 9B 三种规模的开放权重模型家族。与传统的静态预训练模型不同,Ornith-1.5 的核心突破在于其闭环自我改进循环:模型能够自主生成训练任务、构建特定于任务的脚手架(Scaffolding),并生成用于强化学习的解决方案轨迹。这种“自脚手架”机制使得模型能够在没有大量人工标注数据的情况下,持续向能力前沿演进。
- 官方介绍:https://ornith.ai/ornith_1_5.html
- 模型:https://huggingface.co/collections/ornith-ai/ornith-15
DFlash草稿模型现已支持 Ornith-1.5 的 9B、35B-A3B、397B 全部版本。DFlash 与 Ornith 1.5 构成一套草稿推测(speculative decoding)推理组合:DFlash充当草稿模型,一次性预生成一批token;再由Ornith 1.5主模型单轮一次性校验这批草稿token,摒弃传统逐一生成token的模式。
- 模型:https://huggingface.co/collections/ornith-ai/ornith-15-dflash
性能评测结果显示,这套DFlash+Ornith 1.5组合最高可达到2.54倍推理加速,并且文本生成质量不会出现衰减。
核心创新:三阶段自我进化循环
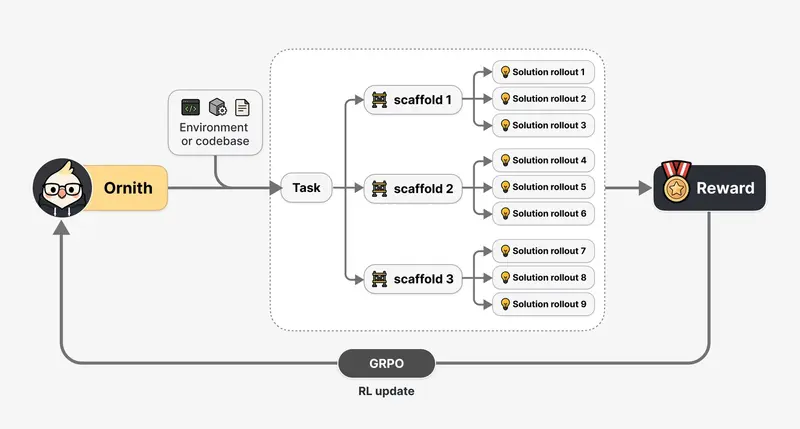
Ornith-1.5 的训练过程不再依赖固定的人类策划任务集,而是通过以下三个阶段的动态交互实现自我优化:
- 任务提出 (Task Proposal):
- 基于当前环境和已解决的问题历史,模型自主提出逐步变难的新任务。
- 系统以 0.2 的经验成功率为目标难度前沿,确保任务既具有挑战性又不至于完全不可解。一旦模型能可靠解决某类任务,其生成价值即降低,从而驱动模型不断探索新领域。
- 脚手架生成 (Scaffolding Generation):
- 为每个提出的任务生成特定的指令、工具调用策略、分解逻辑及编排流程。
- 脚手架被视为与策略共同演化的可学习对象,而非硬编码的规则。
- 轨迹生成与奖励反向传播 (Trajectory & Reward Backpropagation):
- 生成解决问题的完整执行轨迹。
- 奖励信号同时反向传播至上述三个阶段,使模型同时学会编写更好的解决方案、设计更有效的训练任务以及构建更可靠的评估 Harness。
- 硬门控机制:只有格式正确且可验证的任务才能获得奖励,无效任务收益归零,有效防止了“奖励破解”(Reward Hacking)。所有阶段均使用 GRPO (Group Relative Policy Optimization) 进行优化。
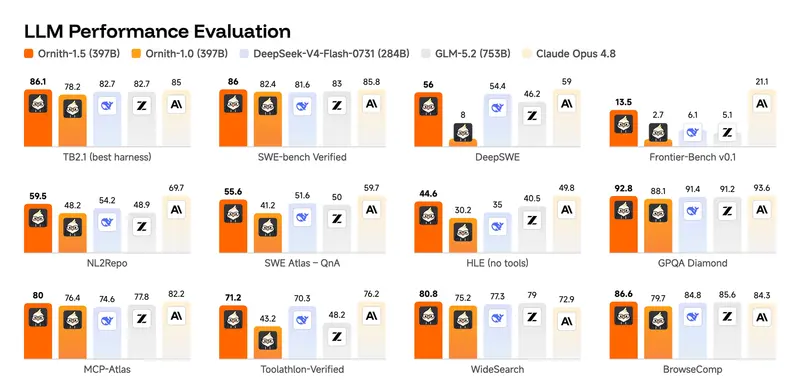
模型规格与性能表现
Ornith-1.5 提供了从移动端到旗舰级的全尺寸覆盖:
| 模型版本 | 架构类型 | 关键特性 | Terminal-Bench 2.1 | SWE-Bench Verified / DeepSWE | GPQA Diamond | BrowseComp |
|---|---|---|---|---|---|---|
| Ornith-1.5-397B | MoE (混合专家) | 旗舰模型,全能型选手 | 85.1 | 56.0 (DeepSWE) | 92.8 | 86.6 |
| Ornith-1.5-35B | MoE | 每 Token 激活仅 3B 参数,极高效率 | 68.5 | 79.0 | – | – |
| Ornith-1.5-9B | Dense (稠密) | 附带 iPhone/Android 量化 Mobile 构建 | 47.0 | 70.6 | – | – |
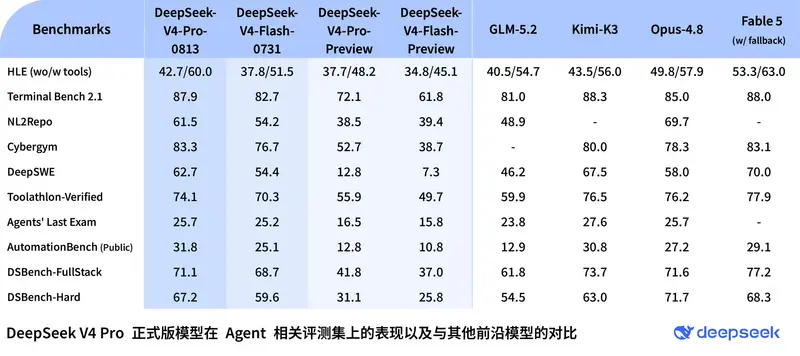
- 旗舰级竞争力:397B 模型在 Terminal-Bench 和 DeepSWE 上的表现与 Claude Opus 4.8 (85.0 / 59.0) 相当,并在同规模下领先于 GLM-5.2 和 DeepSeek-V4-Flash。
- 高效能比:35B MoE 模型在仅激活 3B 参数的情况下,实现了超越许多更大稠密模型的性能。
- 移动端友好:9B 稠密模型在 SWE-Bench Verified 上得分 70.6,优于 Gemma 4-31B 和 Qwen 3.6-35B,并提供了针对移动设备的量化版本。
技术背景与开源协议
- 继承与发展:Ornith-1.5 建立在 2026 年 6 月发布的 Ornith-1.0 基础之上,后者首次引入了将脚手架作为可学习对象的理念。新版本将这一概念扩展为完整的自我进化循环。
- 防御奖励破解:DeepReinforce 团队此前在 CUDA-L1 和 IterX 代理循环研究中就关注奖励破解问题。Ornith-1.5 通过在任务生成阶段引入“可验证性”硬门控,从源头上减少了模型通过作弊获取高奖励的可能。
- 开源许可:Ornith-1.5 权重已在 Hugging Face 上发布,遵循 MIT 许可证,允许广泛的商业和非商业用途。
适用场景
- 复杂代理工作流:397B 模型适合处理需要深度推理、多步规划和复杂工具调用的企业级代理任务。
- 高效代码生成与维护:35B 模型凭借其极高的激活效率,适合部署在成本敏感但需要高质量代码生成的场景中。
- 端侧智能应用:9B 模型及其 Mobile 构建使其成为在 iPhone 和 Android 设备上运行本地编码助手或推理代理的理想选择。
© 版权声明
文章版权归作者所有,未经允许请勿转载。