VeriLoop E2由清华大学深圳国际研究生院机器人实验室Libo Wang开发,是基于Qwen3.8-27B基座二次后训练的开源27B大模型,聚焦代码、数学、物理三大硬核领域。模型核心创新为VeriLoop-Governed Recurrence(VGR,证据收敛受控递归)推理机制:递归生成候选推理状态,交由外部模块校验,只有证据状态得到有效提升、没有出现退化时,才保留当前推理结果。
- 模型:https://modelscope.cn/models/tsinghua-sigs-robot-lab/VeriLoop-E2
这套架构把生成能力和验证能力做了解耦。VeriLoop E2负责生成推理方案、抽象问题、诊断错误、修复假设,产出结构化推理链路;VeriLoop Harness模块承担证据接收、确定性校验、外部验证、结果提交或回滚、推理终止判断、证据状态持久化工作。模型本身不会自主判断推理是否正确,依靠独立的校验机制保证可靠性。
本次开源包包含模型权重、公开推理样例、评估记录,以及Harness功能说明。生产环境可用的Harness完整实现代码并未上传至仓库。
模型基础信息
| 属性 | 详情 |
|---|---|
| 模型名称 | VeriLoop E2 |
| 基座模型 | Qwen3.8-27B |
| 参数规模 | 27B |
| HuggingFace架构 | Qwen3_5ForConditionalGeneration |
| 训练类型 | 后训练(Post-Training) |
| 核心应用领域 | 代码、软件工程、数学、物理科学推理 |
| 后训练语料记录 | 1,841,831条 |
| 原生上下文长度 | 262,144 tokens |
| vLLM验证服务上下文 | 131,072 tokens |
| 分词器 | Qwen2Tokenizer |
| 权重格式 | safetensors |
| 支持语言 | 中文、英文 |
| 推荐部署引擎 | vLLM 0.17.0 |
| 开源协议 | Apache License 2.0 |
| 发布年份 | 2026 |
后训练混合数据集包含仓库级软件工程任务、终端工具调用、数学推理、科学推理、验证导向修复,以及面向递归推理的专项数据。数据集构建、过滤与训练细节收录在配套技术报告。
基准测试成绩
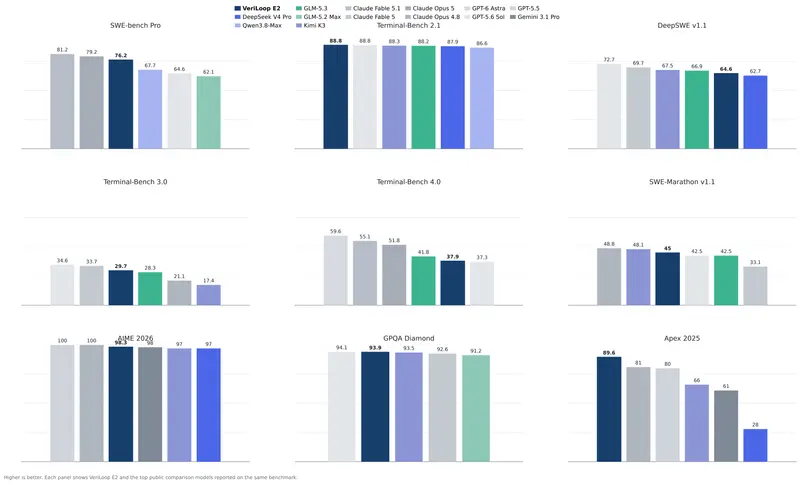
模型在9项代码智能体、数学与科学基准测试取得优异结果,评估采用冻结检查点与固定评估流程,任务会联动VeriLoop Harness、基准配套工具与官方评估器。完整任务输出、评估凭证单独打包在Evaluation Evidence评估证据包内。
| 基准测试 | 得分 |
|---|---|
| SWE-bench Pro | 76.2% |
| Terminal-Bench 2.1 | 88.8% |
| AIME 2026 | 98.3% |
| GPQA Diamond | 93.9% |
| Apex 2025 | 89.6% |
项目还放出两份公开科学推理演示案例与对应的证据材料:一份是有限维黎曼ζ零点比例严格证明;另一份是渐近引力子断层成像研究,为自由渐近辐射引力子构建定量完备性理论框架。
部署层面,模型依托vLLM 0.17.0可提供兼容OpenAI接口的推理服务,已经验证131072 token上下文稳定运行。
归属边界说明
公布的基准分数,是整套E2系统(模型+Harness)在指定评估环境下测出的结果。不能等同于原生Qwen3.8-27B基座成绩;单独加载模型权重、脱离配套评估环境,也无法直接复现该套指标。
要点小结
- VeriLoop E2是清华深圳国际研究生院推出的27B开源模型,基于Qwen3.8-27B后训练,主打数学、物理、代码推理,采用VGR证据收敛递归机制。
- 架构分离生成模块与外部验证模块,避免模型自证推理正确性,原生支持262K上下文,Apache2.0协议开源。
- 在SWE-bench Pro、AIME、GPQA等硬核基准表现突出,附带黎曼ζ函数、引力子成像两份高阶科学推理案例。
- vLLM部署支持OpenAI兼容接口,但是生产版Harness代码未开源;基准成绩为整套系统评估结果,单独加载权重无法复现。
© 版权声明
文章版权归作者所有,未经允许请勿转载。