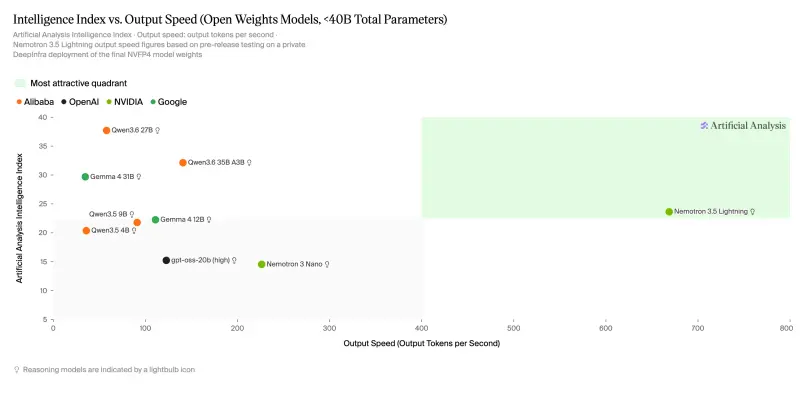
在 AI 代理(Agent)从“单次对话”走向“长时间自主执行”的今天,速度与成本成为了新的瓶颈。英伟达今日正式推出 Nemotron 3.5 Lightning,这是一个开放的 30B 混合专家(MoE)模型,拥有仅 3B 的激活参数。它专为始终在线的代理工作流设计,旨在以极高的吞吐量完成专业化任务,其输出速度可达同尺寸模型的 4 倍。
- 模型:https://huggingface.co/collections/nvidia/nvidia-nemotron-v3
核心亮点:速度、精度与定制化的平衡
1. 极致的高效执行
Nemotron 3.5 Lightning 并非追求通用聊天能力的“全能选手”,而是代理工作流中的“执行专家”。
- MoE 架构优势:通过路由器将每个 Token 仅发送给少数几个专家,使得模型在保持 30B 总参数容量的同时,每次计算仅激活 3B 参数。这带来了小型模型的计算成本和大模型的智能容量。
- 性能实测:在 PinchBench 基准测试中,它在完成 10,000 个任务时达到了 86% 的准确率。在相似准确率下,其速度比 Qwen3.6 35B 快 35%。
2. 为代理 Harness 深度优化
长时间运行的代理大部分时间花在调用工具、验证结果和委派工作上。Lightning 针对这些高频、低延迟的场景进行了专项训练:
- 推测解码(Speculative Decoding):内置多 Token 预测能力,进一步压榨推理速度。
- Harness 适配:针对主流代理框架进行了微调,使其在工具调用和指令遵循上更加精准,减少因错误调用导致的重试延迟。
3. 开箱即用的定制化
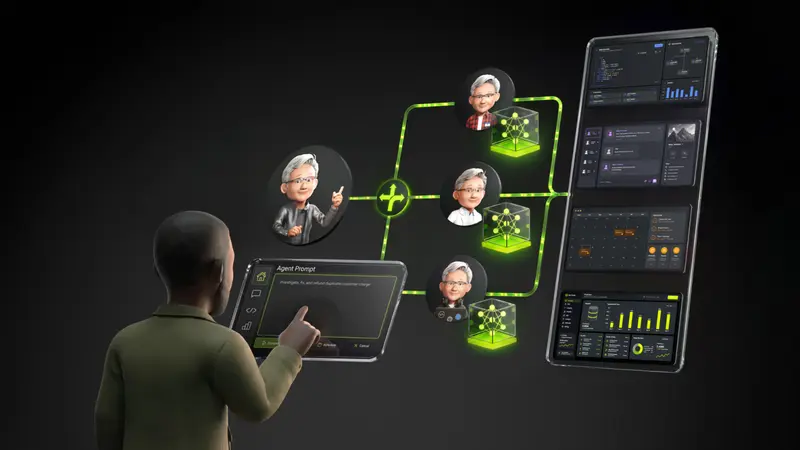
英伟达强调,代理工作流中的每一步不需要相同的模型。Lightning 被设计为易于微调的“专用引擎”:
- 低成本微调:相比超大模型,30B 规模的模型微调更快、更便宜,且对硬件要求更低。
- 宽松许可:权重、训练数据和配方均在 OpenMDW-1.1 许可证下发布,允许开发者使用 NeMo Automodel 进行 LoRA 或全量 SFT 微调,甚至通过 NeMo RL 进行强化学习。
- 领域适配:官方数据显示,经过后训练的 Lightning 在网络安全、编码、法律和能源等专业领域的准确性有显著提升。
生态配套:NVIDIA NeMo Switchyard
为了最大化效率,英伟达同步发布了开源库 NeMo Switchyard。这是一个模型路由工具,允许开发者构建混合模型架构:
- 复杂推理与规划:交给前沿的大参数模型(如 Nemotron 3 Super/Ultra)。
- 高吞吐量执行:交给轻量级的 Nemotron 3.5 Lightning。
这种“大脑+手脚”的组合,既保证了决策的质量,又确保了执行的速度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。