Anthropic 正式发布了其最新旗舰模型 Claude Opus 4.7。作为 Opus 系列的最新迭代,它在高级软件工程、复杂指令遵循以及高分辨率视觉理解方面取得了显著进步,旨在让用户能够更放心地委托最棘手、最长周期的编码任务。
- 官方介绍:https://www.anthropic.com/news/claude-opus-4-7
Opus 4.7 现已通过 Claude API (claude-opus-4-7)、Claude 平台、Amazon Bedrock、Google Cloud Vertex AI 和 Microsoft Foundry 全面可用,定价与 Opus 4.6 保持一致。
核心升级亮点
1. 卓越的软件工程能力
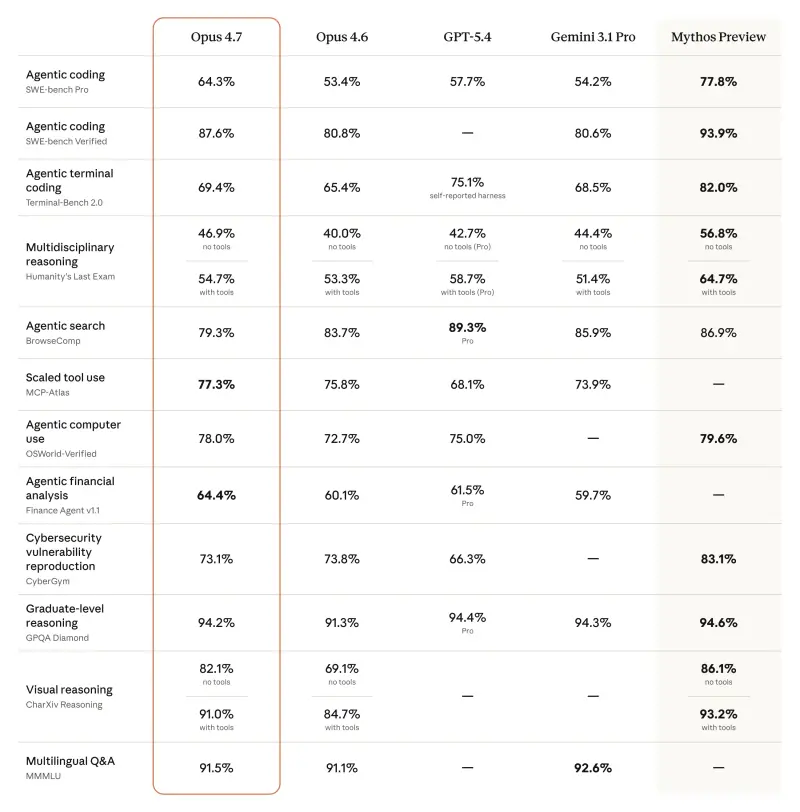
- 复杂任务处理:在高级软件工程基准测试中表现优于 Opus 4.6,尤其擅长处理需要长时间运行、多步骤推理的复杂编码任务。
- 自我验证:模型能够在回复前设计验证自身输出的方法,显著提高了代码的正确性和可靠性。
- 严格指令遵循:Opus 4.7 对指令的执行更加严谨和逐字化。早期测试者反馈,以前模型可能松散解释或跳过部分指令,而 Opus 4.7 会严格执行。注意:用户可能需要调整针对旧模型编写的宽松提示词。
2. 高分辨率视觉理解
- 3倍分辨率提升:支持长边高达 2,576 像素(约 375 万像素)的图像输入,是此前模型的三倍多。
- 精细细节捕捉:这一升级使得模型能够读取密集的屏幕截图、从复杂图表中提取精确数据,以及进行需要像素级参考的多模态任务,为计算机使用代理(Computer Use Agents)打开了新空间。
3. 增强的记忆与金融分析
- 文件系统记忆优化:更擅长利用基于文件系统的长期记忆,能在跨会话工作中记住关键笔记,减少重复上下文输入。
- 金融领域 SOTA:在 GDPval-AA 等评估中达到最先进水平,能生成更严谨的金融模型、专业的演示文稿及紧密集成的跨任务分析。
4. 更精细的努力程度控制
- 新增
xhigh模式:引入了介于high和max之间的 “额外高” (xhigh) 努力程度选项。 - 默认升级:在 Claude Code 中,默认努力程度已提升至
xhigh,以平衡推理深度与响应延迟。建议在编码和代理用例中优先使用high或xhigh。
安全与对齐:Project Glasswing 的首次实践
Opus 4.7 是 Anthropic Project Glasswing 计划下的首个发布模型,旨在测试新的网络安全防护措施:
- 差异化能力限制:与更强大的 Mythos Preview 不同,Opus 4.7 在训练过程中尝试了差异化降低某些网络攻击能力的方法。
- 自动防御机制:内置安全防护措施,能自动检测并阻止表明禁止或高风险网络安全用途的请求。
- 白名单计划:对于合法的网络安全专业人士(如漏洞研究、红队演练),可申请加入新的网络安全验证计划以获得受限访问权限。
- 对齐表现:总体安全性与 Opus 4.6 相似,在抵抗提示注入和诚实度上有所改进,但在某些受控物质建议上略弱。整体评价为“大体上对齐良好且值得信赖”。
配套工具更新
Claude Code 新功能
/ultrareview命令:生成专门的审查会话,深入读取代码更改并标记潜在的 Bug 和设计问题(Pro/Max 用户享有三次免费试用)。- 自动模式扩展:Max 用户现在可以使用“自动模式”,允许 Claude 代表用户做出低风险决策,从而减少中断,实现更长周期的无人值守任务执行。
API 新功能
- 任务预算 (Task Budgets):公开测试版推出,允许开发者引导 Token 支出,确保模型在长周期运行中优先处理核心工作,防止预算失控。
迁移指南:从 Opus 4.6 到 4.7
虽然 Opus 4.7 是直接升级,但有两个关键变化影响 Token 使用量:
- Tokenizer 变更:采用了更新的 Tokenizer,相同输入可能映射到更多 Token(约为原来的 1.0 – 1.35 倍)。
- 思考深度增加:在
high或xhigh努力程度下,模型会进行更多内部推理,导致输出 Token 数量增加,尤其是在多轮代理交互中。
建议:
- 在实际流量中监控 Token 消耗差异。
- 利用
effort参数、任务预算或提示词简洁性来控制成本。 - 尽管单次 Token 数可能增加,但内部评估显示,由于准确率提升减少了返工,整体解决任务的 Token 效率实际上有所改善。
© 版权声明
文章版权归作者所有,未经允许请勿转载。