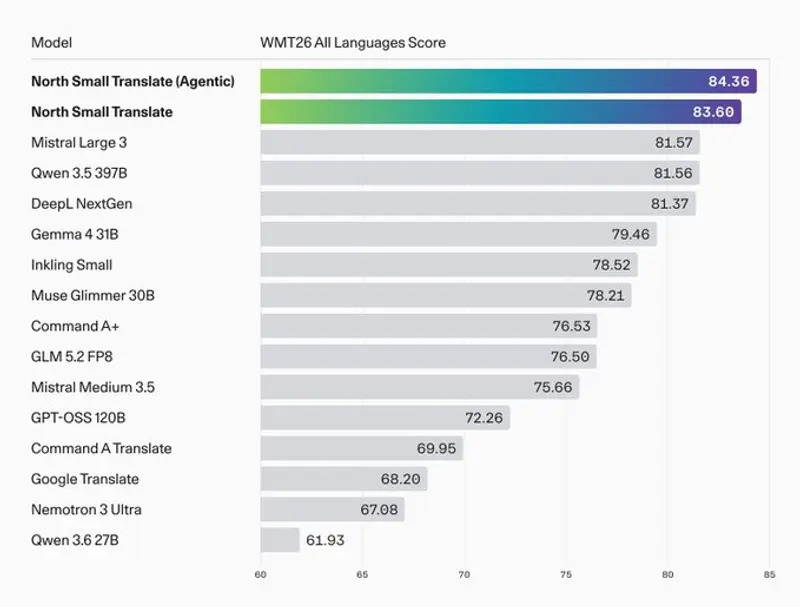
Cohere 正式发布了 North Small Translate,这是其 North 家族中的首款专用机器翻译模型。作为一个拥有 2180 亿总参数(激活参数仅 250 亿)的稀疏混合专家(MoE)模型,它在覆盖 50 种语言的 WMT26 评估中取得了 83.6 的平均分,宣称超越了 DeepL、Google Translate 以及 Qwen 3.5 和 Mistral Large 3 等主流竞品。
- 模型地址:https://huggingface.co/CohereLabs/North-Small-Translate-1.0
架构设计:高效与精度的平衡
North Small Translate 延续了 Cohere 在多语言领域的技术积累,采用了一种高度优化的仅解码器稀疏 MoE 架构:
- 稀疏激活:拥有 128 个专家,每令牌仅激活 8 个专家及一个共享专家。这意味着虽然模型总参数量巨大(218B),但每令牌的计算量仅相当于 25B 模型,内存占用虽大但推理效率极高。
- 混合注意力机制:采用滑动窗口注意力(窗口大小 4096,带 RoPE)与无位置嵌入的全局注意力层以 3:1 的比例交错排列。这种布局首次在 Command A 中引入,旨在兼顾局部细节捕捉与长程依赖理解。
- 上下文窗口:支持 16K 输入和输出令牌,专为纯文本翻译优化。
- 训练策略:在与 RWS(Language Weaver 的开发者)合作下,利用真实世界的高质量双语数据进行了专门的后训练,以确保翻译的自然度与准确性。
性能表现:全面领先
在 Cohere 内部使用 GPT-5.6-Sol 作为评判标准的 WMT26 基准测试中,North Small Translate 展现了强劲的实力:
| 模型 | WMT26 得分 | 备注 |
|---|---|---|
| North Small Translate (代理式) | 84.36 | 多遍工作流,自我纠错 |
| North Small Translate | 83.60 | 标准单次推理 |
| Qwen 3.5 397B A17B | 81.56 | 开源竞品 |
| DeepL NextGen | 81.37 | 商业翻译标杆 |
| Gemma 4 31B (on) | 79.46 | Google 开源模型 |
| Google Translate | 68.20 | 传统商业引擎 |
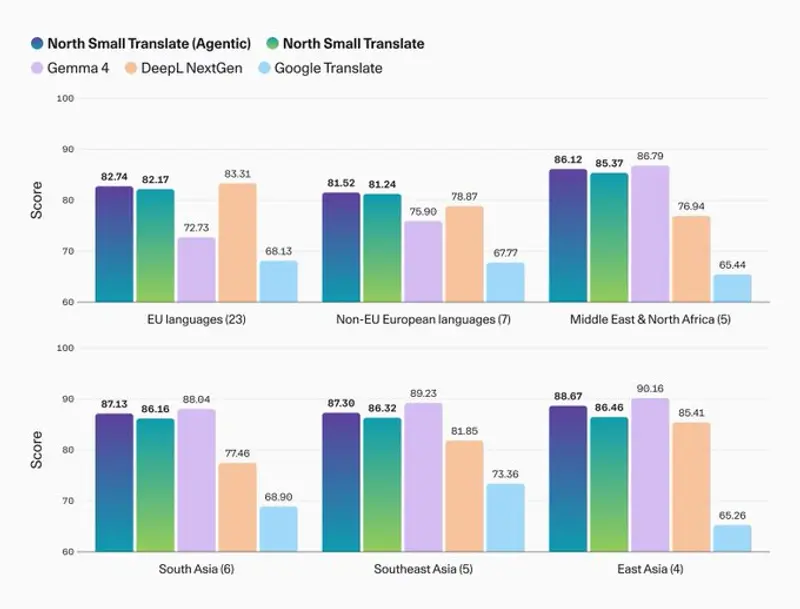
⚠️ 注意:上述分数为供应商自测报告,独立第三方评测结果尚未公布。但在区域细分中,该模型在欧洲语言上显著优于 Gemma 4,在南亚语言上也保持了极高的竞争力。
长文档处理能力
在处理长篇内容时,North Small Translate 优势明显。在一次性翻译两本书章节的任务中,其 xCOMET-XL 得分达到 48.9,远超 Google Translate (21.3) 和 Gemma 4 (19.4),证明了其在保持长文本语境一致性方面的卓越能力。
速度与成本:极具性价比
- 推理速度:在相同硬件低并发下,吞吐量达 112 tokens/s,比 Gemma 4 31B (81 tokens/s) 快约 1.4 倍。
- 成本优势:每任务平均成本仅为 $0.000676(基于 661 令牌)。相比之下,Gemini 3.1 Pro Preview 的成本高出约 58 倍,Qwen 3.5 也高出近 7 倍。
部署与使用
1. API 调用(最快路径)
通过 Cohere Chat V2 API 即可免费试用(受速率限制):
from cohere import ClientV2

co = ClientV2(api_key="<YOUR_API_KEY>")
response = co.chat(
    model="north-small-translate-1-0",
    messages=[{"role": "user",
               "content": "将以下所有内容翻译成法语:\n\n企业需要对业务关键文档进行准确翻译。"}],
)
print(response.message.content[0].text)
2. 自行托管
Cohere 提供了三种精度的检查点,支持非商业性自行托管或商业许可:
| 精度格式 | Blackwell (B200) 需求 | Hopper (H100) 需求 |
|---|---|---|
| BF16 | 4x B200 | 8x H100 |
| FP8 | 2x B200 | 4x H100 |
| NVFP4 W4A16 | 1x B200 | 2x H100 |
亮点:通过 4 位量化(NVFP4),仅需 1 张 B200 或 2 张 H100 即可运行该 218B 模型,极大地降低了私有化部署的门槛。
© 版权声明
文章版权归作者所有,未经允许请勿转载。