打造Devin编程智能体的Cognition推出SWE-2,这是该公司目前能力最强的编程模型。SWE-2以月之暗面2.8T参数的Kimi K3作为基座,通过强化学习完成后训练。根据Cognition测试数据,SWE-2在FrontierCode 1.1 Main基准取得50.0%得分,和Fable 5.1差距不足1分,但推理成本降低64%。它也是Cognition第一款支持可选推理努力等级的模型,全部三个档位在同一次强化学习训练流程中完成。
- 官方介绍:https://cognition.com/blog/swe-2
部署说明:无法自行托管。SWE-2没有开放权重,也不提供独立API,仅集成在Devin内使用;当前支持桌面端与CLI版本,Devin Web和Fusion版本正在陆续上线。
SWE-2 是什么
SWE-2继承SWE-1.7的技术底座与训练方案,前代模型基于Kimi K2.7训练。本次Cognition把强化学习拓展到万亿参数规模,基座参数量接近前代3倍。Cognition表示,在Kimi K3之上做强化学习,依然有可观的能力提升空间,多项基准直接上涨5至6分。
本次核心改进是一套新的强化学习算法,可以一次性训练高、中、低三种推理努力档位。每个档位设置独立的成本惩罚项,让成本-性能帕累托前沿整体同步优化。
基准测试结果
Cognition公布的测试结果如下,公开指标直接采用公开数据,其余模型在原生框架下以最优配置运行。FrontierCode属于Cognition自研基准,竞品得分均来自Cognition侧评估。
| 基准 | SWE-2 | Kimi K3 | Grok 4.6 | Fable 5.1 | GPT-5.6 Sol | GPT-6 Astra | SWE-1.7 |
|---|---|---|---|---|---|---|---|
| FrontierCode 1.1 Main | 50.0% | 44.2% | 48.0% | 50.9% | 47.5% | 53.3% | 42.0% |
| DeepSWE 1.1 | 73.0% | 68.5% | 67.5% | 67.4% | 72.7% | 74.1% | 37.7% |
| Terminal-Bench 2.1 | 92.8% | 88.3% | 88.4% | 91.4% | 88.8% | 89.9% | 81.5% |
| Terminal-Bench 4 | 27.3% | 21.5% | 20.3% | 55.8% | 37.3% | 57.9% | 7.6% |
SWE-2 在 Terminal-Bench 2.1 拿到第一,并且所有基准都优于基座Kimi K3。Cognition称,SWE-2距离GPT-6 Astra仅差数分,成本只有后者四分之一。短板体现在Terminal-Bench 4,相比Fable 5.1、GPT-6 Astra落后约30分。
模型行为:减少无效探索,更快动手修改代码
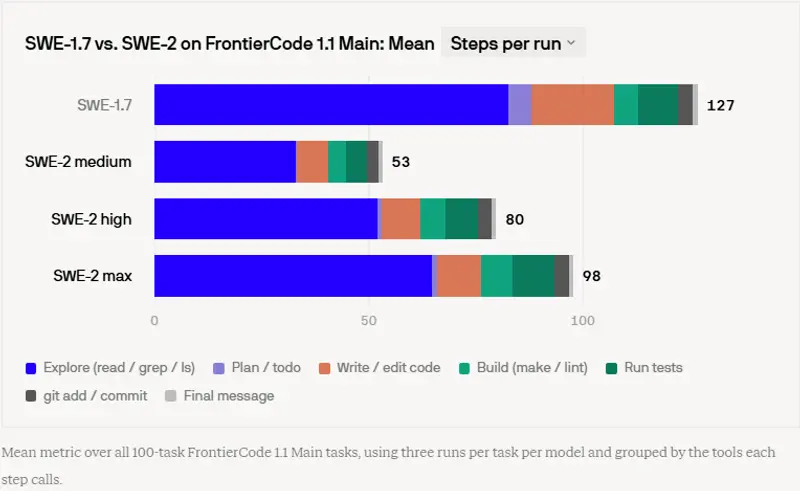
SWE-1.7在简单任务容易过度探索、反复试错。SWE-2引入聚焦探索机制改善这个问题。FrontierCode测试中,SWE-2 medium档位得分高于SWE-1.7,交互轮次减少58%,推理成本下降81%。
单次任务平均执行步骤:SWE-1.7为127步;SWE-2 medium 53步,high 80步,max 98步。
SWE-2 medium 中位数仅18步就会发起第一次真实代码编辑,而SWE-1.7需要48步。
团队总结三个行为特点:更强的端到端测试覆盖、工具调用受阻时具备灵活应变能力、严谨的结果校验习惯。遇到难题时会重新推导结论,而不是单纯重复自己的原有判断。
训练技术细节
帕累托信息成本惩罚:奖励公式 R = S − λ × C。S代表任务是否成功,C融合美元推理成本与rollout执行时长。Cognition证明线性惩罚可以让强化学习目标仅依赖任务成功率与平均成本。每个推理档位的λ取值,匹配基座模型帕累托曲线的局部斜率,让奖励的等值线和前沿相切,训练只能向着提升帕累托前沿的方向优化。
长度加权奖励基线:自SWE-1.6沿用至今。rollout长度会影响梯度幅值,基线按照token长度加权计算:sum(R × L) / sum(L)。消融实验显示,该方案维持较低的训练推理KL散度,在不增加算力开销的前提下稳定训练过程。
Rollout服务与加速方案:预填充延迟批处理临近请求,单GPU TPM与单请求TPS提升10%~20%。DSpark推测解码加速rollout;草稿模型经过SpecForge重训练,接受序列长度提升15%,再和策略模型联合在线训练。搭配NVFP4、FP8内核与量化感知训练,控制内存占用,把训练推理不一致程度控制在低于SWE-1.7的水平。
数据:强化学习环境规模扩充三倍,增加指令遵循相关样本;搭建数据飞轮,利用早期SWE-2检查点修复验证器的假阳性、假阴性问题。
可信度测试
Cognition复用其开源可信度研究里两组评估。针对145条中国相关政治敏感问题,SWE-2整体通过率98.0%:英文99.8%,简体中文95.2%,繁体中文99.1%。跨不同客户端框架的上下文漏洞测试中,没有框架会给模型带来统计显著的结果偏移。
© 版权声明
文章版权归作者所有,未经允许请勿转载。