在 AI 编程助手日益普及的今天,大多数模型仍停留在“代码片段生成”阶段,难以应对复杂的软件工程任务。Poolside 公司发布的 Laguna 系列模型(包括 Laguna M.1 和 Laguna XS.2),旨在让 AI 从“会写代码”进化为“会搞工程”的数字工程师。其中,Laguna XS.2 以其紧凑的架构和本地就绪特性,成为代理型编码领域的佼佼者。
- 官方介绍:https://poolside.ai/blog/laguna-a-deeper-dive
- 模型:https://huggingface.co/collections/poolside/laguna-xs2
Laguna XS.2:本地就绪的高效代理模型
Laguna XS.2 是一个总参数 330 亿 的混合专家(MoE)模型,每个 token 仅激活 30 亿 参数。这种设计使其在保持强大能力的同时,极大降低了推理成本,甚至能在 36GB 内存的 Mac 上流畅运行。
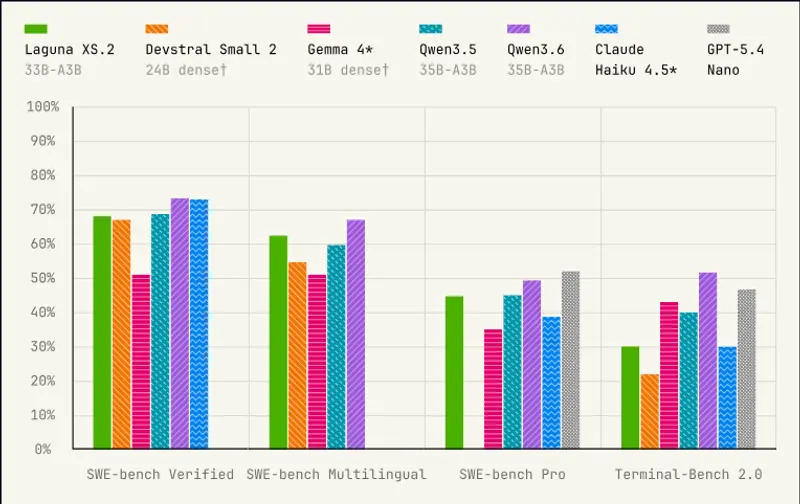
核心亮点:
- 🏗️ 混合注意力架构:40 层中,30 层采用滑动窗口注意力(SWA),10 层采用全局注意力。通过逐头门控以 3:1 比例混合,兼顾局部细节处理与长程依赖捕捉。
- 💾 高效显存管理:KV 缓存量化为 FP8,显著降低内存占用,支持长达 262,144 token 的上下文窗口。
- 🧠 原生推理支持:支持工具调用间的交错思考(Thinking),用户可灵活启用或禁用思考模式,提升复杂任务的处理能力。
- 📜 Apache 2.0 许可:完全开源,允许自由商业使用与修改。
核心能力:像软件工程师一样工作
Laguna 系列不仅仅是代码生成器,更是具备完整工程能力的智能体:
- 代码库理解与操作:能浏览整个仓库,理解文件关系,精准定位修改点。
- 工具链集成:熟练调用 Shell 命令、测试框架、搜索工具等,自主完成端到端任务。
- 长程推理与规划:面对涉及数百步的 Bug 修复任务,能制定计划、执行并根据反馈动态调整,保持上下文不丢失。
- 多语言与终端操作:支持 Python、JS、Java、C++、Rust 等主流语言,并具备直接在命令行环境中执行脚本和管理配置的能力。
研发革新:从“手工作坊”到“模型工厂”
Poolside 并未将模型开发视为依赖灵感的艺术创作,而是建立了一套工业化的 Model Factory 流程,使得 XS.2 从立项到发布仅耗时 五周。
1. 🥣 AutoMixer:自动优化数据“食谱”
训练大模型如同培养孩子,数据配比至关重要。AutoMixer 通过训练约 60 个小模型进行实验,利用机器学习预测不同数据配比对最终能力的影响,自动找出最优配方。
- XS.2 最终配方:代码 30.6%、网页 25.2%、合成代码文本 25.4%、数学 9%、知识 6.6%。
2. 🐝 Hive:AI 自产高质量合成数据
为解决高质量数据稀缺问题,Poolside 构建了 Hive 系统,让 AI 智能体自动生成训练数据。例如,将真实的 Git Commit 转化为“请修复此 Bug”的练习题。这些数据量大、质量可控且答案可验证。
3. ⚔️ 强化学习:真实环境中的“实战演练”
在后训练阶段,模型在真实的代码仓库和终端环境中进行强化学习。每执行一步操作(如改代码、跑测试)都会获得精细化的奖励或惩罚。通过 Atlas 推理系统,模型在“战斗中学习”,真正掌握了端到端的软件工程技能。
性能表现:智能体任务领先
Laguna 在多项基准测试中展现了强劲实力,尤其在智能体任务上表现突出:
| 基准测试 | Laguna XS.2 | Laguna M.1 | 对比参考 |
|---|---|---|---|
| SWE-bench Verified (GitHub Issue 修复) | 69.9% | 74.6% | Qwen3.6 (73.4%), Claude Haiku 4.5 (73.3%) |
| Terminal-Bench 2.0 (终端任务) | 35.7% | 45.8% | Devstral Small 2 (22.5%), Claude Haiku 4.5 (29.8%) |
| LiveCodeBench (代码生成) | 29.3% | – | 优于同规模 Qwen3.5 |
| MultiPL-E (多语言代码) | 58.4% | – | 同规模领先 |
注:Poolside 修复了多个基准测试中的“作弊漏洞”(如利用 Git 历史偷看答案),确保 Laguna 的成绩真实可靠。
© 版权声明
文章版权归作者所有,未经允许请勿转载。