在生成式 AI 快速落地的今天,内容审核(Content Moderation)面临着巨大的挑战:不同的产品、受众和场景对“安全”的定义截然不同。网络安全工具可能允许的攻击性代码,在心理健康平台上却是有害内容。传统的护栏模型通常内置固定的危害分类体系,一旦部署场景变化,往往需要昂贵的重新训练。
- 官方说明:https://mistral.ai/news/shieldstral/
- 模型:https://huggingface.co/mistralai/Shieldstral-1.0-3B
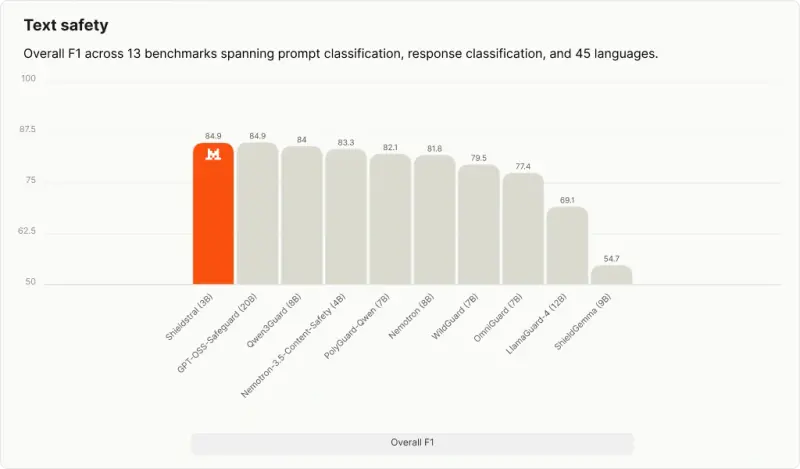
Mistral AI 今日正式开源了 Shieldstral,一个基于 Apache 2.0 许可证的 30 亿参数多模态安全分类器。它通过一种创新的“策略自适应”方法,将审核标准从模型权重中解耦,移至推理时的自然语言提示中。这意味着开发者无需重新训练,即可通过简单的文本指令动态调整审核策略,且其性能可媲美高达其 7 倍规模的开源护栏模型。
核心理念:将审核视为二元问答任务
Shieldstral 摒弃了传统的多标签分类范式,转而采用一种极简的二元问答框架。每个审核请求包含三个部分:
<Instruct>:定义评估上下文、严格程度以及不安全内容的具体定义(即策略)。<Query>:一个明确的是非问句,例如“此内容是否宣扬身体暴力?”<Document>:待评判的内容,可以是纯文本、纯图像或图文混合。
模型仅需输出 yes 和 no 的 logits,并通过 softmax 归一化为一个连续的安全分数。这种设计不仅统一了提示词分类、响应审核、拒绝检测和毒性检测,更让策略完全由用户掌控,实现了真正的“即插即用”。
技术亮点:小模型如何击败大模型?
Shieldstral 的成功证明了“数据质量优于模型规模”的原则。其背后的训练哲学包括:
- 统一异构数据:通过标准化处理器,将公开安全数据集中差异巨大的分类体系(从二元标记到细粒度多标签)转换为统一的指令-查询-文档格式,并校准不同来源的严格程度,使模型学会泛化而非过拟合。
- 教会区分,而非记忆:通过构建刻意相似、容易混淆的策略对比对,训练模型识别细微的策略边界。这种能力使其能够迁移到推理时未见过的、用户自定义的新策略上。
- 多模态基础构建:针对视觉安全数据稀缺的问题,利用通用图像数据集作为高质量负样本,并通过视觉-语言重排序器过滤错误标记,显著提升了图像审核的鲁棒性。
- 检查点融合:使用 LoRA 微调并通过 SLERP 合并三个互补的检查点(公开数据校准、细粒度策略区分、基础指令模型),在保持通用策略校准的同时,恢复了强大的指令遵循能力。
性能与基准测试
尽管仅有 30 亿参数,Shieldstral 在多项基准测试中表现卓越:
| 维度 | 表现 |
|---|---|
| 文本安全 | 媲美或超越 7 倍规模的开源护栏模型。 |
| 多模态审核 | 树立了新的行业标杆,尤其在图文混合内容处理上。 |
| 策略适应性 | 在未见过的自定义策略下,依然保持高精度的判别能力。 |
| 运行效率 | 可在单张 16GB GPU 上流畅运行,支持实时低延迟审核。 |
开放与灵活:Apache 2.0 许可证
作为 Open Secure AI Alliance 的创始成员,Mistral AI 以 Apache 2.0 许可证开放了 Shieldstral 的权重。这为开发者和企业提供了极大的自由度:
- 多语言支持:覆盖英语、中文、日语、韩语、阿拉伯语等 12 种主流语言。
- 长上下文:支持高达 32k 令牌的序列长度,适合处理长文档或复杂对话历史。
- 连续分数:返回校准后的概率值,允许开发者根据业务需求灵活设置阈值,或按置信度排序进行人工复审。
应用场景
Shieldstral 非常适合资源受限或对实时性要求极高的边缘设备审核场景:
- 用户提示词审核:在进入模型前拦截恶意注入或违规指令。
- 模型响应审核:确保生成的输出符合品牌安全和合规要求。
- 拒绝分类:智能识别模型何时应拒绝回答,以及拒绝的理由是否恰当。
- 动态策略调整:针对不同地区、不同年龄段用户实时切换审核严格度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。