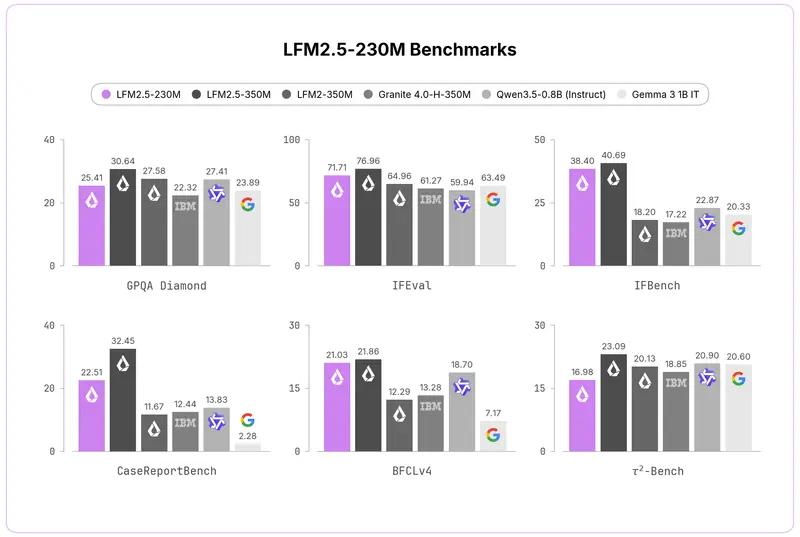
在大型语言模型(LLM)竞相追求万亿参数的今天,Liquid AI 选择了一条截然不同的道路。该公司今日发布了其迄今最小的模型 LFM2.5-230M,一个仅拥有 2.3 亿参数的基础模型。尽管体量微小,但它在数据提取和工具调用任务上击败了参数量是其 4 倍的竞争对手(如 Qwen3.5-0.8B 和 Gemma 3 1B),并能在智能手机、笔记本电脑甚至树莓派等边缘设备上流畅运行。
- 官方介绍:https://www.liquid.ai/blog/lfm2-5-230m
- 模型:https://huggingface.co/LiquidAI/LFM2.5-230M
核心突破:非 Transformer 架构的效率胜利
LFM2.5-230M 的核心优势源于其独特的 LFM2 架构。它摒弃了传统 Transformer 中计算密集的纯注意力机制,转而采用一种混合系统:
- 门控短程卷积 + 分组查询注意力:这种设计有效避免了二次方内存成本,使得模型在处理长序列时更加高效。
- 超低资源占用:模型内存占用低于 400MB,支持 32K 上下文窗口。
- 极致速度:
- 在 Samsung Galaxy S25 Ultra (Snapdragon Gen4) 上,解码速度高达 213 tokens/秒。
- 在 Raspberry Pi 5 上,仍能保持 42 tokens/秒 的可用速度。
性能表现:小身材,大能量
Liquid AI 明确表示,LFM2.5-230M 并非为复杂的数学推理或创意写作而生,而是专为结构化数据提取和智能体工作流优化。在特定基准测试中,其表现令人瞩目:
| 基准测试 | LFM2.5-230M (230M) | 对比模型 (更大参数) | 结果 |
|---|---|---|---|
| BFCLv3 (工具使用) | 43.26 | IBM Granite 4.0 (350M) Google Gemma 3 1B IT | 超越两者 |
| CaseReportBench (数据提取) | 22.51 | Alibaba Qwen3.5-0.8B | 大幅领先 |
这一结果证明,在垂直领域(如解析发票、格式化地址、路由遥测数据),经过专门优化的微型模型比通用的小型模型更具性价比和效率。
应用场景:从“AI ETL”到人形机器人
1. 企业级“AI ETL”
传统基于规则的 ETL 脚本脆弱且难以维护。LFM2.5-230M 允许企业在本地硬件上部署轻量级提取引擎,自动将非结构化文档转换为 JSON 等格式。由于无需调用昂贵的云端 API,且延迟极低,它成为处理海量常规数据任务的理想选择。
2. 边缘智能体与机器人
Liquid AI 展示了该模型在 Unitree G1 人形机器人上的应用。模型运行在机器人自带的 NVIDIA Jetson Orin 模块上,能够理解自由形式的自然语言指令(如“向前走3米,单膝跪地5秒”),并将其转化为结构化的多步骤技能调用计划。这证明了微型模型在离线、低延迟机器人控制中的巨大潜力。
许可模式:保护创新的“双重用途”策略
LFM2.5-230M 采用 LFM Open License v1.0,这是一种非 OSI 合规的双重用途商业许可:
- 免费使用:年收入低于 1000 万美元 的个人、研究人员及初创公司可免费商用、修改和分发。
- 付费授权:年收入超过 1000 万美元的大型企业需签署单独的商业协议。
这一策略旨在保护 Liquid AI 的知识产权,防止科技巨头无偿吸收其创新成果,同时鼓励基层开发者和中小企业的广泛采用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。