由香港大学、字节跳动 Seed、北京大学和中国人民大学联合研究团队提出的 Cola2 模型,针对层次化语言生成中的核心痛点,提出了一种基于连续语义压缩与平衡离散生成的协同自适应建模方案。该方案将文本动态切分为语义片段,在连续空间中进行语义压缩,并在离散空间中实现语言生成,使两者在训练过程中协同适应。
- 项目主页:https://hongcanguo.github.io/Cola2/zh/
- GitHub:https://github.com/ByteDance-Seed/Cola2
- 模型:https://huggingface.co/ByteDance-Seed/Cola2
核心架构:连续与离散的协同适应机制
层次化语言生成的有效性取决于两个关键工程问题:潜空间应当压缩何种信息,以及离散生成器如何有效利用这些信息。Cola2 通过以下设计解决这一问题:
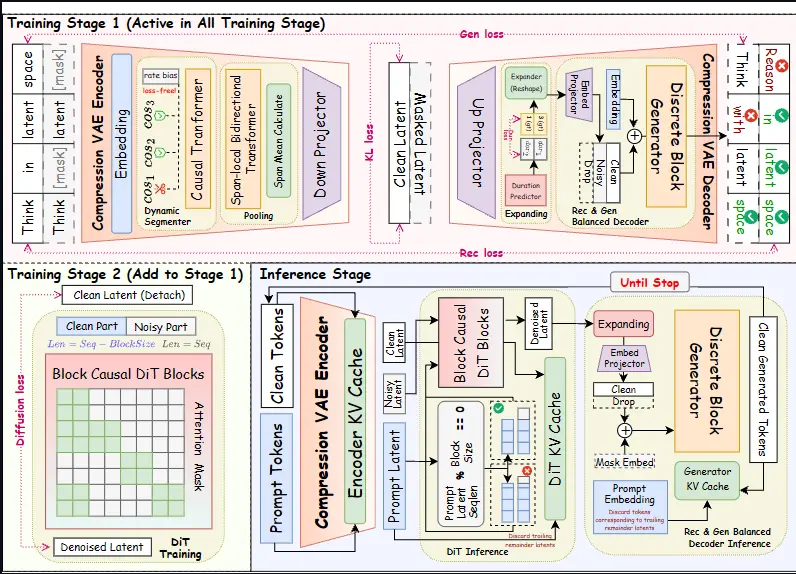
- 动态语义分段与压缩控制:模型将文本动态切分为语义片段,并引入无需辅助损失的负反馈机制。该机制在不干扰表示学习的前提下,精确控制并维持目标平均压缩率。
- 多条件联合训练与平衡调节:块因果掩码扩散模型(MDM)解码器在干净、加噪和丢弃潜变量三种条件下进行联合训练。同时,模型利用无分类器引导(CFG)来动态调节语义重建与自主生成之间的平衡。
- 梯度协同与解耦:在训练阶段,token 预测的梯度会通过潜变量反向更新编码器,推动连续表示与离散生成的协同适应;而 Flow Matching 的先验学习则通过停止梯度(stop-gradient)操作,与表示学习实现解耦,避免梯度冲突。
训练与推理流程的工程实现
Cola2 的整体流程分为明确的阶段,确保语义组织与细节补全的有效分工:
- 阶段一:语义压缩。依据内容动态分配潜变量位置,无梯度的反馈控制器负责维持压缩率目标。
- 阶段二:解耦的潜变量先验。块因果 DiT(Diffusion Transformer)通过 Flow Matching 拟合在线潜变量分布。其梯度在编码器处被阻断,而 token 侧的梯度继续塑造表示。
- 推理闭环:提出 → 解码 → 重编码。在推理时,DiT 首先提出潜变量块,解码器据此生成 token。随后,系统按固定片段布局对生成的文本进行重新编码,确保潜变量历史始终与实际的离散文本上下文保持一致。
实验数据与性能表现
研究团队在五个下游任务上进行了系统组件分析,并在约 210B tokens 的规模下进行了受控比较,验证了 Cola2 的核心设计。
- 高数据效率:在仅使用 346.03B 源 tokens 且模型尚未收敛的情况下,Cola2 的 checkpoint 在八项任务中取得了 60.10 的平均分。在 HellaSwag 和 StoryCloze 评测中,其表现超过了 Llama-3-8B,而 Llama-3-8B 报告的预训练 token 预算高出 43 倍以上。
- 四项核心实验结论:
- 语义压缩:动态分段与面向生成的监督缺一不可。两者结合可使潜变量在高压缩率下仍保持较强的语义性。
- 生成器训练:使用 token 侧监督持续更新 VAE,同时阻断 Flow Matching 梯度进入编码器效果最佳。中等潜变量块大小与匹配的噪声日程表现最优。
- 重建与生成平衡:解码器在丢弃、加噪、干净条件按 0.4 / 0.4 / 0.2 的配比训练时效果最佳。打乱潜变量会导致性能大幅下降,证明解码器确实依赖对齐的语义内容。
- 扩展趋势:随着训练规模增长,Cola-MDM 展现出最强的整体扩展趋势。压缩版 Cola2-MDM 虽收敛较慢,但在约 150B tokens 后仍持续缩小与基线模型的差距,尚未达到性能饱和。
这些结果证实,基于 Qwen 初始化的因果解码器生成能力得到了有效迁移,层次化语言生成仍具有显著的扩展空间。
局限性与未来工程优化方向
研究团队客观指出了当前系统的局限性,并将其视为进一步优化的起点:
- 模型尚未收敛:尤其是潜变量 DiT 部分,当前训练规模受限于可用资源。需要更大的模型参数量、更长的训练周期以及更广泛的数据和算力预算,才能准确测定其性能上限。
- 端到端推理速度挑战:理论上,压缩能够降低潜变量先验中占主导的线性层和注意力计算量(FLOPs)。但实际端到端生成速度还受解码器、CFG 分支、潜变量反馈和硬件利用率的影响。要将理论节省转化为实际加速,需要进行底层基础设施的协同设计,包括开发专用 kernel、优化缓存管理和并行调度。
- 解码器兼容性研究不足:虽然 Cola2 已展现出与自回归和掩码扩散解码器的兼容性,但它们在联合训练目标、推理权衡和最佳分工方面仍缺乏充分研究。
- 跨模态扩展潜力:连续潜空间有望为文本与视觉等其他连续模态提供共享接口,这将为统一潜表示、跨模态先验学习以及统一的理解与生成任务打开新的技术路径。
© 版权声明
文章版权归作者所有,未经允许请勿转载。