Cognition 正式推出 SWE-2 Flash 编码模型。该模型以较低的计算成本和较高的推理速度,处理日常软件工程中的自动化、代码审查、功能开发及文档更新等任务。其核心训练流程在传统强化学习之前,首次引入了中期训练(Mid-training)阶段,从而在多项基准测试中实现了显著的性能跃升。
- 官方介绍:https://cognition.com/blog/swe-2-flash
架构演进与基准测试表现
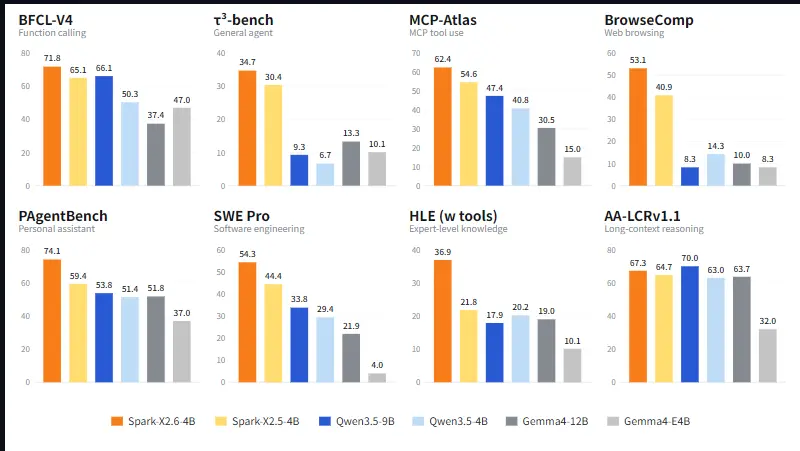
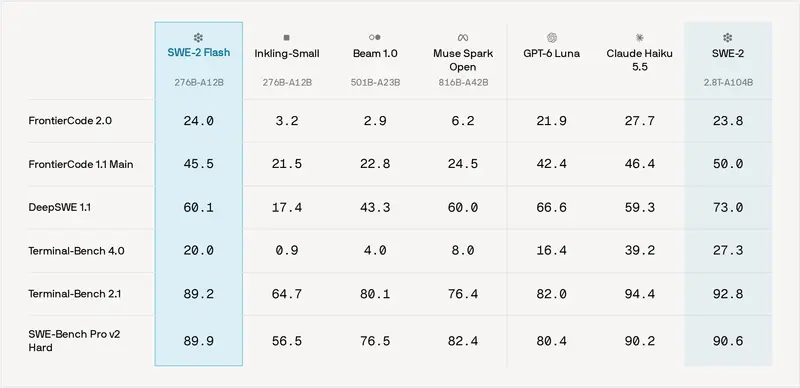
SWE-2 Flash 基于 Thinking Machines 开发的 Inkling-Small 模型(总参数 276B,激活参数 12B)进行迭代。通过引入新的训练配方,该模型在关键编码基准上取得了实质性进展:在 Terminal-Bench 4.0 测试中,得分从基线的 0.9% 提升至 20.0%;在 FrontierCode 2.0 测试中,得分从 3.2% 提升至 24.0%。根据官方数据,SWE-2 Flash 在领先评估中的表现已超越当前所有美国本土的开放权重模型,甚至优于参数量大其 3 倍的模型。
中期训练与强化学习的工程优化
模型性能的提升主要归功于训练流程的精细化调整,具体分为两个关键阶段:
- 中期训练(Mid-training):这一阶段的核心挑战在于确定最优的数据混合比例。研究团队构建了一个高质量的留出编码数据集作为评估基准,并利用 Token 效率图来量化不同数据源的训练效率。通过测量各候选数据混合达到基线验证损失所需的 Token 数量,团队最终确定了一个包含数万亿 Token 的数据集,涵盖高质量科学文章、技术博客和代码库。训练被划分为三个阶段,确保模型在后期能够集中学习最稀缺、最高质量的数据,使留出验证损失保持稳定的对数线性下降。
- 强化学习(RL):在中期训练完成后,模型进入了大规模强化学习阶段。此阶段的改进主要源于 RL 任务质量和多样性的提升。团队对任务的指令清晰度、环境设置和验证器进行了严格审计,并引入了多种新任务类型,以覆盖更广泛的通用推理和问题解决能力,从而支撑 Devin 智能体在实际工作流中的复杂需求。
部署成本与实际应用场景
随着模型能力的演进,降低日常工程工作的计算成本成为重要目标。SWE-2 Flash 专为处理软件智能体承担的大部分常规工作而设计。在部署层面,该模型已集成至 Devin Desktop 和 Devin CLI 中。与参数量更大的 SWE-2 模型相比,SWE-2 Flash 的 API 调用价格仅为前者的五分之一,同时推理速度提升了 3 倍。目前,该模型对所有 Devin Desktop 和 CLI 的 Pro、Max 及 Teams 用户免费开放,直至本月底。
权重开放策略与网络安全平衡
在企业级应用和关键任务场景中,客户不仅需要模型具备强大的能力,还需要对部署环境拥有完全的控制权和可观察性,包括本地化部署的需求。同时,学术界和工业界研究人员也需要透明的权重访问权限,以研究模型的行为模式及潜在滥用风险。
为此,Cognition 在训练过程中专门针对网络安全任务进行了优化,使模型在 ExploitBench 基准测试中的得分从 11.3% 提升至 34.8%。然而,鉴于这些增强的网络安全能力同样可能被恶意攻击者利用,Cognition 目前尚未向公众完全公开模型权重。作为平衡透明度与安全性的折中方案,团队正在构建一个受控项目,计划在几周内与经过审查的可信行业合作伙伴及研究实验室安全共享模型权重,以支持敏感环境下的微调与本地运行研究。
© 版权声明
文章版权归作者所有,未经允许请勿转载。