蚂蚁百灵官方团队今日正式发布原生多模态模型 Ling-3.2-flash。该模型具备 560B 总参数与 25B 激活参数,并支持 1M(100万)上下文窗口。
原生多模态架构与四大能力扩展
Ling-3.2-flash 从底层架构层面将视觉与语言能力进行融合,支持图像、文本与视频等多种输入格式。这种原生设计使其在处理多模态任务时,能够直接进行联合计算,减少了对复杂拼接流程的依赖。
在能力侧重上,该模型针对四个具体场景进行了工程优化:
- 复杂视觉理解:针对图像与视频内容进行深度的推理与分析。
- 多模态长程 Agent:在执行多步骤任务时,模型能够基于视觉与文本信息保持目标一致,完成连续的决策与执行。
- 3D 理解与交互:侧重于解析三维场景与空间关系。
- 医疗多模态:覆盖医学影像理解与专业报告解读,辅助医疗分析。
多项基准测试成绩与前端生成表现
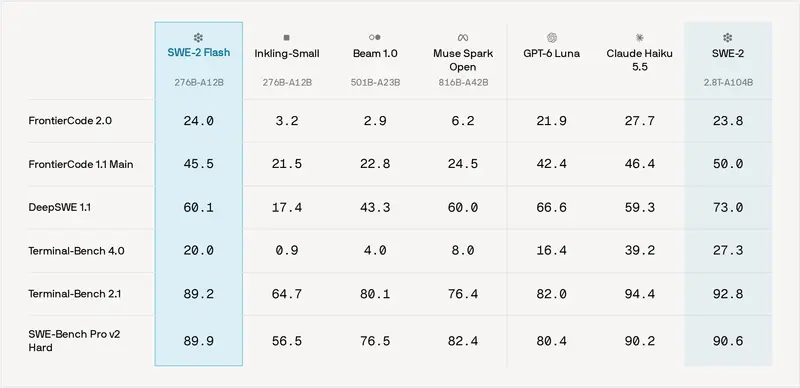
根据蚂蚁官方公布的评测数据,Ling-3.2-flash 在多项基准测试中取得了具体分数。在文档理解方面,其 OmniDocBench1.5 得分为 92.21,高于 Anthropic Claude Opus 5(max)的 90.56;在 ZEROBench(Sub)测试中得分为 43.71,对比后者为 39.52;在 Vision2Web 评测中得分为 85.86,对比后者为 80.20。
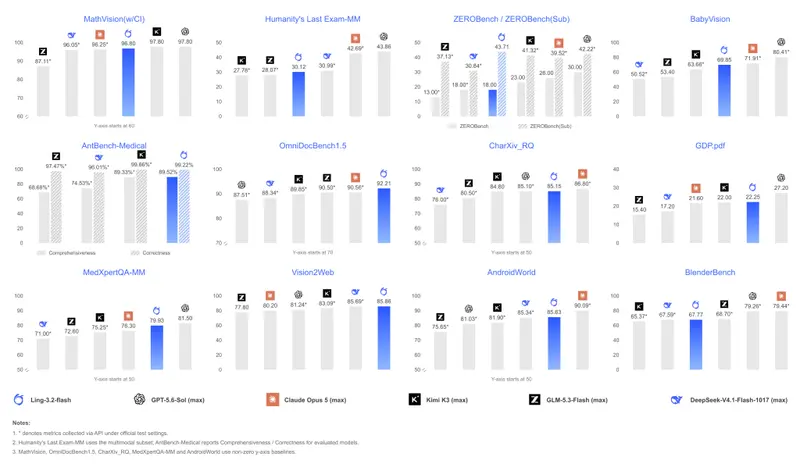
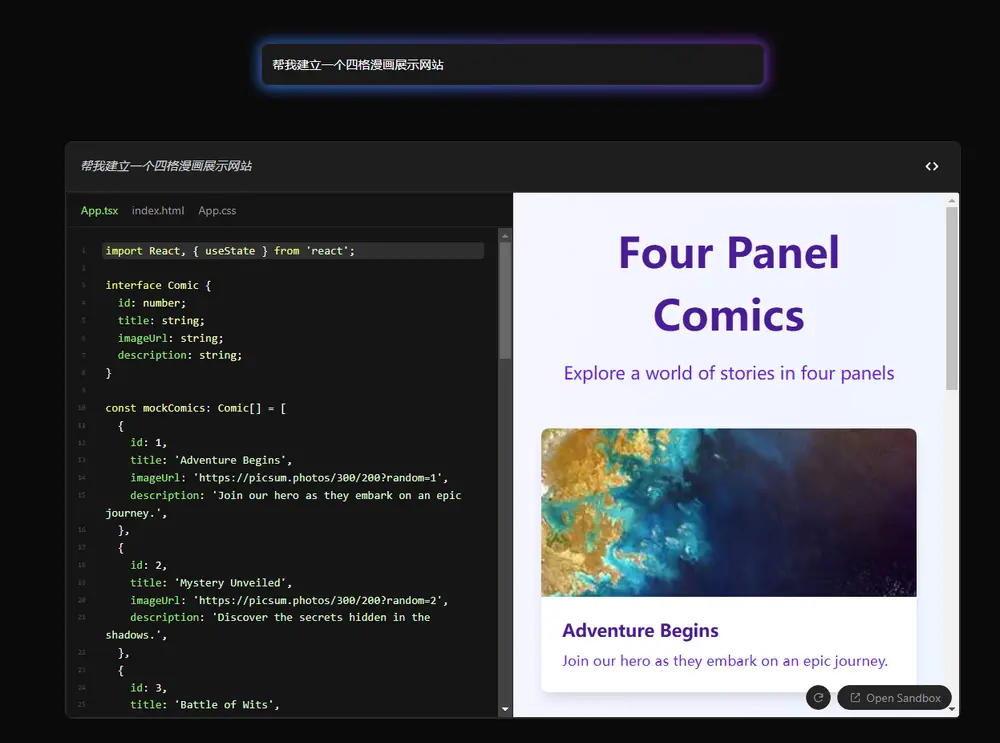
此外,在 DesignArena 图像转前端代码竞技场中,该模型获得 1238 的 Elo 分数,进入榜单前十,与 Meta、DeepSeek 及 Anthropic 等机构的模型处于同一梯队。
MoE 架构的成本控制与 API 定价
560B 的总参数与约 25B 的激活参数,是 Ling-3.2-flash 在模型能力与推理开销之间做出的工程权衡。这种参数规模通常对应混合专家(MoE)架构。在实际运行中,模型在每次前向计算时仅调用部分参数(即 25B 激活参数),从而在保留大容量知识存储的同时,有效控制单步计算的成本。
在商业化定价方面,Ling-3.2-flash 的 API 输入价格为每百万词元 0.30 美元(约合 2 元人民币),输出价格为每百万词元 0.90 美元(约合 6 元人民币)。DesignArena 榜单数据显示,这是同性能级别模型中较低的费率。
目前,该模型的 API 已通过蚂蚁百灵平台上线。用户可通过对话页在线体验,API 兼容 OpenAI 及 Anthropic 协议。此外,平台提供上线前 2 周的限时免费体验。
© 版权声明
文章版权归作者所有,未经允许请勿转载。