Google DeepMind 发布 Gemma 4 12B:首款原生音频处理的无编码器多模态模型,16GB 内存即可运行智能体工作流,Apache 2.0 开源
Google DeepMind 正式发布了 Gemma 4 12B,这是一款密集多模态大语言模型。作为首款在中型规模上具备原生音频处理能力且完全摒弃独立编码器的 Gemma 模型,它实现了文本、图像、视频和音频的统一处理。更令人振奋的是,凭借高效的架构设计,Gemma 4 12B 仅需 16GB 内存即可在消费级笔记本电脑(包括 Apple Silicon Mac)上流畅运行复杂的智能体工作流,并以 Apache 2.0 许可完全开源。
- 官方介绍:https://blog.google/innovation-and-ai/technology/developers-tools/introducing-gemma-4-12b
- 模型:https://huggingface.co/collections/google/gemma-4
核心亮点:无编码器、原生音频、端侧友好
1. 颠覆性架构:无需编码器 (Encoder-Free)
- 统一主干:彻底移除了传统的视觉和音频 Transformer 编码器。视觉和音频数据直接通过线性投影进入 LLM 主干,消除了编码器带来的延迟和参数开销。
- 视觉处理:原始图像被分割为 48×48 像素块,通过单次矩阵乘法投影至隐藏维度,并利用分解坐标查找注入空间位置信息。
- 音频处理:原始 16kHz 音频被切片为 40ms 帧,每帧 640 个值直接线性投影至文本嵌入空间,无需 Conformer 层或特征提取。
2. 原生多模态能力
- 首款中型音频 Gemma:支持原生自动语音识别 (ASR)、说话人分离及音频情感理解,无需外部 ASR 流水线。
- 视频理解:能够同时处理视频帧序列与伴随音频,实现真正的视听融合分析。
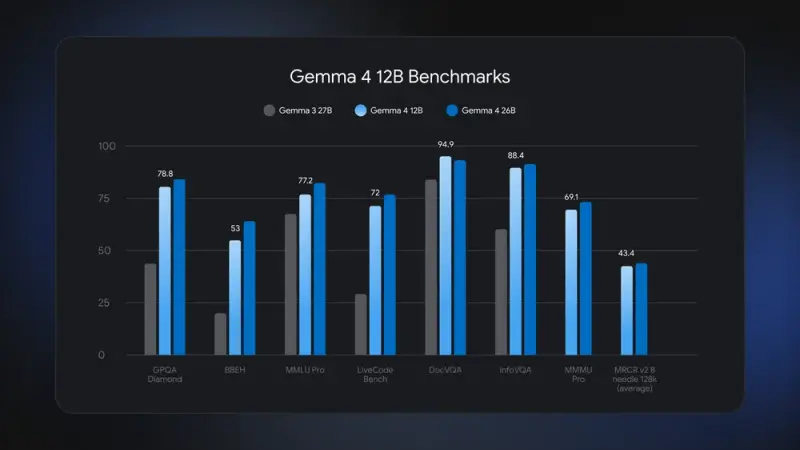
- 智能体推理:在本地环境下即可执行多步骤智能体工作流,性能接近参数量大一倍的 26B MoE 模型。
3. 极致轻量化部署
- 16GB 内存即可运行:得益于密集架构的高效性,其内存占用不到 26B MoE 模型的一半,完美适配主流轻薄本及移动端设备。
- 广泛生态兼容:支持 llama.cpp, MLX, vLLM, Ollama, SGLang, Unsloth, LM Studio 等主流推理框架。
- OpenAI 兼容 API:通过
litert-lm serve可快速搭建本地兼容 OpenAI 格式的 API 服务。
性能与优势
| 特性 | Gemma 4 12B | 传统多模态模型 |
|---|---|---|
| 架构 | 无编码器,统一权重空间 | 独立视觉/音频编码器 + LLM |
| 音频处理 | 原生支持,端到端 | 需外部 ASR 模型预处理 |
| 微调难度 | 低,LoRA/全量微调一次更新所有模态 | 需分别调优冻结的编码器 |
| 推理延迟 | 低,LLM 立即开始处理 | 高,需等待编码器完成特征提取 |
| 硬件门槛 | 16GB 内存 | 通常需更高显存或多卡 |
| 性能对标 | 接近 26B MoE 模型 | 视具体模型而定 |
注:在 Google AI Edge Eloquent 应用中,切换至 Gemma 4 12B 带来了超过 60% 的整体质量提升。
适用场景
- 离线语音助手:在隐私敏感场景下,实现本地高精度的语音转录与意图理解。
- 视频内容分析:在笔记本上直接处理短视频,提取关键信息、字幕及情感摘要。
- 端侧智能体:构建无需云端的个人 AI 助理,执行文件整理、邮件草稿、代码辅助等任务。
- 教育与研究:低成本探索多模态大模型的微调与应用开发,无需昂贵 GPU 集群。
© 版权声明
文章版权归作者所有,未经允许请勿转载。