Poolside 正式发布了 Laguna S 2.1,这是一款总参数量为 118B 的混合专家(MoE)模型,每个 token 仅激活 8B 参数。作为 Laguna 系列中迄今为止最强大的成员,Laguna S 2.1 专为本地运行和智能体编码(Agentic Coding)设计,拥有高达 1M token 的上下文窗口,并支持原生推理思考模式。
- 官方介绍:https://poolside.ai/blog/introducing-laguna-s-2-1
- 模型:https://huggingface.co/collections/poolside/laguna-s-21
该模型在 OpenMDW-1.1 许可下完全开源,旨在回应开发者对 80-120B 范围内高性能、可本地部署严肃模型的迫切需求。
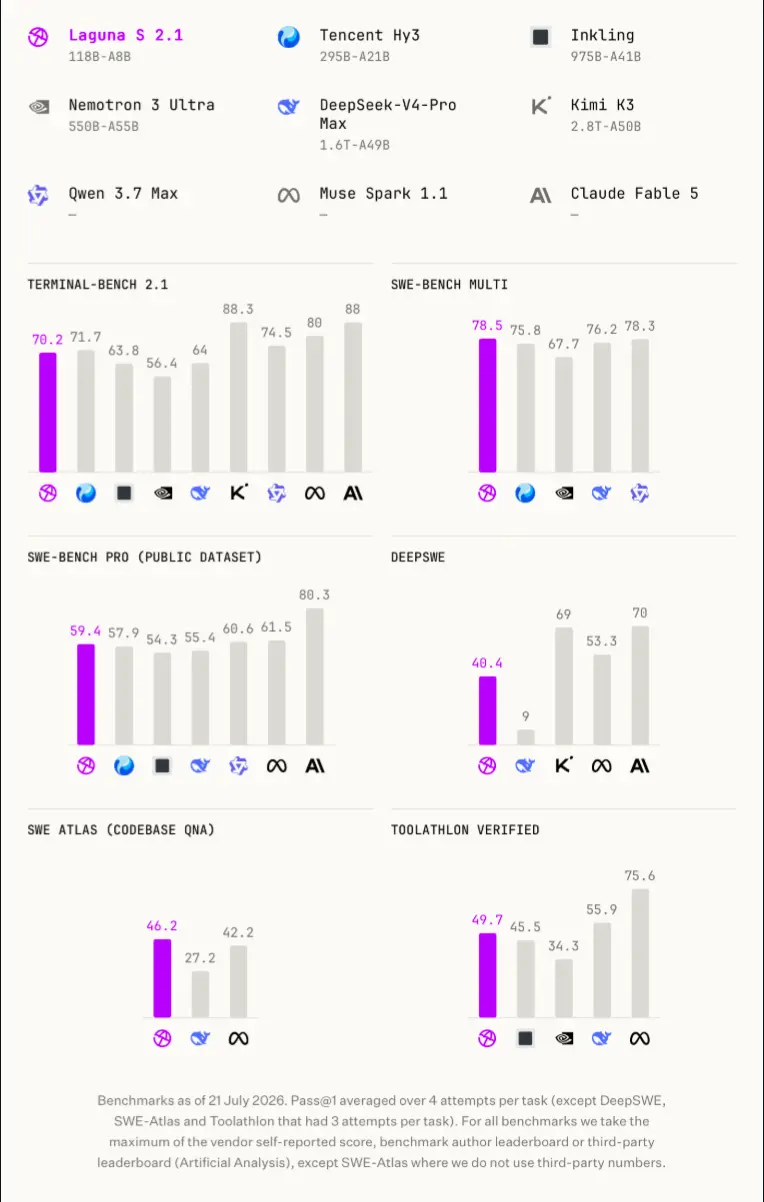
核心亮点:小身材,大智慧
🚀 极致性能与效率平衡
- 越级挑战:在 Terminal-Bench 2.1 基准测试中得分 70.2,与体积大 5 到 25 倍的模型并驾齐驱甚至超越。
- 长周期任务专家:在高难度的 DeepSWE 基准测试中得分 40.4,优于部分参数超过 1T 的开放模型,证明其在复杂、多步骤编码任务中的卓越能力。
- 本地友好:尽管总参数达 118B,但凭借 MoE 架构(激活 8B),它足以在单个 NVIDIA DGX Spark 上运行,极大地降低了企业和个人开发者的部署门槛。
🧠 原生推理与执着行为
- 思考与非思考模式:支持通过
enable_thinking参数控制,允许模型在工具调用之间穿插深度思考,提升复杂逻辑的准确性。 - 自我验证与持久性:Laguna S 2.1 表现出独特的“执着”特质。在内部测试中,它经过约 69 万个 token 的迭代,将工具链速度提升了 5.2%,内存分配减少了 70%。当增益微小时,它不会伪造进展或过早宣布胜利,而是转向其他可衡量指标继续优化。
🛠️ 广泛的生态支持
- 多格式权重:提供 BF16、FP8、INT4 和 NVFP4 格式,并附带官方 GGUF 和 MLX 转换。
- 加速推理:提供经过训练的 DFlash 草稿模型以支持推测解码(Speculative Decoding),显著降低延迟。
- 全平台兼容:发布首日即支持 llama.cpp、Ollama、vLLM、SGLang、NVIDIA TRT-LLM、Hugging Face transformers 和 ZML。
技术架构详解
| 特性 | 规格/描述 |
|---|---|
| 总参数 | 118B |
| 激活参数 | ~8B per token |
| 上下文窗口 | 1,048,576 tokens (1M) |
| 层数 | 48 层 |
| 专家结构 | 256 个路由专家 + 1 个共享专家 |
| 注意力机制 | 分组查询注意力 (GQA),8 个 KV 头,头维度 128;每头 softplus 输出门控 |
| 滑动窗口 | 512 tokens |
| 注意力布局 | 混合 SWA (滑动窗口注意力) 和全局注意力,比例 1:3 |
| 词汇量 | 100,352 tokens |
| 模态 | 文本到文本 |
训练与进化:Model Factory 的有效性
Laguna S 2.1 的能力跃升主要归功于先进的后训练策略:
- 监督微调 (SFT):部分使用合成数据,提升基础指令遵循能力。
- 强化学习 (RL):针对模型尚无法可靠解决的任务进行 RL 优化。这是 Poolside 第一个在 FP8 精度下运行 RL 的模型,显著提高了训练效率。
- 基础设施升级:使用了更长的展开预算、改进的沙盒基础设施和多工具链展开,确保学到的智能体行为能够跨工具栈迁移。
适用场景
- 本地智能体开发:希望在本地环境中运行强大编码助手,同时保护代码隐私的企业或个人。
- 长代码库维护:利用 1M 上下文窗口,处理大型项目的全局重构、依赖分析或文档生成。
- 自动化工作流:作为自主智能体的核心大脑,执行需要多步验证、自我修正和长期记忆的复杂编程任务。
© 版权声明
文章版权归作者所有,未经允许请勿转载。