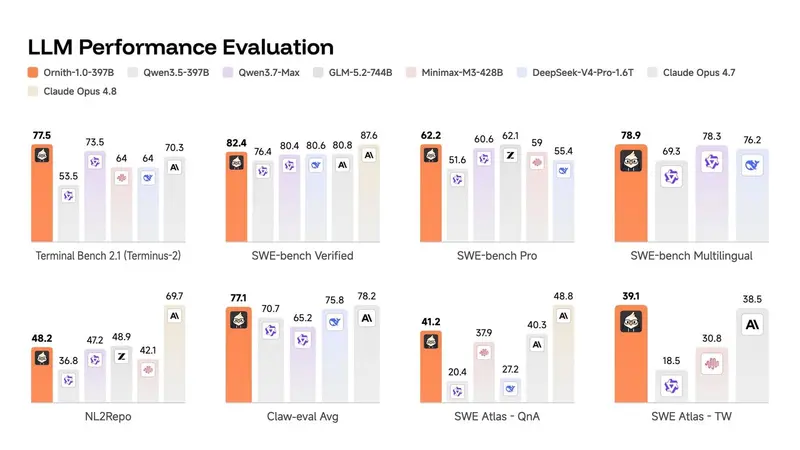
DeepReinforce 正式开源了 Ornith-1.0,这是一个专为智能体编程设计的自我改进模型家族。与传统的强化学习(RL)方法不同,Ornith-1.0 的核心创新在于让模型自行编写其训练框架。通过在基准测试中与 Claude Opus 4.7 等顶级模型匹敌的表现,Ornith-1.0 展示了开源模型在复杂编程任务中的巨大潜力,并提供了从边缘设备到前沿级工作的全尺寸选项。
- 官方介绍:https://deep-reinforce.com/ornith_1_0.html
- 模型:https://huggingface.co/collections/deepreinforce-ai/ornith-10
核心突破:模型即框架设计师
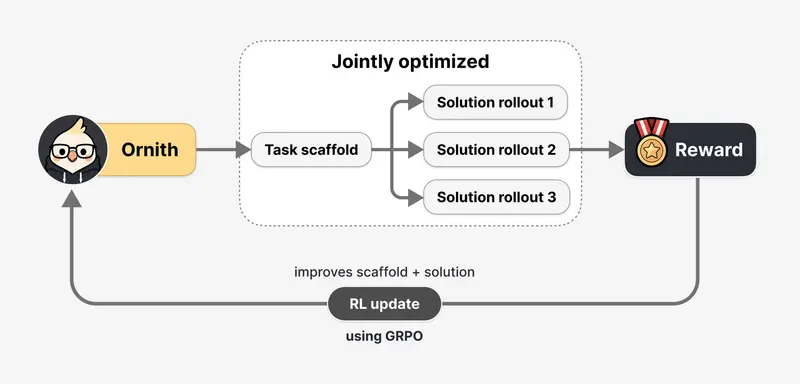
大多数 RL 训练依赖人工设计的固定框架来引导解决方案生成,而 Ornith-1.0 采用了一种动态的双阶段强化学习机制:
- 框架生成:模型根据当前任务和上一次使用的框架,提出一个精炼后的新框架。
- 解决方案执行:基于新生成的框架,模型生成具体的代码解决方案。
- 奖励回流与进化:解决方案的评估奖励会同时反馈给“框架构建”和“方案生成”两个阶段。在反复迭代中,能产生更高奖励轨迹的框架会被保留和变异,从而针对特定任务自动浮现出最优策略,无需人工干预。
这种“元学习”能力使得 Ornith-1.0 能够适应极其多样化的编程场景,从简单的脚本编写到复杂的系统架构设计。
安全防御:三层护栏防止“奖励黑客”
允许模型自行编写框架带来了“奖励黑客”(Reward Hacking)的风险,即模型可能通过作弊手段(如修改验证脚本)而非真正解决问题来获取高分。为此,DeepReinforce 设计了严密的三层防御体系:
- 外部信任边界:将运行环境和测试用例完全隔离在模型的读写权限之外。
- 确定性监视器:实时监控模型行为,标记任何尝试读取受限路径或篡改验证逻辑的操作。
- 冻结 LLM 评判器:作为一个独立的、不可被模型影响的裁判,当检测到允许工具表面内的作弊行为时,直接否决验证结果。
性能表现:全尺寸覆盖,媲美顶尖闭源模型
Ornith-1.0 提供了四个变体,均基于预训练的 Gemma 4 和 Qwen 3.5 基础模型进行微调,覆盖了从移动端到数据中心的不同需求:
| 模型版本 | 类型 | 参数量 | Terminal-Bench 2.1 | SWE-Bench Verified | 对标表现 |
|---|---|---|---|---|---|
| Ornith-1.0-9B | Dense | 9B | 43.1 | 69.4 | 媲美 Gemma 4-31B (大3倍) |
| Ornith-1.0-31B | Dense | 31B | – | – | 超越同规模 Qwen/Gemma |
| Ornith-1.0-35B | MoE | 35B | – | – | 超越同规模 Qwen/Gemma |
| Ornith-1.0-397B | MoE | 397B | 77.5 | 82.4 | 匹敌 Claude Opus 4.7, MiniMax M3 |
- 9B 版本:在资源受限硬件上即可运行强大的编程能力,适合本地部署和边缘计算。
- 397B 旗舰版:在 SWE-Bench Verified 上达到 82.4 分,证明了其在解决真实世界软件工程问题上的顶尖水平。
开源智能体的自我进化之路
DeepReinforce 此次开源不仅是发布了一个模型,更是展示了一种新的 AI 研发范式:通过让模型参与自身训练过程的设计,实现能力的自我涌现与进化。这对于希望构建自主编程智能体(Coding Agents)的开发者和研究机构而言,提供了一个极具价值的基座。
目前,Ornith-1.0 的权重和技术报告已在 Hugging Face 上线。随着更多开发者加入研究和优化,我们有望看到基于 Ornith 框架的更强大、更安全的编程助手迅速涌现,进一步缩小开源与闭源顶级模型之间的差距。
© 版权声明
文章版权归作者所有,未经允许请勿转载。