斯坦福提出 AsymFlow:首个将预训练潜在模型微调至像素空间的流生成框架,ImageNet FID 1.57 刷新纪录,AsymFLUX.2 超越 FLUX.2 基础版
在高维像素空间中进行基于流(Flow-based)的生成一直面临巨大挑战:即使数据具有低秩结构,速度场预测仍需处理高维噪声,导致训练困难且效率低下。近日,斯坦福大学研究团队提出了 Asymmetric Flow Models (AsymFlow),一种创新的秩不对称速度参数化方法。
- 项目主页:https://hanshengchen.com/asymflow
- GitHub:https://github.com/Lakonik/LakonLab/blob/main/docs/AsymFlow.md
- 模型:https://huggingface.co/Lakonik/AsymFLUX.2-klein-9B
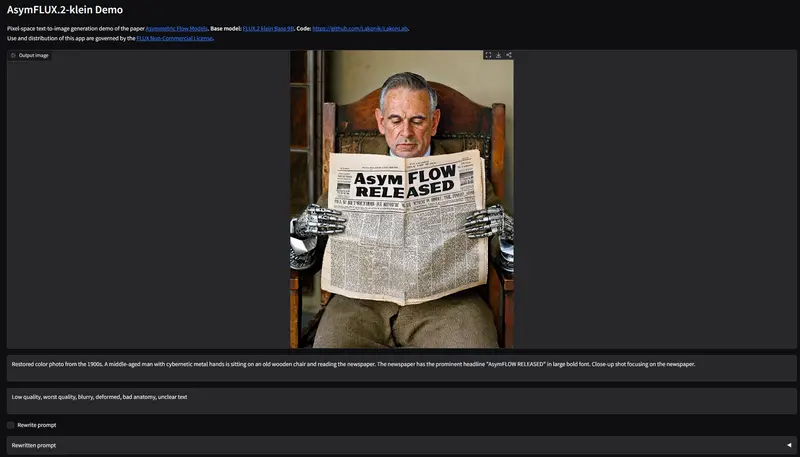
- Demo:https://huggingface.co/spaces/Lakonik/AsymFLUX.2-klein
AsymFlow 不仅在不改变网络架构的前提下,将 ImageNet 256×256 的 FID 刷新至 1.57,更开创了将预训练潜在扩散模型微调为像素空间模型的新路径。基于此框架微调出的 AsymFLUX.2 klein,在文本到图像生成的真实感与细节表现上,全面超越了其潜在空间基础模型 FLUX.2 klein。
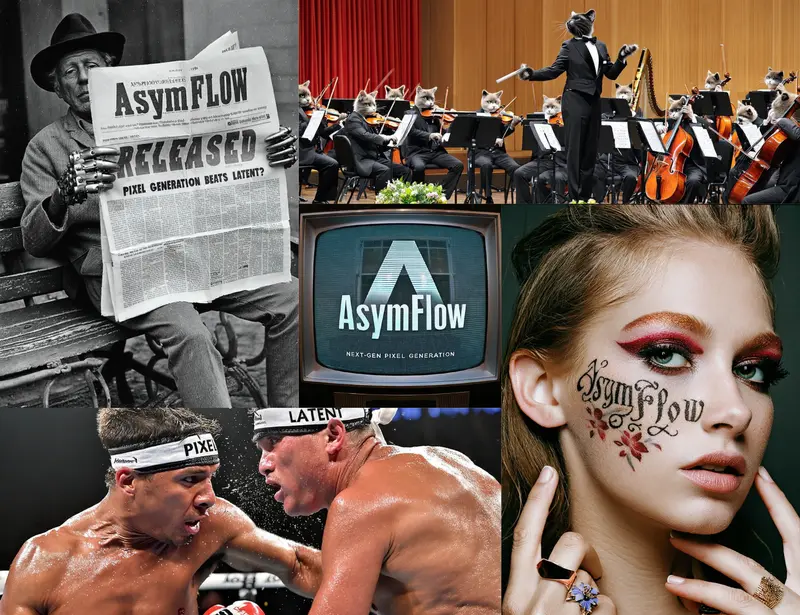
核心亮点:秩不对称、无缝微调、SOTA 性能
1. 秩不对称速度参数化 (Rank-Asymmetric Velocity Parameterization)
- 痛点解决:传统流匹配需预测全维速度,计算量大且难以优化。
- 创新机制:AsymFlow 将速度预测分解为两部分:
- 噪声项 ($\epsilon$):限制在低秩子空间中预测,大幅降低复杂度。
- 数据项 ($x_0$):保持全维预测,确保细节完整性。
- 解析恢复:通过公式 $u_A = P_\perp \epsilon – x_0$,可在训练和采样过程中解析地恢复全维速度,无需额外的网络分支或复杂的后处理。
2. 首条“潜在 -> 像素”微调路径
- 无缝初始化:通过将预训练的潜在空间与低秩像素块子空间对齐,AsymFlow 实现了从潜在模型到像素模型的无缝权重迁移。
- 高效微调:模型无需重新学习高层语义和结构,只需专注于解决低层像素分布的不匹配问题。这使得利用强大的预训练潜在模型(如 FLUX.2)快速构建高质量像素模型成为可能。
- 架构无关:该方法适用于任何基于流的生成架构,无需修改 backbone 网络。
3. 刷新多项基准测试纪录
- ImageNet 256×256:
- 使用 JiT-H/16 网络,FID 达到 1.76。
- 结合 REPA 损失,FID 进一步降至 1.57,大幅超越此前最佳的 DiT/JiT 类像素扩散模型。
- 文本到图像生成 (AsymFLUX.2 klein):
- 基于 FLUX.2 klein (9B) 微调而成。
- HPSv3: 10.66 (排名第一),视觉风格与真实感显著提升。
- DPG-Bench & GenEval: 全面超越潜在空间基础模型,尤其在复杂构图与细节纹理上表现优异。
性能对比
| 模型/方法 | 任务 | 指标 (FID / HPSv3) | 备注 |
|---|---|---|---|
| AsymFlow (JiT-H/16 + REPA) | ImageNet 256 像素生成 | 1.57 FID | SOTA,超越所有 DiT/JiT 像素模型 |
| AsymFLUX.2 klein | 文本到图像生成 | 10.66 HPSv3 | SOTA,超越 FLUX.2 klein 基础版 |
| FLUX.2 klein (Latent) | 文本到图像生成 | < 10.66 HPSv3 | 潜在空间基线,细节略逊于像素版 |
| Previous Pixel DiT/JiT | ImageNet 256 像素生成 | > 1.76 FID | 此前最佳像素扩散模型 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。