MCPMarkMCPMark是一个全面的压力测试MCP基准,包含一系列多样化、可验证的任务,旨在评估模型和智能体在现实世界MCP使用中的能力。MCPMark将持续更新新兴的MCP服务器,以跟上充满活力的生态系统步伐!
LMArenaChatbot Arena是一个开放平台,专注于通过人类偏好评估大型语言模型(LLMs)的性能。该平台由加州大学伯克利分校的SkyLab和LMSYS研究团队开发,旨在为LLMs提供一个公正、透明的评估环境。
PokerBattlePokerBattle.ai 是一个让多个大语言模型(LLM)在真实德州扑克规则下自主对战的实验平台。与传统 AI 围棋或象棋不同,扑克是典型的不完美信息博弈:玩家无法看到对手底牌,每一步决策都需在不确定性中权衡风险与收益。
SciArenaSciArena是一个开放且协作的平台,直接吸引科学界参与评估科学文献任务中的基础模型。这种基于众包的、面对面的语言模型评估方法已在通用领域由类似 Chatbot Arena 的平台成功开创。
Supabase EvalsSupabase 正式开源了 Supabase Evals,这是一套用于评估 AI 智能体(如 Claude Code、Codex、OpenCode)在 Supabase 平台上构建能力的基准测试框架。它不再依赖模拟环境,而是让 AI 在真实的容器化堆栈中完成构建 Schema、调试 Edge Function、修复 RLS 策略等实际任务,并对结果进行严格评分。
PinchBenchPinchBench 是一个基准测试系统,用于评估作为 OpenClaw 编码智能体的大语言模型。我们在不同模型上运行同一组真实世界任务,并衡量成功率、速度和成本,以帮助开发者为其用例选择合适的模型。
MagicArenaMagicArena是字节跳动推出的一个采用Elo积分机制的视觉生成大模型公开对战平台。平台上有多个视觉生成大模型(文生图、文生视频、图生视频)随机两两对战,用户对生成的结果进行评价,累积定对战数据后可以查看自己的大模型排行榜。
stagewiseStagewise 是一个浏览器工具栏,能够将您的前端用户界面连接到代码编辑器中的AI代理。这意味着您可以直接在网页上选择元素,AI代理会根据您的操作提供实时的代码修改建议,真正做到“指哪改哪”。

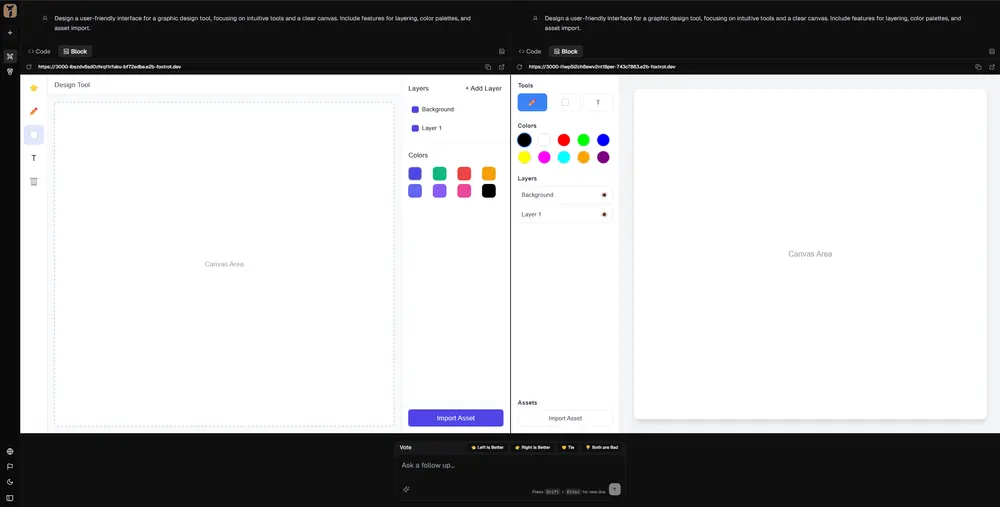
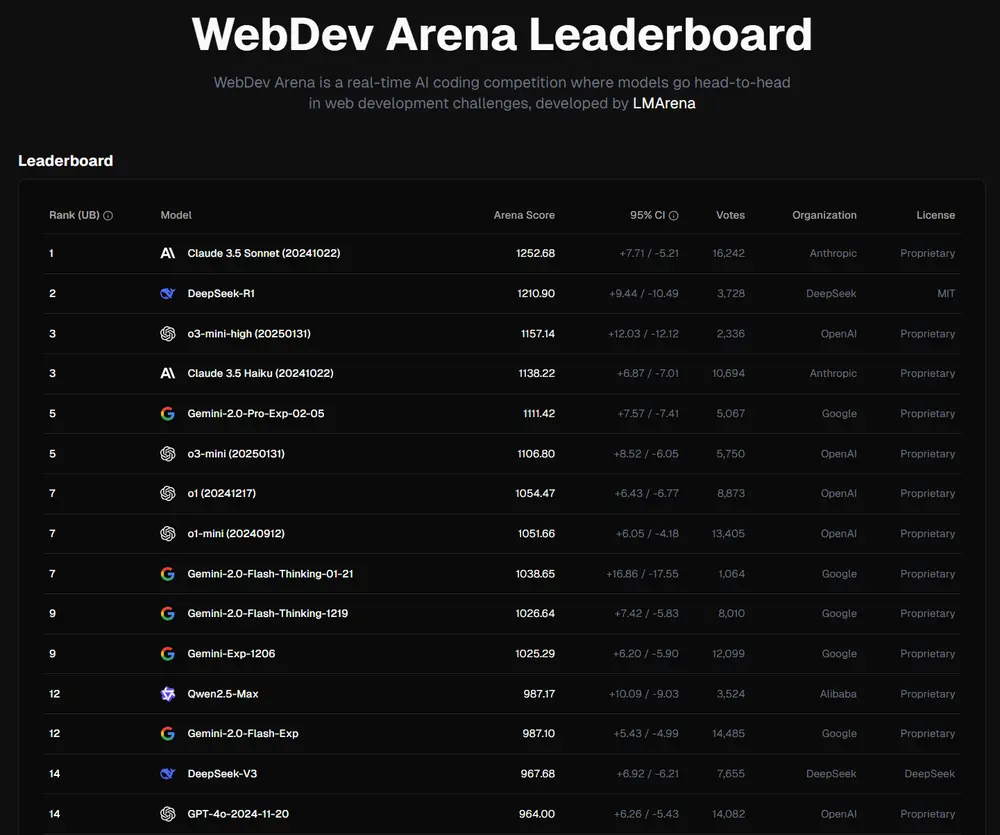
 WebDev Arena