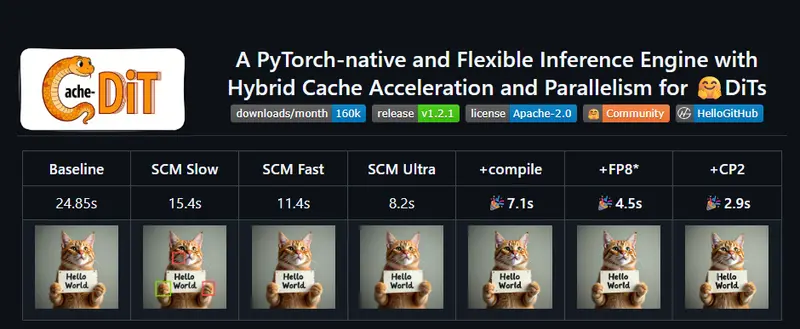
Cache-DiT:PyTorch原生DiT推理引擎,一行代码提速,支持70+扩散模型Cache-DiT是一款基于PyTorch原生构建的灵活推理引擎,核心目标是为Diffusers库提供统一的缓存加速与并行化支持,无需重新训练模型,仅需一行代码就能显著提升DiT类扩散模型的推理速度...新技术# Cache-DiT# DiT推理引擎9个月前2850
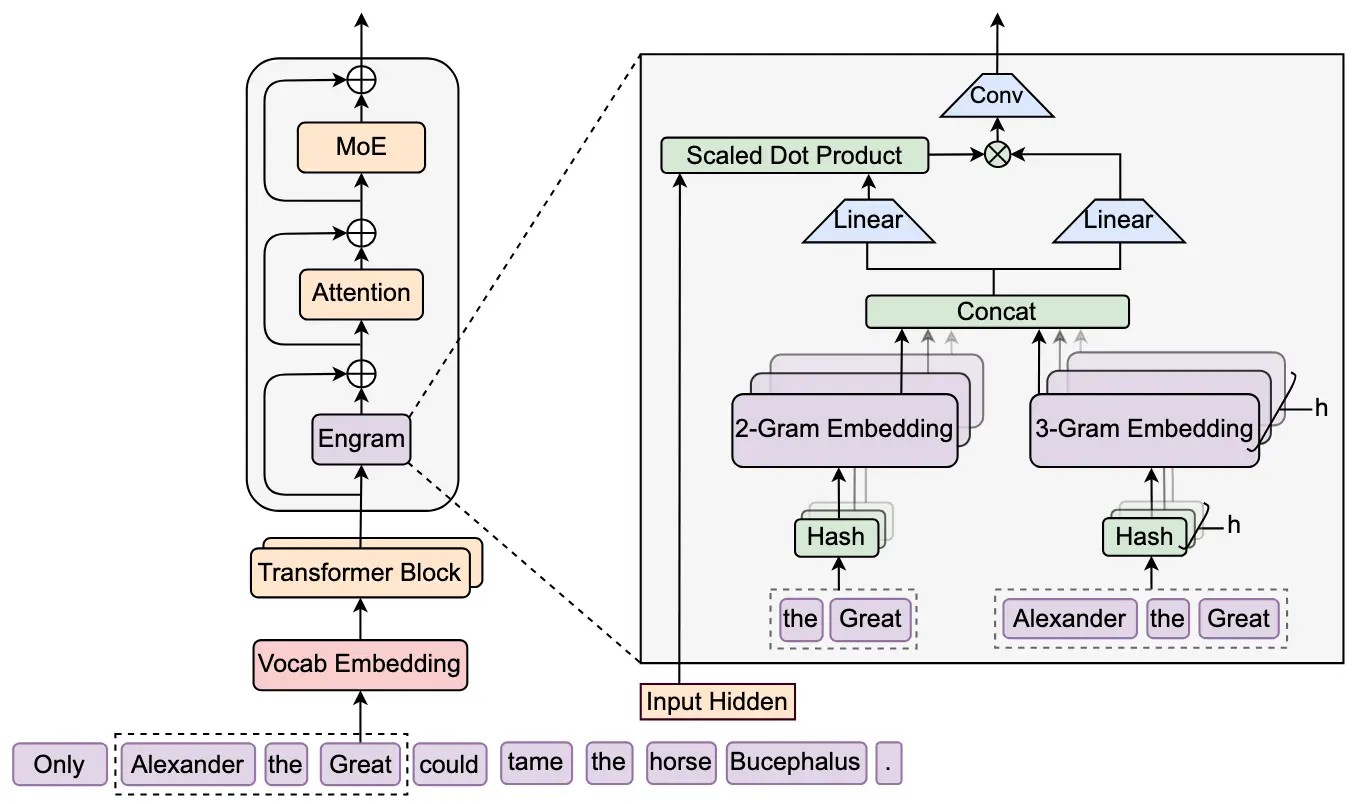
告别 GPU 算力浪费!DeepSeek 条件记忆技术:让大模型检索静态知识更高效当企业级大语言模型(LLM)在回答“iPhone 15 的电池容量是多少?”或“标准 NDA 条款包含哪些内容?”这类问题时,它正在动用为复杂推理设计的昂贵 GPU 计算资源——仅仅为了检索一段静态信...新技术# DeepSeek# Engram# 条件记忆10个月前2480
SDNQ 量化:跨平台模型压缩方案,显著降低显存占用并提升推理速度SDNQ(Stable Diffusion Next Quantization) 是 SD.Next 中集成的一套全平台量化系统,支持 19 种整数量化 与 69 种浮点量化 方案,可在 英伟达、AM...新技术# SDNQ# 模型压缩10个月前5340
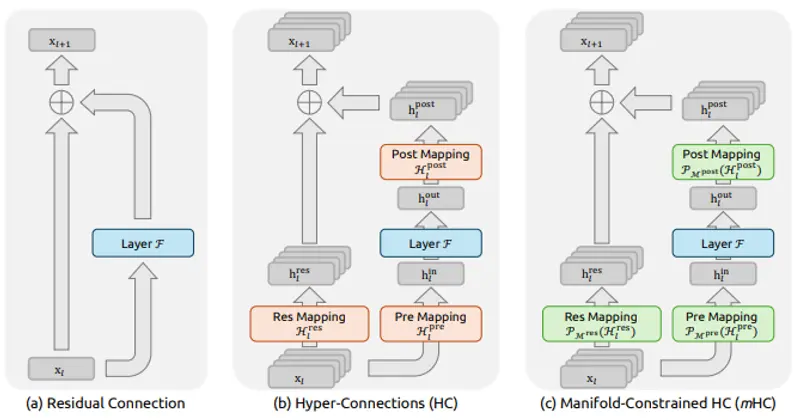
DeepSeek发布mHC技术论文:流形约束超连接让大模型训练更稳更省成本,已验证270亿参数量2026年初,中国AI初创公司DeepSeek发布了一篇重磅技术论文,由创始人梁文锋合著。论文提出对基础AI模型训练的核心架构进行重新设计,推出全新技术“流形约束超连接(mHC)”,旨在以更低成本训练...新技术# DeepSeek# mHC10个月前2690
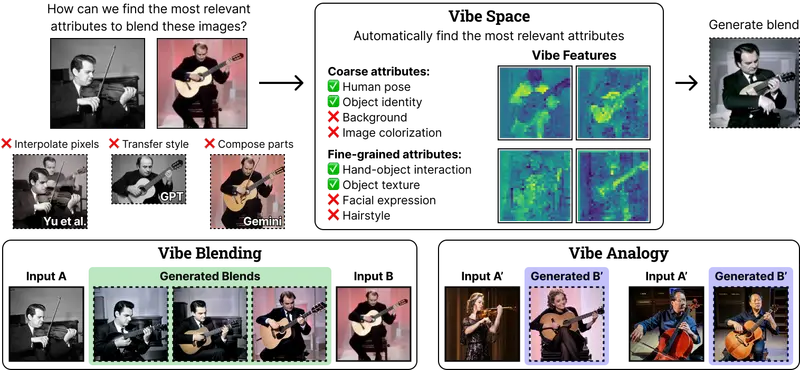
宾大与伯克利提出 Vibe Space,让 AI 理解视觉概念的“vibe”当 AI 被要求“融合一个小提琴演奏者和一个吉他演奏者”,它该生成什么?是乐器颜色的平均?演奏姿态的混合?还是创造出一种新型弦乐器演奏者——比如手持鲁特琴、姿势介于两者之间的形象? 传统方法往往停留在...新技术# Vibe Space10个月前2190
阿里云新系统 Aegaeon:用 213 个 GPU 实现 1,192 个的推理能力阿里云在 ACM SOSP 2025(操作系统原理研讨会)上发表了一篇经同行评审的论文,介绍其名为 Aegaeon 的新型 GPU 池化系统。该系统在阿里云 Model Studio 平台的多月生产测...新技术# Aegaeon# 阿里云1年前3110
华为开源 SINQ:新型量化技术让大模型在消费级显卡上高效运行随着大语言模型(LLM)参数规模持续增长,部署成本已成为制约其广泛应用的主要瓶颈之一。 华为苏黎世计算系统实验室近日推出一项名为 SINQ(Sinkhorn-Normalized Quantizati...新技术# SINQ# 华为# 量化技术1年前3890
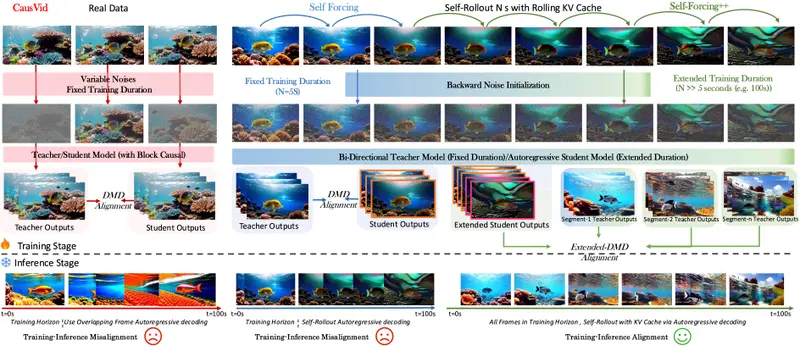
Self-Forcing++:一种无需长视频训练即可生成高质量长视频的新方法近年来,扩散模型在图像和短片视频生成方面取得了突破性进展。然而,当扩展到长视频生成(如数十秒甚至数分钟)时,现有方法普遍面临一个核心问题:质量随长度增加而显著下降。 这主要源于两个限制: 计算成本高...新技术# Self Forcing# 字节跳动1年前6040
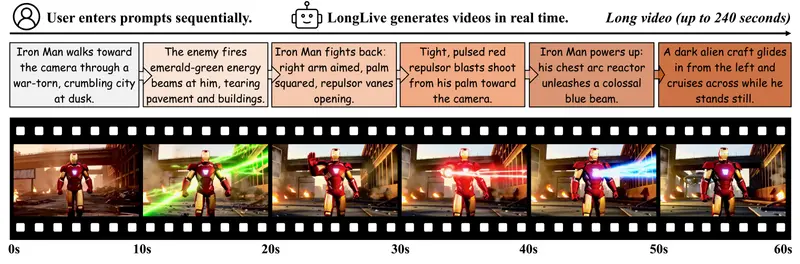
英伟达推出LONGLIVE:单卡实现实时交互式长视频生成AI生成视频正从“几秒特效”迈向“分钟级叙事”。 长期以来,生成高质量、长时间连贯的视频是AI内容创作的一大瓶颈。传统扩散模型虽能产出精美画面,却难以支持实时生成;自回归方法虽具备推理加速潜力,又常因...新技术# LONGLIVE# 英伟达1年前4030
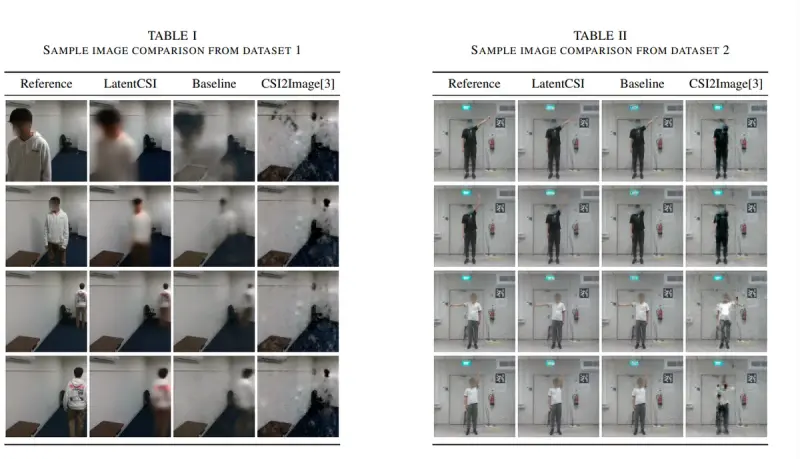
用 Wi-Fi 信号生成房间图像?LatentCSI 结合 AI 实现高分辨率空间重建东京科学研究所的研究团队近日提出一种新方法——LatentCSI,能够利用日常 Wi-Fi 设备采集的无线信号,结合预训练扩散模型,生成高分辨率的室内布局图像。 论文地址:https://arxiv...新技术# LatentCSI1年前4070
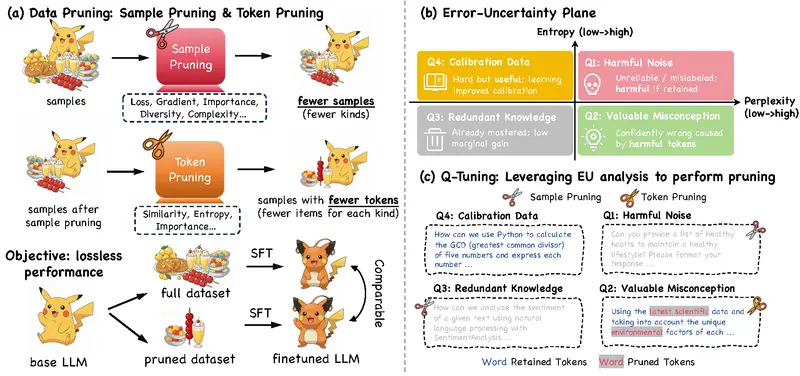
Q-Tuning:用“错误-不确定性”框架统一剪枝,提升微调效率监督微调(SFT)正变得越来越重。 过去,SFT 只是大模型训练流程中的一个轻量级收尾步骤;如今,它已演变为一场计算密集型任务,其数据规模和训练成本常常逼近中期预训练阶段。在有限算力预算下,如何高效利...新技术# Q-Tuning1年前2620
Rolling Forcing:一种用于长视频生成的新型自回归扩散方法在构建交互式世界模型、神经游戏引擎和沉浸式 XR 应用的道路上,一个核心挑战始终存在:如何实时生成高质量、时间连贯的长视频流? 当前主流的自回归视频生成方法虽能产出单段短片,但在生成多分钟连续视频时...新技术# Rolling Forcing# 长视频生成1年前3680