Minimax‑h3_Singularity Minimax-h3_Singularity 是一款经过深度战略融合与高精度微调的通用多模态视频生成模型。它并非简单的权重叠加,而是基于 ref、fl、b25-49 等关键检查点进行有机融合,并辅以长达 3 天的精确剪枝与权重优化,旨在彻底解决高步数训练带来的伪影问题,同时保留原始模型的强大泛化能力。
H3 Keyframe Animation Alvdansen Labs推出 H3 Keyframe Animation,为MiniMax H3视频模型打造三套专用LoRA,这套LoRA的核心目标,是让模型按照传统手绘动画师的思路生成动画,产出稳定统一的运动节奏,不再出现基础模型常见的矢量插值、数字缓动带来的画面漂移。
HyperFlow for MiniMax-H3 Video Rebirth 推出面向 MiniMax-H3 的加速 LoRA 项目 HyperFlow,依靠无数据流自蒸馏训练,将原本 49 次模型前向推理压缩至仅 8 次,在保留视频 + 音频生成能力的同时,实现约 3 倍端到端加速,原生适配 Diffusers 模块化管线。
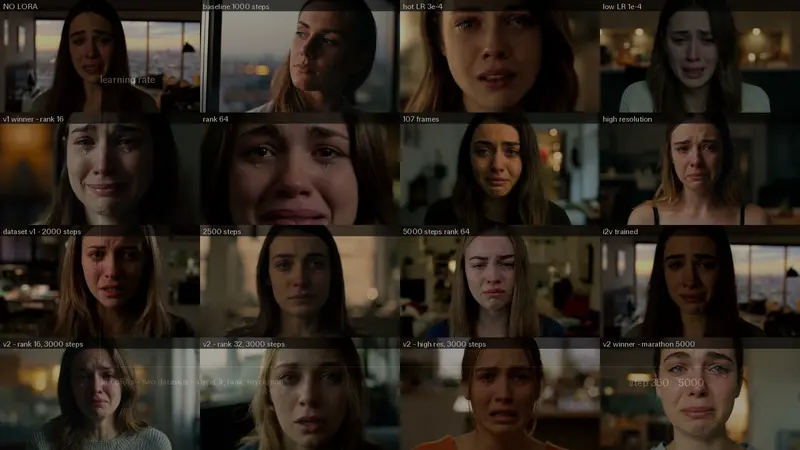
MiniMax H3 Realism People LoRA MiniMax H3 Realism People LoRA 是一个专为 H3 设计的Lora,旨在将写实人物的表现力推向新的高度:从经得起推敲的面部微表情,到自然的皮肤毛孔纹理,再到纪录片风格的持机运动感。
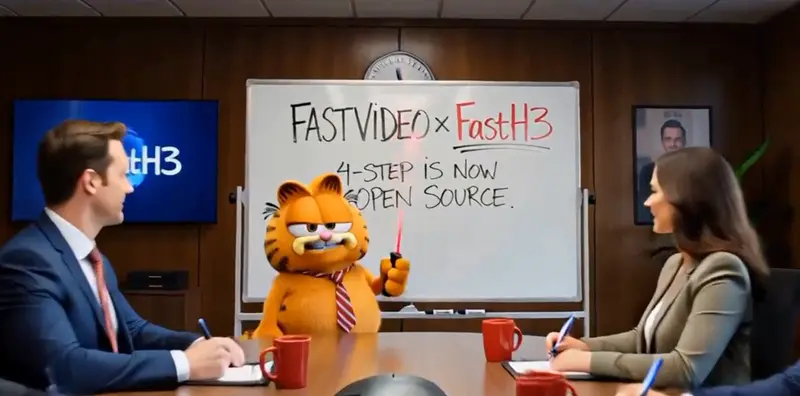
FastH3 FastVideo 联合 Nuva Lab、英伟达 FastGen 团队推出 FastH3,一款经过稀疏蒸馏优化、面向商用落地的 MiniMax H3 音视频生成开源模型。在单张 Blackwell 架构 B200 显卡上最高实现14.38 倍推理提速,15 秒 768p 音视频生成耗时不到 13 秒,大幅降低原生 H3 的超长等待时间。
Shaky, handheld camera Shaky, handheld camera是一个Minimax-H3抖动手持 LoRA,可以为生成画面加入微妙的手持相机晃动,模拟更鲜活、更像纪录片的现场感。
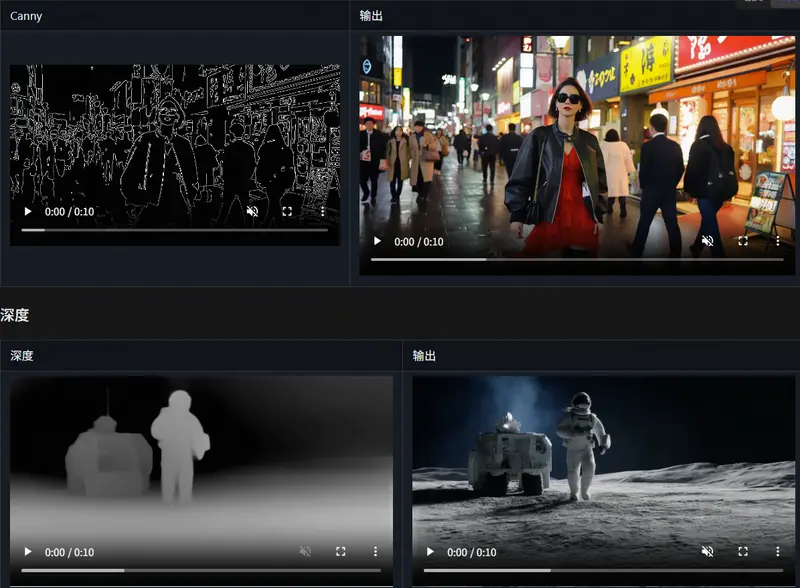
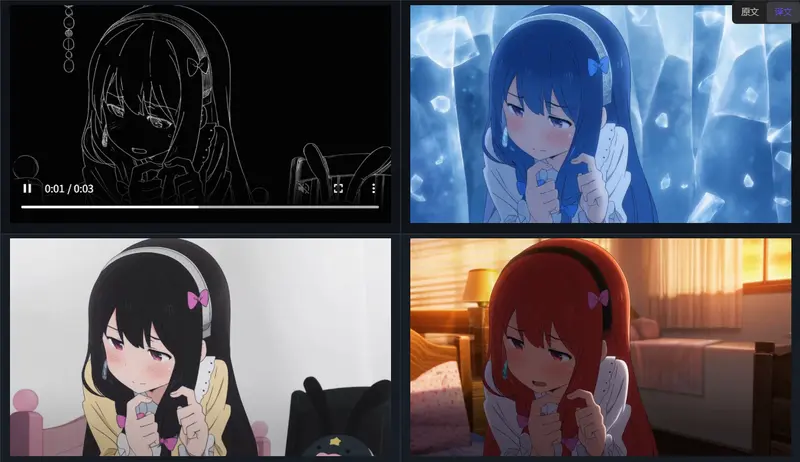
MiniMax-H3-Fun-Controlnet-Union MiniMax-H3-Fun-Controlnet-Union 是一个用于 MiniMax-H3 的 ControlNet-Union 模型,使用 VideoX-Fun 流水线训练而成。单个检查点可使 MiniMax-H3 视频生成器根据 Canny、Depth、HED、MLSD 或 Pose 控制视频进行条件生成,同时也支持视频修复(inpainting)。
ClipProj-MiniMax-H3 MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。
Qwen3-VL-32B Ultra Uncensored Heretic — MiniMax-H3 ComfyUI INT8 ConvRot 社区开发者推出了这款基于 Qwen3-VL-32B-Instruct-ultra-uncensored-heretic 定制的文本/视觉条件编码器。 该检查点经过深度裁剪与 INT8 ConvRot 量化,将原本超过 51 GB 的 BF16 模型压缩至约 24.55 GiB,使其能够在 RTX 5090 (32GB VRAM) 等高端消费级显卡上完成加载与推理,是运行 MiniMax-H3 的推荐版本。
MiniMax-H3 Turbo 4-Step — ComfyUI Pruned-Model LoRAs 此Lora由 larryvrh 创建的原始 MiniMax-H3 Turbo LoRA 的第三方 ComfyUI 兼容性转换版本,专为剪枝/曲线形态 MiniMax-H3 检查点设计。转换解决了原始权重张量键命名空间不匹配导致的加载失败问题,并包含两个进一步训练的 checkpoint-500 变体。所有文件均为部分兼容版本,保留核心注意力与MLP适配器,移除51对AdaLN投影以适配剪枝架构。
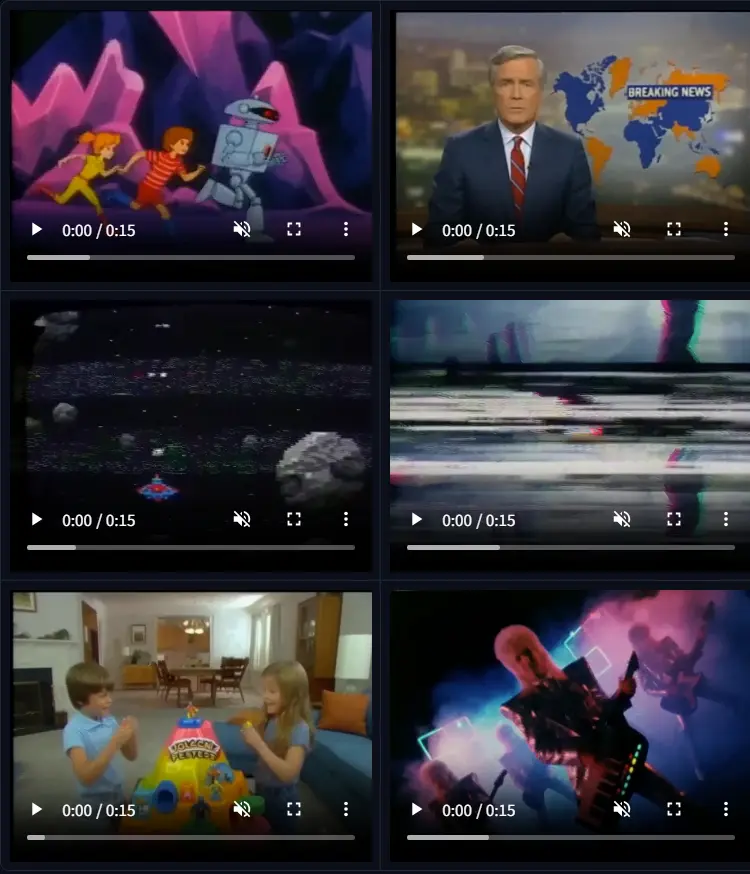
vh5tape 如果你想用 AI 复刻八十年代老旧录像带的复古画面,同时配套生成磁带噪音、沉闷单声道音效,vh5tape 这款社区 LoRA 就是专门为 MiniMax H3 全模态视频模型打造的复古风格工具。不同于普通图像滤镜,它可以做到画面损伤效果与音频磁带质感同步生成,一次性产出完整的 VHS 录像片段。
MiniMax-H3 Fused Turbo (INT8 ConvRot) MiniMax-H3 Fused Turbo 是一个经过深度优化的 21 GB ComfyUI 扩散模型文件,专为 MiniMax H3 视频生成设计。它通过融合蒸馏的 Turbo LoRA 和运动平滑风格 LoRA,并采用 INT8 ConvRot 量化技术,实现了在 4 步内完成高质量的文本/图像到视频(T2V/I2V)及参考到视频(Ref2V)生成。
MiniMax-H3-x-Z-Image-native MiniMax-H3-x-Z-Image-native 是一个将 Z-Image 强大的空间注意力特征移植到 MiniMax H3 引擎上的 ComfyUI 原生版本。该模型旨在通过增强场景的丰富度与纹理细节,同时保持 H3 原有的身份一致性,解决传统视频生成中常见的“逐镜头锐化偏移”问题。
insta-tiktok-aesthetics-h3-lora insta-tiktok-aesthetics-h3-lora 是一款专为 Minimax H3 视频生成模型设计的 LoRA 适配器,复刻 Instagram 和 TikTok 平台上流行的“真实感”视觉美学。它通过微调色彩、构图与动态表现,帮助创作者快速生成符合移动端短视频平台调性的高质量竖屏内容,让 AI 生成的视频更具生活气息与社交传播力。
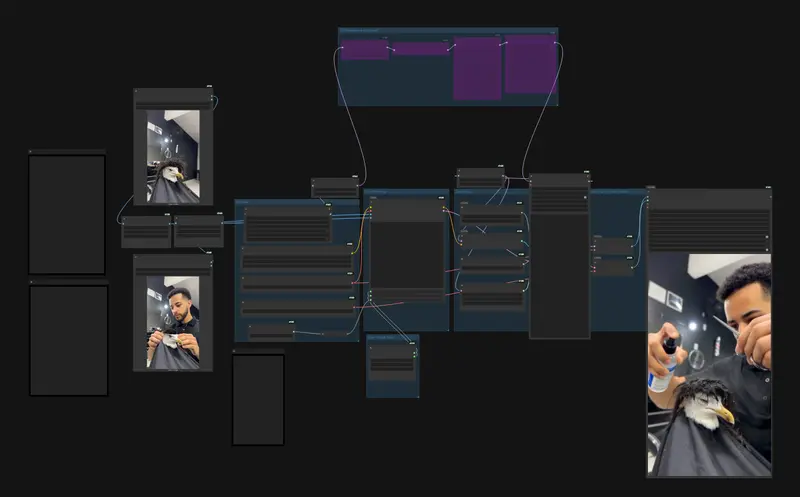
Viggle-Animate Viggle‑Animate 主打一套特殊的视频角色替换方案:只需要把源视频里某一帧画面,在图像编辑器中修改重绘目标角色,就可以把这个新角色完整扩散到整条视频片段。源视频原本的运动轨迹、相机运镜、时间线全部保留不变。
10Eros-Max 10Eros-Max 是一个基于 MiniMax H3 基础模型的实验性分支,旨在通过特征迁移(Feature Transfer)技术,将 LTX 2.3、Wan 2.2 以及 Krea 2 的学习模式融合到 H3 的 Transformer 架构中。该模型在保留 H3 核心音视频生成能力的同时,显著增强了视觉细节、运动连贯性及文本遵循能力。
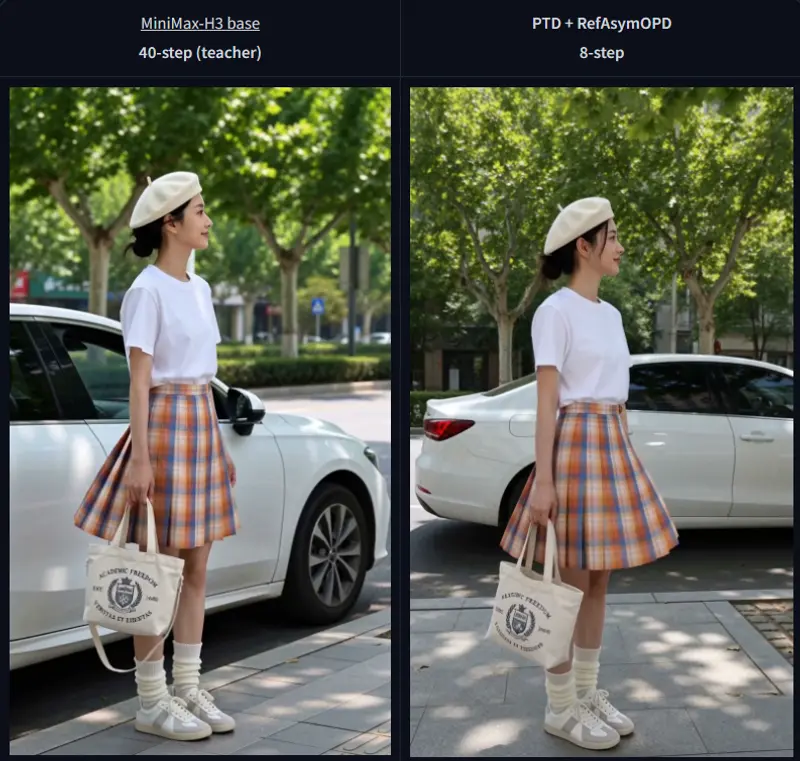
MiniMax-H3-PTD-RefAsymOPD-LoRAs MiniMax-H3 Ref2VA PTD + RefAsymOPD 加速 LoRA 代表了当前参考图像到音视频生成领域的一项高效工程实践。它通过精巧的同策略蒸馏设计,成功打破了“推理速度”与“生成质量”之间的传统权衡,为需要在本地或云端进行高频、高质量 Ref2VA 生成的开发者和创作者,提供了一套低成本、高保真且易于集成的解决方案。