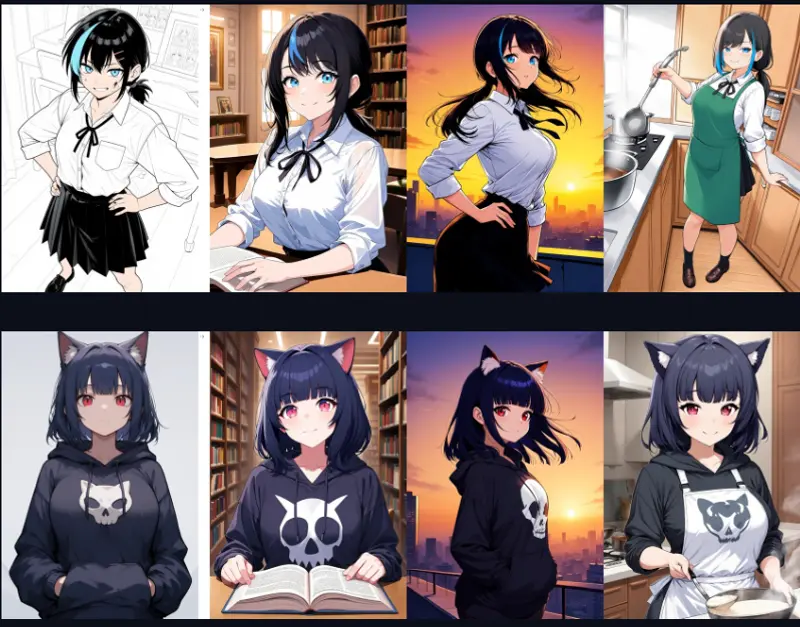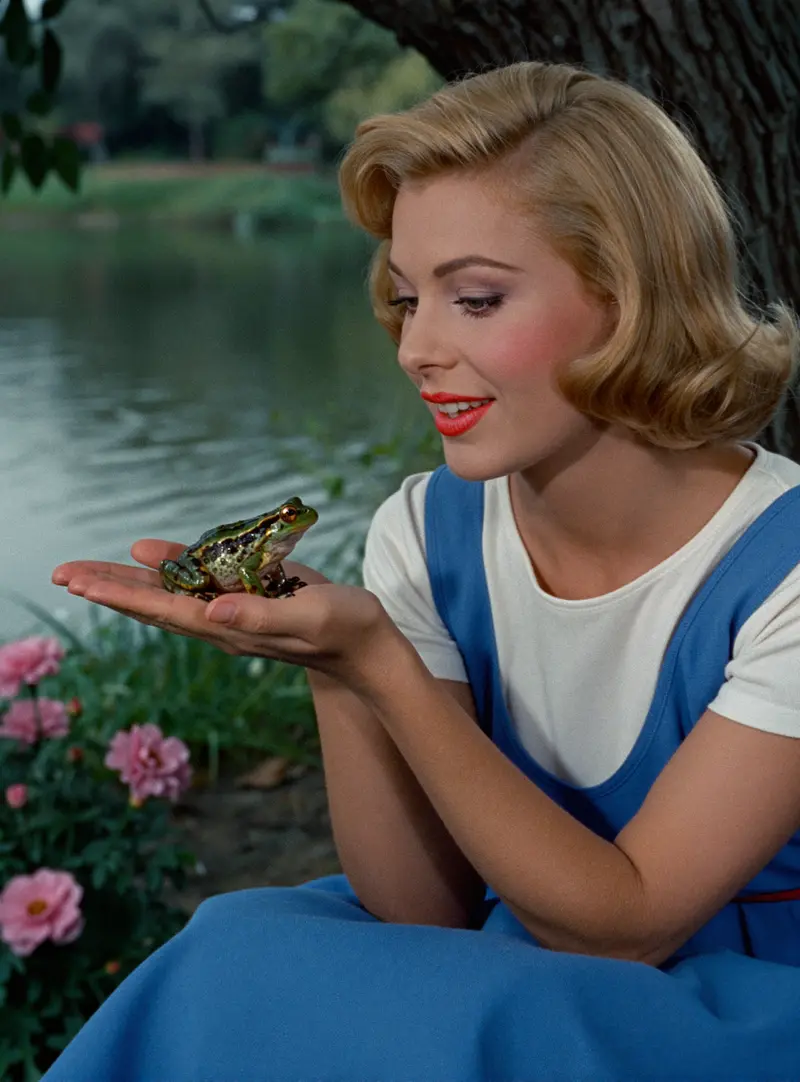
MiniMax-H3-Character-Swap-LoRA
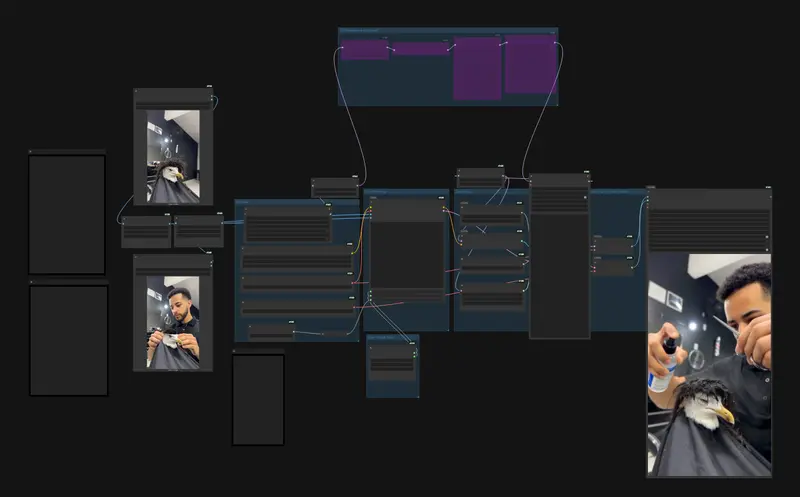
面向MiniMax H3视频模型的专用角色替换LoRA,依托H3 Relay 2.0在ComfyUI搭建端到端工作流,实现“参考图换脸/换角色,保留原视频表演动作”。项目尚在实验阶段,适合短镜头创作,长视频、复杂遮挡场景存在不稳定问题。
Minimax-h3_Singularity 是一款经过深度战略融合与高精度微调的通用多模态视频生成模型。它并非简单的权重叠加,而是基于 ref、fl、b25-49 等关键检查点进行有机融合,并辅以长达 3 天的精确剪枝与权重优化,旨在彻底解决高步数训练带来的伪影问题,同时保留原始模型的强大泛化能力。
Minimax‑h3_Singularity 是一款针对 MiniMax‑H3 的综合性微调融合模型,目标全方位强化原生H3的视频生成表现。原生适配 ComfyUI,完整支持文生视频T2V、图生视频I2V、参考图生视频Ref2V、视频转视频V2V全套工作流。
模型构建思路:对 ref、fl、b25‑49 等多组关键检查点做策略性融合,再执行高步数深度微调。高步数训练容易引入画面伪影,项目专门投入3天时间做精细剪枝与权重调优,在保住原生模型泛化能力的前提下,输出画面锐利、动态表现力强的视频结果。
想要在几乎不损失画质的前提下实现极速推理,推荐搭配:minimax_h3_ref2v_turbo_4step_v0.1,开启4步快速生成。
提示:该模型为融合微调版本,直接替换原有H3权重即可接入已有工作流,原有采样、VAE等配置可沿用。
WarmBloodAban/Minimax-h3_Singularity 的 GGUF 量化版本,这是一个 MiniMax H3 的社区微调,专门增强视觉保真度——HDR 清晰度、远处人脸修复、更干净的皮肤、更强的动作运动和改善的 VFX。这些量化降低了 VRAM 需求,以便与 ComfyUI 一起使用,从而在消费级 GPU 上进行本地推理。
| 属性 | 值 |
|---|---|
| 基础模型 | WarmBloodAban/Minimax-h3_Singularity |
| 基础架构 | MiniMax-H3 联合音视频扩散 transformer |
| 文件格式 | GGUF |
| 量化 | K-quant / Q8_0,敏感层以 F32 保留 |
| 许可证 | MiniMax H3 Community License Agreement |
| 文件 | 大小 | 说明 |
|---|---|---|
| Minimax-H3-Singularity-Q3_K_M.gguf | 8.9 GB | 最小、最快;有一些质量损失 |
| Minimax-H3-Singularity-Q4_K_S.gguf | 11.6 GB | 适合 12 GB GPU 的良好平衡 |
| Minimax-H3-Singularity-Q4_K_M.gguf | 11.6 GB | 推荐用于 12 GB GPU |
| Minimax-H3-Singularity-Q5_K_S.gguf | 14.1 GB | 更好质量,16 GB GPU |
| Minimax-H3-Singularity-Q5_K_M.gguf | 14.1 GB | 推荐用于 16 GB GPU |
| Minimax-H3-Singularity-Q6_K.gguf | 16.7 GB | 高质量,24 GB GPU |
| Minimax-H3-Singularity-Q8_0.gguf | 21.6 GB | 近乎无损,24 GB+ GPU |
将下载的 .gguf 文件放入你的 ComfyUI models/unet/ 目录(或 models/diffusion_models/,取决于你的 ComfyUI-GGUF 分支)。你还需要以下组件:
| 组件 | 来源 |
|---|---|
| 文本编码器 | qwen3vl_32b_minimax_h3_Q4_K_M.gguf 来自 Abiray/MiniMax-H3-GGUF |
| 视频 VAE | minimax_h3_video_vae_fp16.safetensors 来自 Comfy-Org/MiniMax-H3 |
| 音频 VAE | minimax_h3_audio_vae_fp32.safetensors 来自 Comfy-Org/MiniMax-H3 |
为了加速生成,你可以选择将此模型与 minimax_h3_ref2v_turbo_4step_v0.1 LoRA 搭配,从而启用 4 步快速推理。
| GPU VRAM | 推荐量化 |
|---|---|
| 12 GB | Q4_K_M |
| 16 GB | Q5_K_M |
| 24 GB | Q6_K 或 Q8_0 |