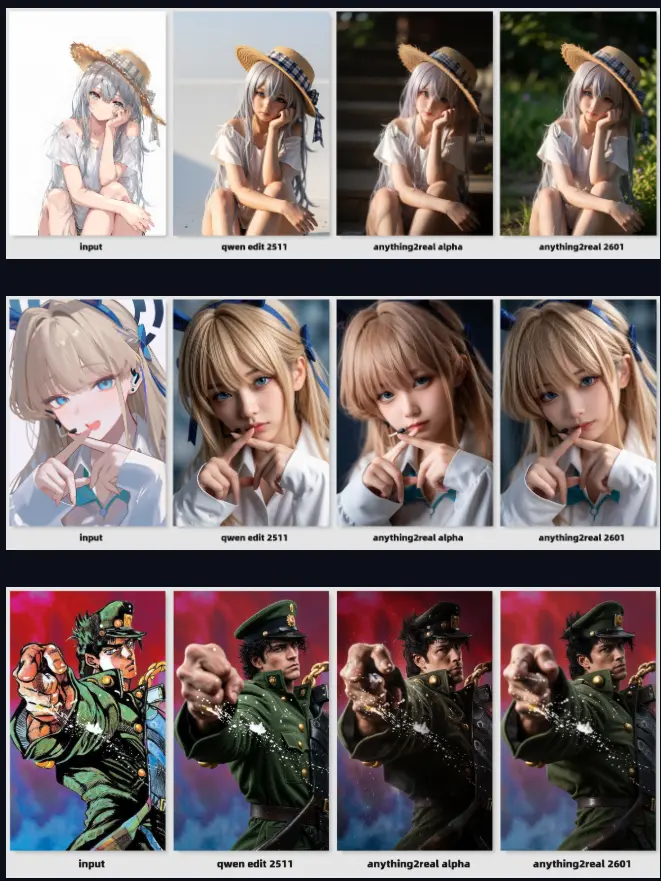
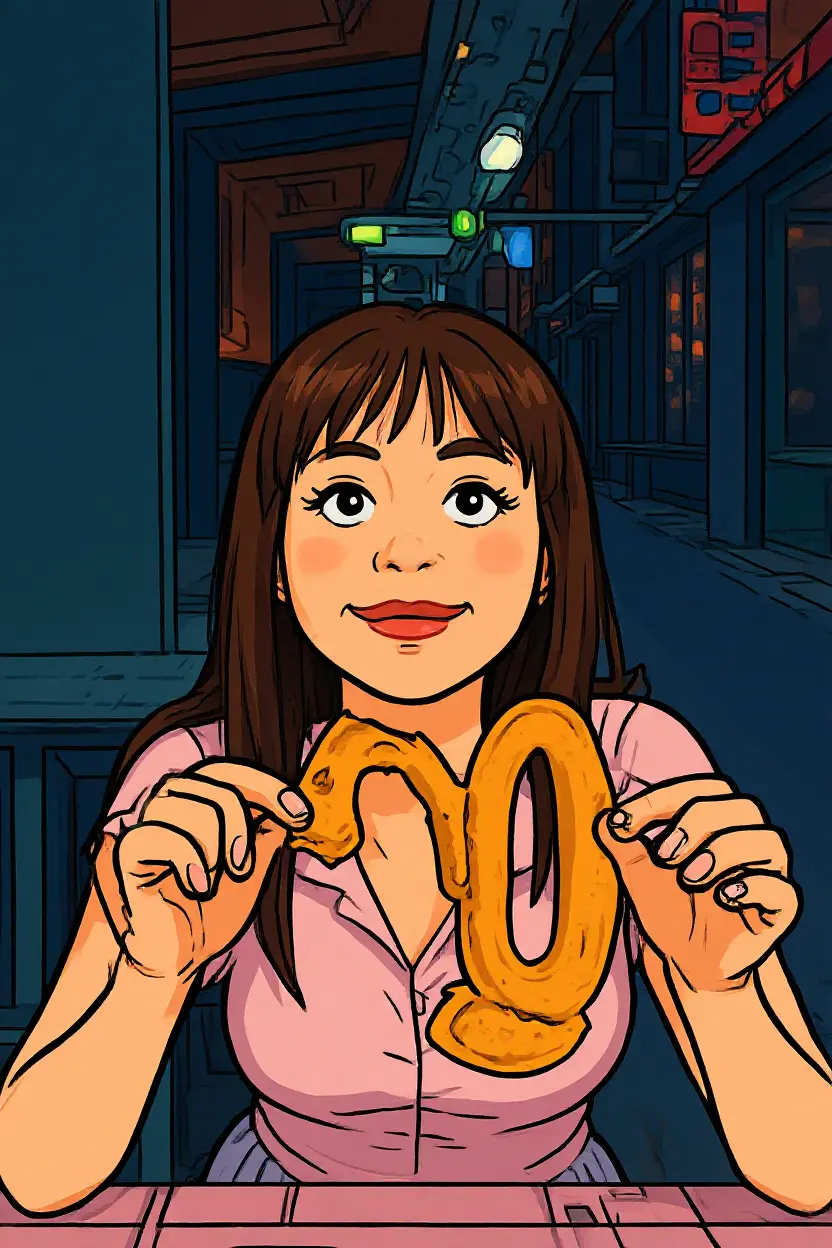
Anything2Real Anything2Real LoRA,基于阿里最新 Qwen Edit 2511(mmdit 编辑模型) 构建,专为非写实图像到写实照片的风格迁移而设计。无论是二次元角色、儿童绘本、概念草图,还是抽象绘画,它都能在不破坏内容结构的前提下,生成具有摄影质感的输出。
insta-tiktok-aesthetics-h3-lora insta-tiktok-aesthetics-h3-lora 是一款专为 Minimax H3 视频生成模型设计的 LoRA 适配器,复刻 Instagram 和 TikTok 平台上流行的“真实感”视觉美学。它通过微调色彩、构图与动态表现,帮助创作者快速生成符合移动端短视频平台调性的高质量竖屏内容,让 AI 生成的视频更具生活气息与社交传播力。
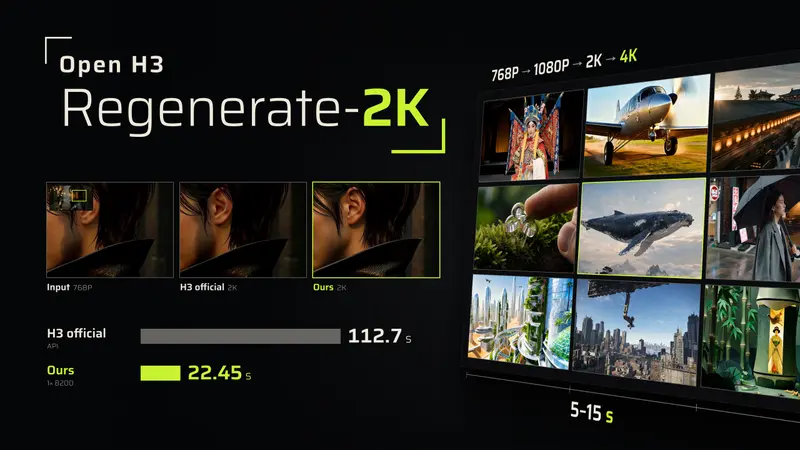
Open-H3-Regenerate-2K Open-H3-Regenerate-2K 由英伟达 Sana 团队推出,是MiniMax H3 闭源 2K 精炼 API 的开源替代方案。官方 H3 仅开放 768P 基础生成权重,2K 高清重绘能力只提供托管 API、不开放权重,这个项目补齐了本地部署的短板:输入任意低分辨率视频草稿,在潜在空间上采样后,只用 3 步扩散重绘,原生输出 2K(2560×1440)甚至 4K 视频。
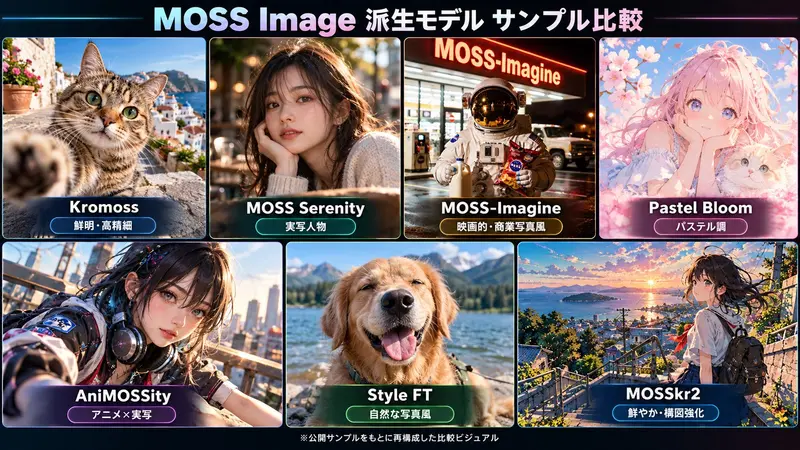
MOSS-Image微调模型合集 MOSS-Image社区已经形成丰富生态,包含全量Checkpoint微调(画质、人像、电影风)、风格FT、DMD2快速采样LoRA,还有MOSSkr2这种零训练注意力嫁接方案;绝大多数模型兼容原有ComfyUI MOSS工作流,直接替换基座即可。
artyvibe_balloons_v2 小时候大家应该都玩过魔术气球,这种气球经过手来回的扭折,可以制作成各式各样有趣的形状,像各种动物、花朵、武器等,今天分享的artyvibe_balloons_v2就是这样的一个Flux模型,使用非常简答的提示词即可创作出不错的作品。
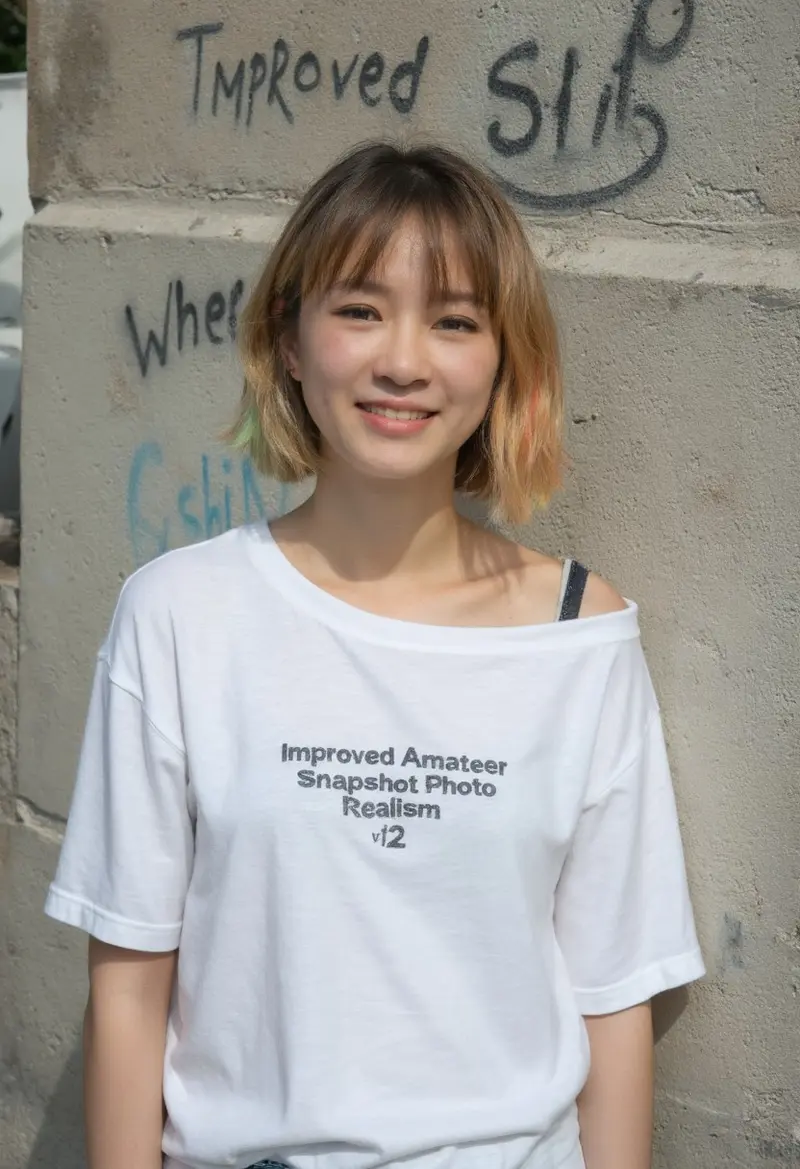
Improved Amateur Snapshot Photo Realism 此Lora旨在生成更“真实”且更少“FLUX 风格”的图像。该模型通过优化自然光和人造光的表现、减少散景强度、为图像的每个部分(如皮肤、眼睛、头发和树叶)添加更多细节。
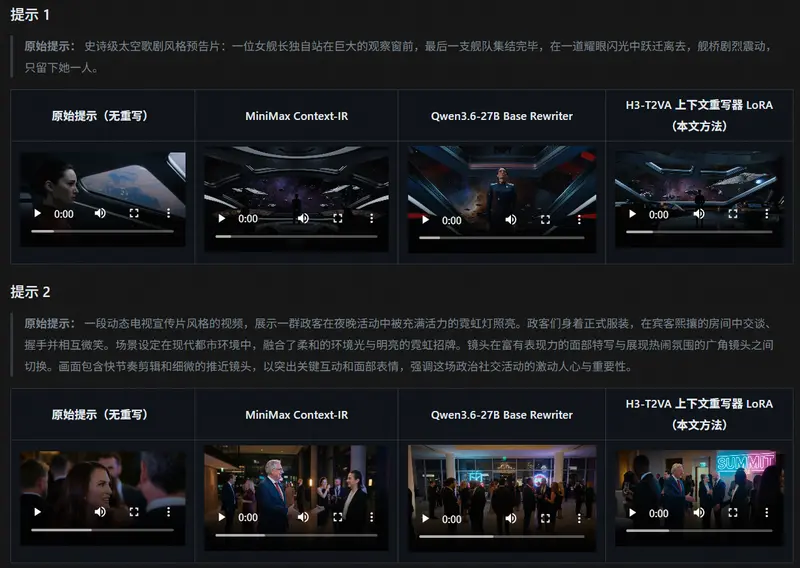
MiniMax-H3 T2VA Prompt Rewriter LoRA lightx2v团队开源的MiniMax-H3 T2VA Prompt Rewriter LoRA是一款基于Qwen3.6-27B微调的LoRA适配器,专为将简短文本提示转换为MiniMax-H3文本生成音视频(T2VA)任务所需的结构化描述而设计。
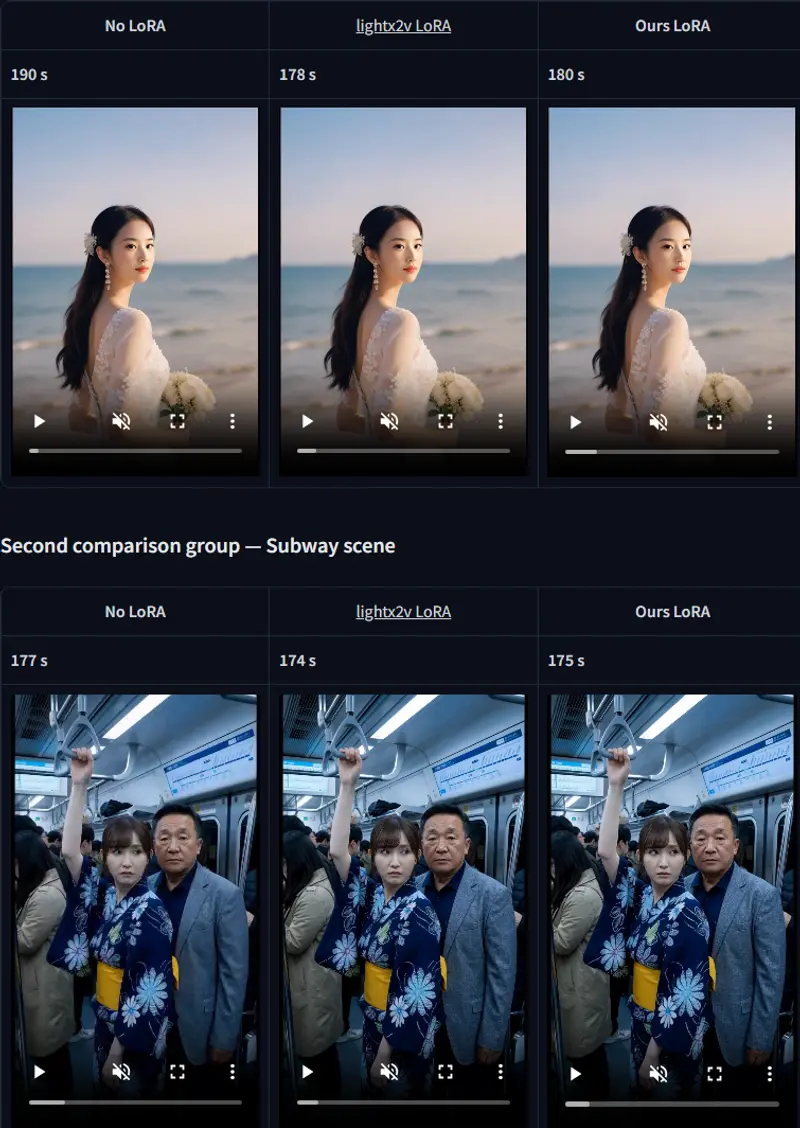
MiniMax H3 Turbo MiniMax H3 Turbo 是一个专为 H3 设计的推理加速 LoRA,它能将文本生成视频(T2V)和图像生成视频(I2V)的采样步数压缩至 4 步,同时保持联合音视频生成的连贯性。
PJ0 QwenImage Realistic FP8 PJ0 QwenImage Realistic FP8 是一次针对性明确的优化迭代,重点提升真实感与细节表现力。结合合理的参数设置,尤其在低 CFG 与优质采样器配合下,能够稳定输出接近专业摄影水准的图像结果,适合写实风格创作者纳入工作流程。
VestalWater’s Illustrious Styles for Qwen Image VestalWater's Illustrious Styles for Qwen Image 是一次对 AI 图像美学方向的主动选择——它不迎合大众审美趋势,而是服务于特定创作者群体的需求:那些希望摆脱“AI塑料感”、追求更具手绘质感与专业实用性的用户。
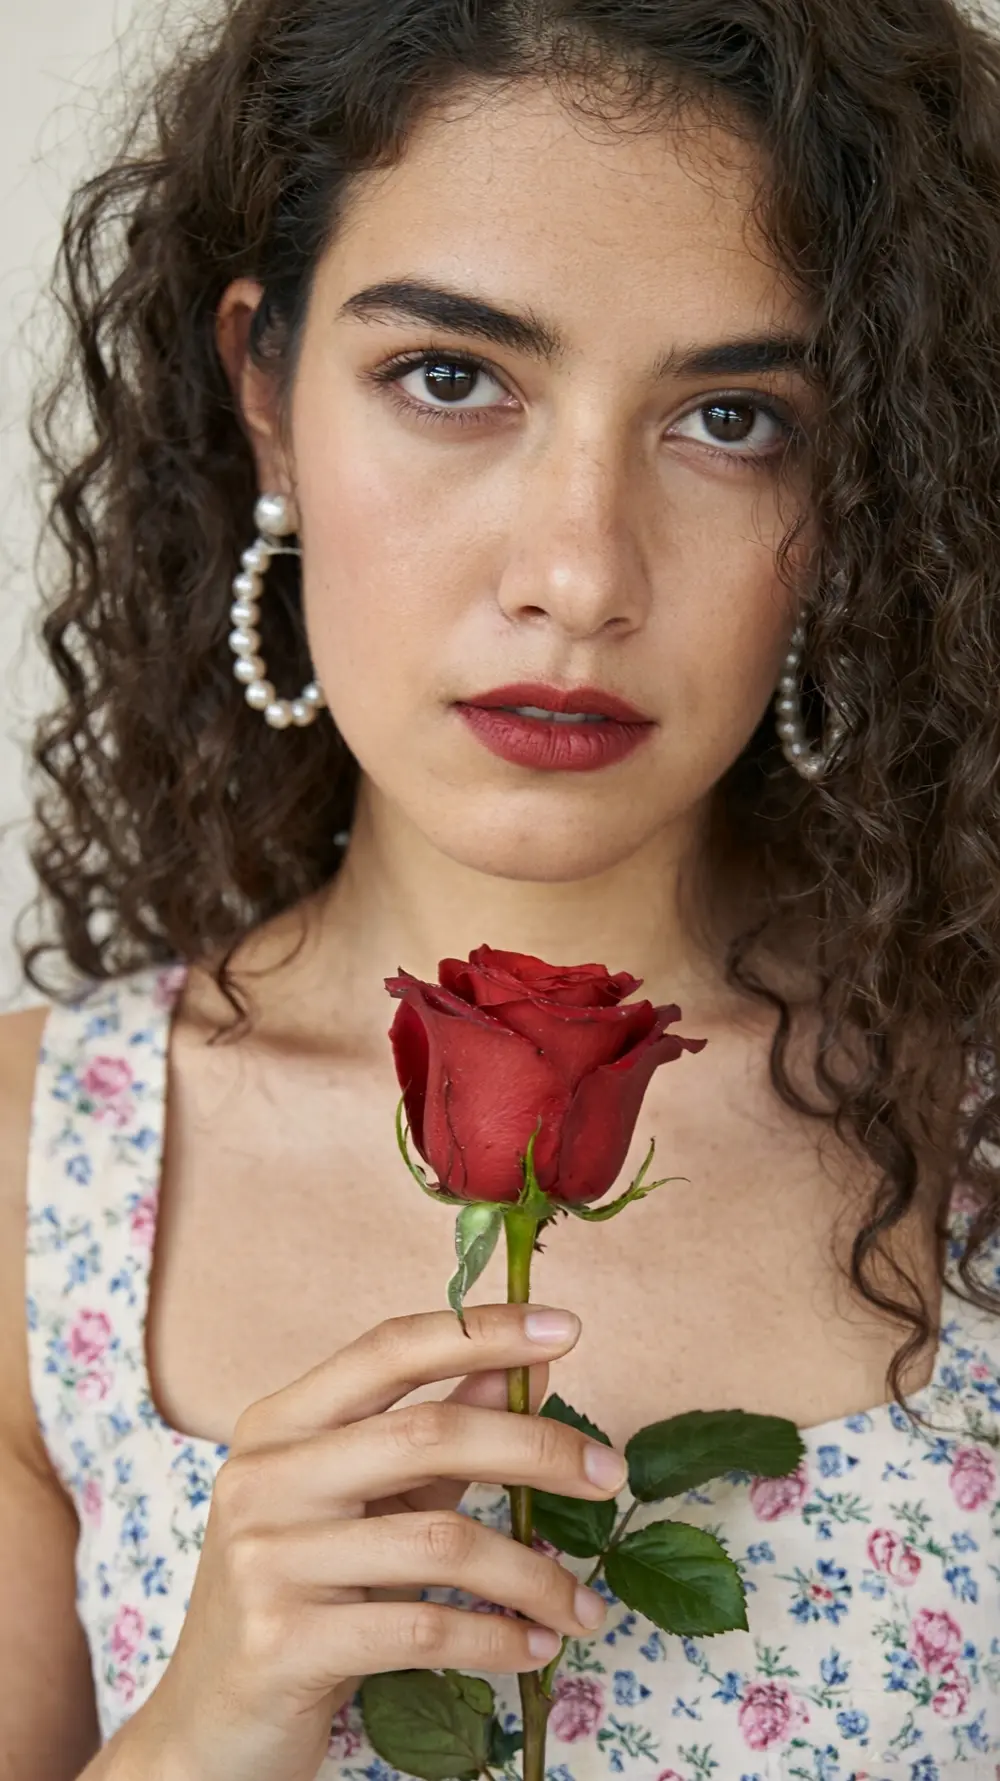
MiniMax-H3-Facial-Realism-CloseUp MiniMax-H3-Facial-Realism-CloseUp 是一款专为 MiniMax H3 模型设计的实验性 LoRA 适配器,显著提升人像特写视频中的面部真实感与微表情细节。
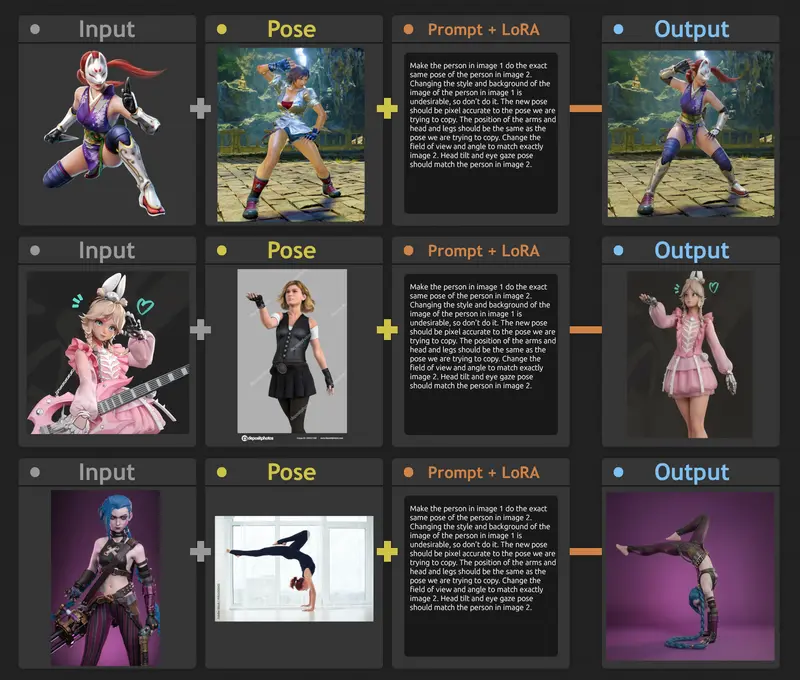
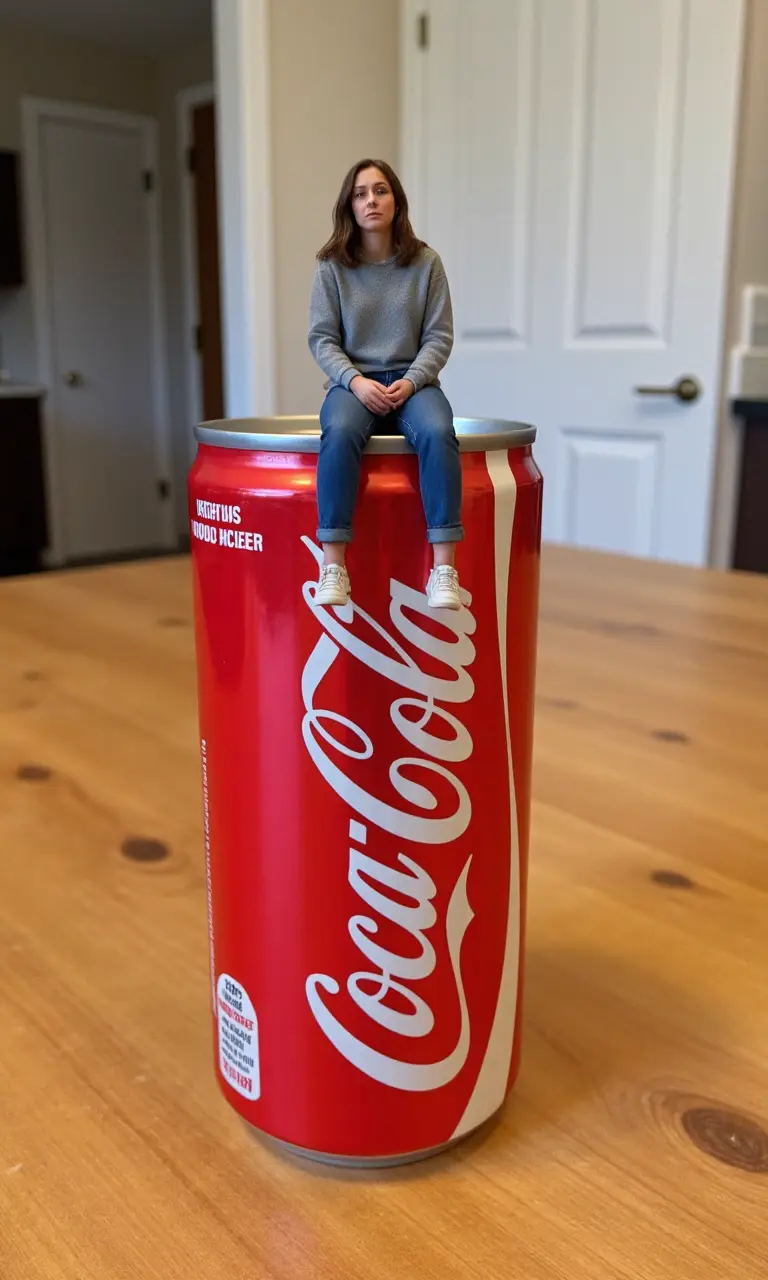
AnyPose AnyPose专为 Qwen Image Edit 2511 Lightning LoRA 设计,无需 ControlNet,无需骨骼图,仅凭一张参考图 + 简单提示词,即可让目标角色精准复刻任意姿势。
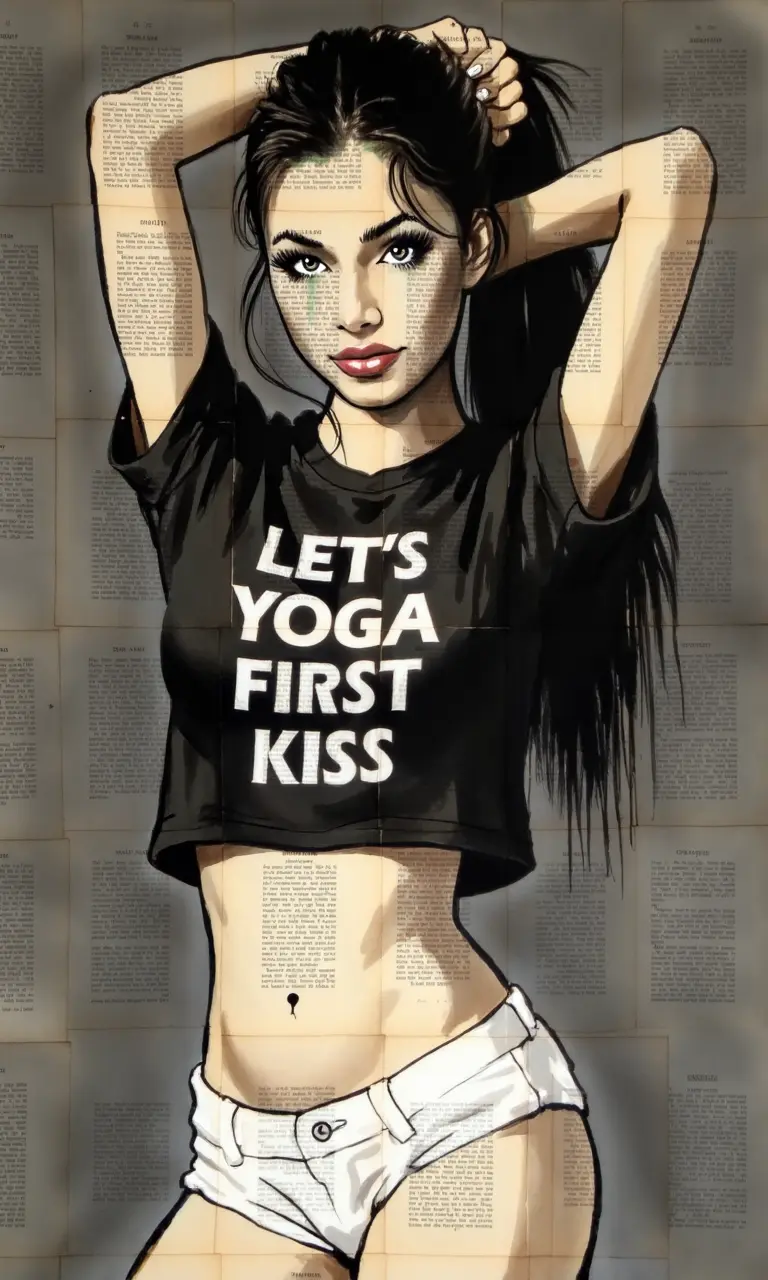
Paint & Print Paint & Print是一款墨水、纸张与表达的融合的Flux LoRA,其灵感来源于一种独特的艺术技法,该技法使用印刷媒体(如旧书、乐谱、报纸、地图)作为画布。这种艺术作品尊重并融合了底层的印刷内容,而不是完全覆盖它,使部分印刷材料隐约可见,将其融入作品中,而不仅仅是作为背景。
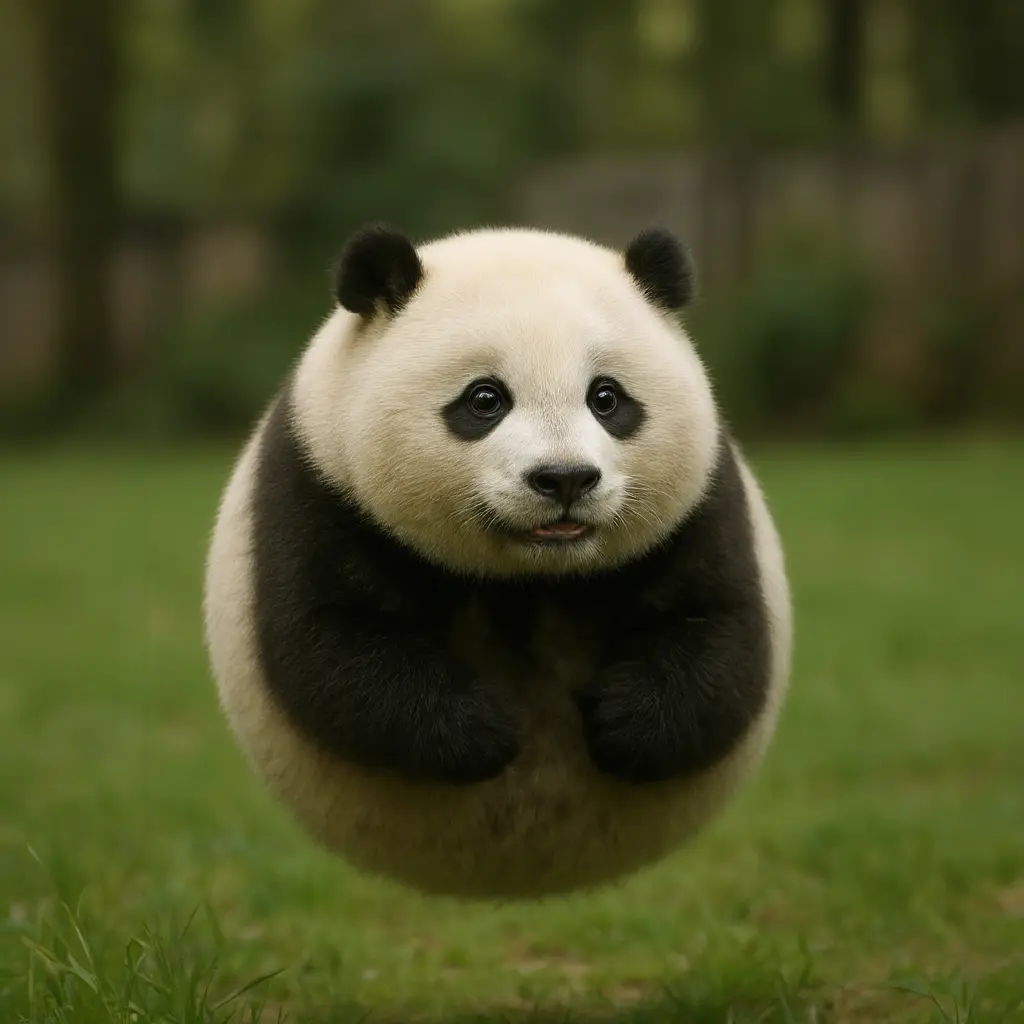
Any Ball AnyBall LoRA 是一个小巧但富有表现力的风格化Lora,用一个简单触发词 an1ball,就能快速进入独特的视觉世界,兼具趣味性与实用性,适合内容创作者、设计师和 AI 艺术探索者。
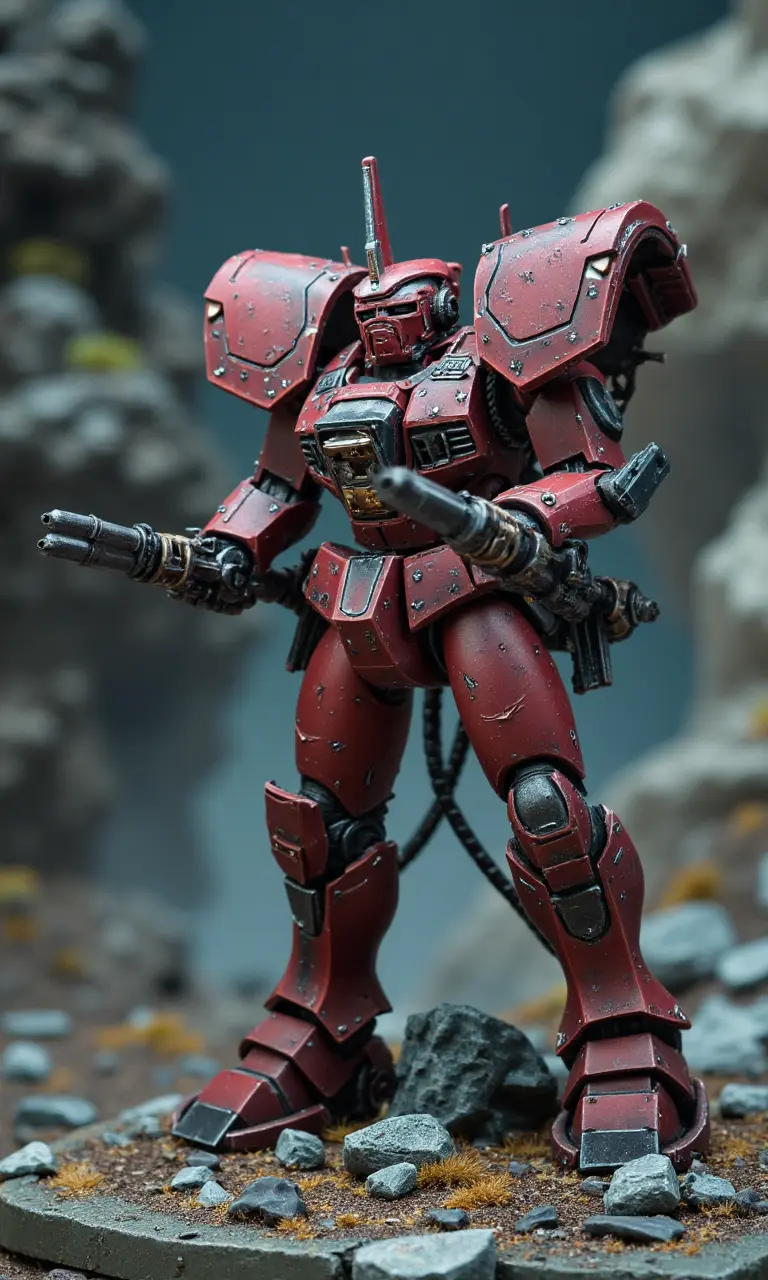
Tabletop Miniatures Tabletop Miniatures是一款桌面微缩模型Flux Lora,自然就是适合出桌面微缩模型图片,再搭配混元或Wan2.1模型来生成视频,效果会非常好。
Kontext_OmniConsistency_lora Kontext_OmniConsistency_lora是一款专为图像生成模型 FLUX.1 Kontext [dev] 打造的 艺术风格 LoRA 模型。该模型艺术风格来自之前介绍的通用一致性模型 OmniConsistency ,专注于将图像转换为 22 种不同艺术风格,同时保持画面内容的一致性。
MiniMax-H3 Fused Turbo (INT8 ConvRot) MiniMax-H3 Fused Turbo 是一个经过深度优化的 21 GB ComfyUI 扩散模型文件,专为 MiniMax H3 视频生成设计。它通过融合蒸馏的 Turbo LoRA 和运动平滑风格 LoRA,并采用 INT8 ConvRot 量化技术,实现了在 4 步内完成高质量的文本/图像到视频(T2V/I2V)及参考到视频(Ref2V)生成。
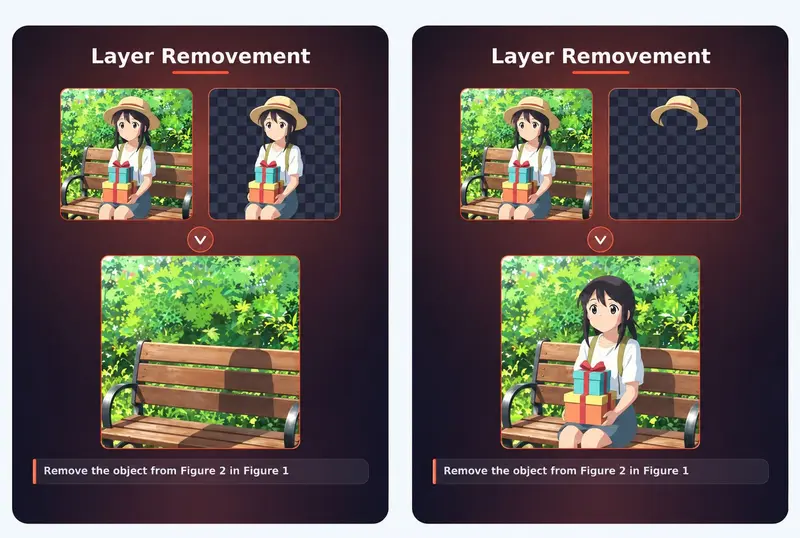
图层移除&图层拆分 阿里DiffSynth-Studio推出配套Qwen-Image-2.1的一对LoRA模型,搭建起一套分层图像编辑管线,把普通平面图片拆解成可独立操作的图层资产,支持物体提取、移除、场景重建,两个LoRA可在DiffSynth-Studio工作流内热插拔切换。