wan2.2-14B-Kinestasis_concept-lora-v1 wan2.2-14B-Kinestasis_concept-lora-v1是基于 Wan2.2-I2V-A14B训练的Lora,专注于生成具有高频场景转换特征的视频序列,适用于创意短片、视觉实验或动态蒙太奇风格内容生成。
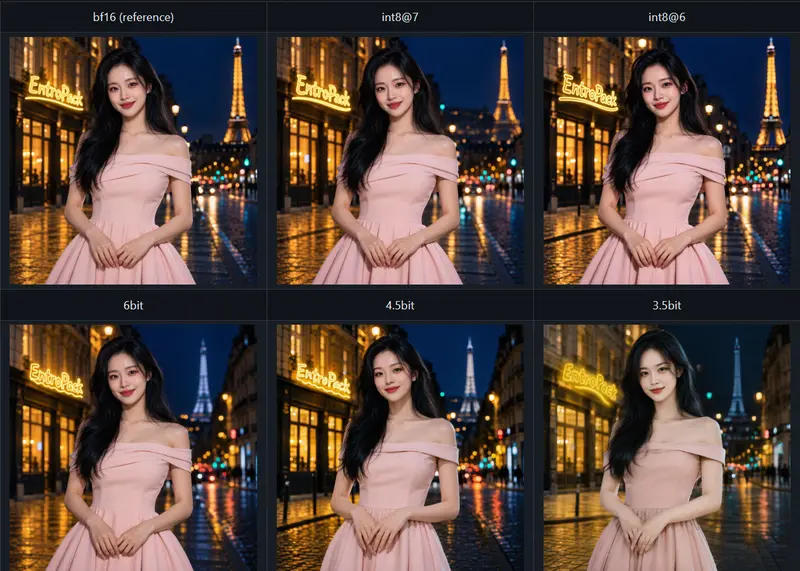
MOSS-Image-EntroPack 阿里DiffSynth-Studio项目组放出MOSS-Image(Base、SFT版本)的EntroPack预量化权重,基于EntroPack熵编码方案从原版BF16权重转换而来,最低仅需4GB显存就能跑,可在DiffSynth-Studio、DiffSynth-ComfyUI加载使用。
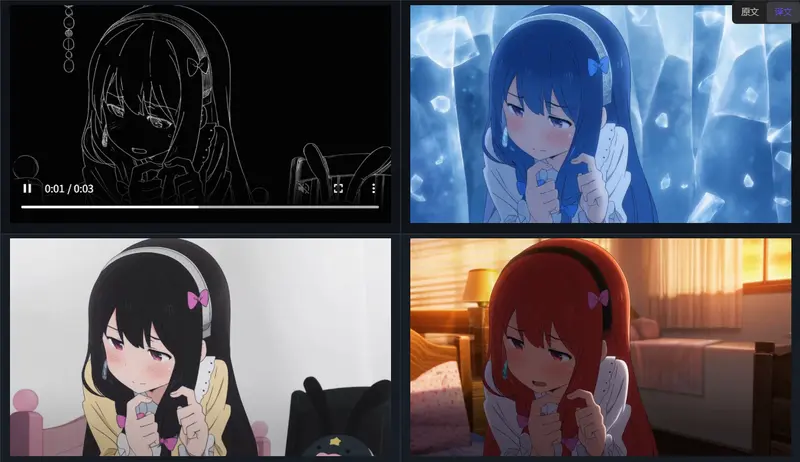
Viggle-Animate Viggle‑Animate 主打一套特殊的视频角色替换方案:只需要把源视频里某一帧画面,在图像编辑器中修改重绘目标角色,就可以把这个新角色完整扩散到整条视频片段。源视频原本的运动轨迹、相机运镜、时间线全部保留不变。
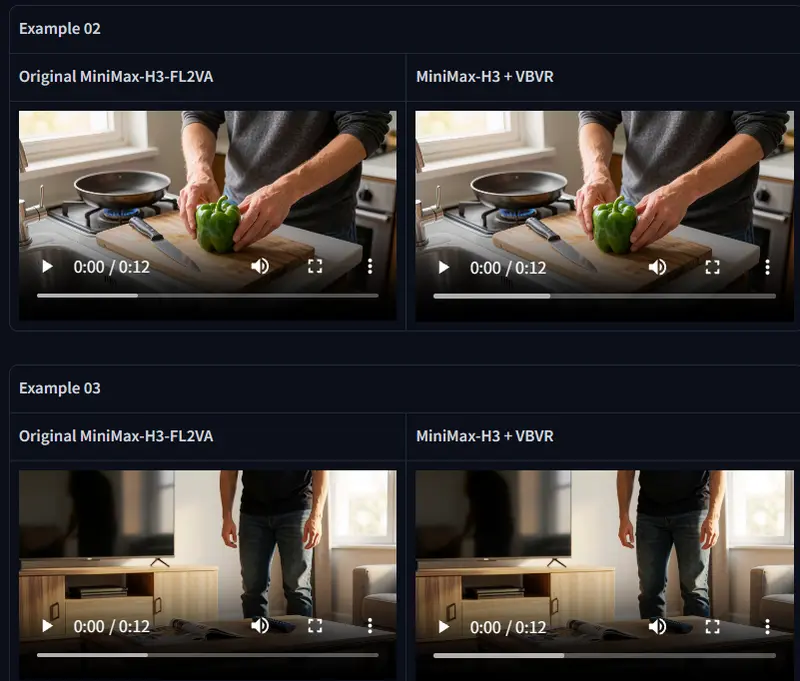
Minimax-H3-VBVR Minimax-H3-VBVR是面向 MiniMax-H3 图生视频(I2V) 的LoRA模型,基于VBVR-Pro-SFT-Video数据集专门做适配重建与重预处理,对齐H3的训练管线,目标解决原生视频生成里常见的空间与物体一致性缺陷。
Kreamagine Kreamagine 是一款基于 Krea-2-Turbo(12.9B 单流 DiT)进行风格适配的微调模型。它保留了基础模型 8 步生成的极速特性,但通过引入 Grok Imagine v0.9/v1.0 的数据集进行训练,显著增强了光照表现力与细节密度。
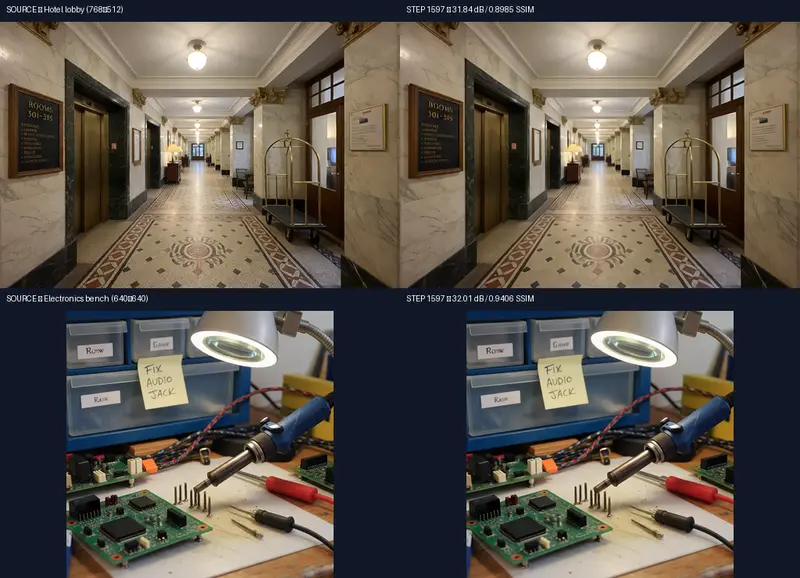
MiniMax-H3-Image-VAE MiniMax H3 的默认 VAE 是为视频设计的,处理单张图像时往往需要凑够时间维度,流程比较繁琐。MiniMax H3 single-image VAE 是一个实验性的专用检查点,它能直接把单个时间步(T=1)的 H3 隐空间解码成一张完整的图片。
PJ0 QwenImage Realistic FP8 PJ0 QwenImage Realistic FP8 是一次针对性明确的优化迭代,重点提升真实感与细节表现力。结合合理的参数设置,尤其在低 CFG 与优质采样器配合下,能够稳定输出接近专业摄影水准的图像结果,适合写实风格创作者纳入工作流程。
MiniMax-H3-Looping-Sketch-Anime MiniMax-H3-Looping-Sketch-Anime专为生成具有循环动画(Looping)效果的手绘草图风格视频而设计,能够将普通的动态场景转化为充满艺术感的粗糙线条与极简色块。
Pruna-Qwen-Image-2.1 Pruna 发布 Pruna-Qwen-Image-2.1,一套面向 Qwen-Image-2.1 的加速LoRA,基于 DMD 蒸馏方案训练,可把原生模型采样步数压缩至5步或8步,最高推理提速6.3倍,支持文生图与图像编辑。
Kontext_OmniConsistency_lora Kontext_OmniConsistency_lora是一款专为图像生成模型 FLUX.1 Kontext [dev] 打造的 艺术风格 LoRA 模型。该模型艺术风格来自之前介绍的通用一致性模型 OmniConsistency ,专注于将图像转换为 22 种不同艺术风格,同时保持画面内容的一致性。
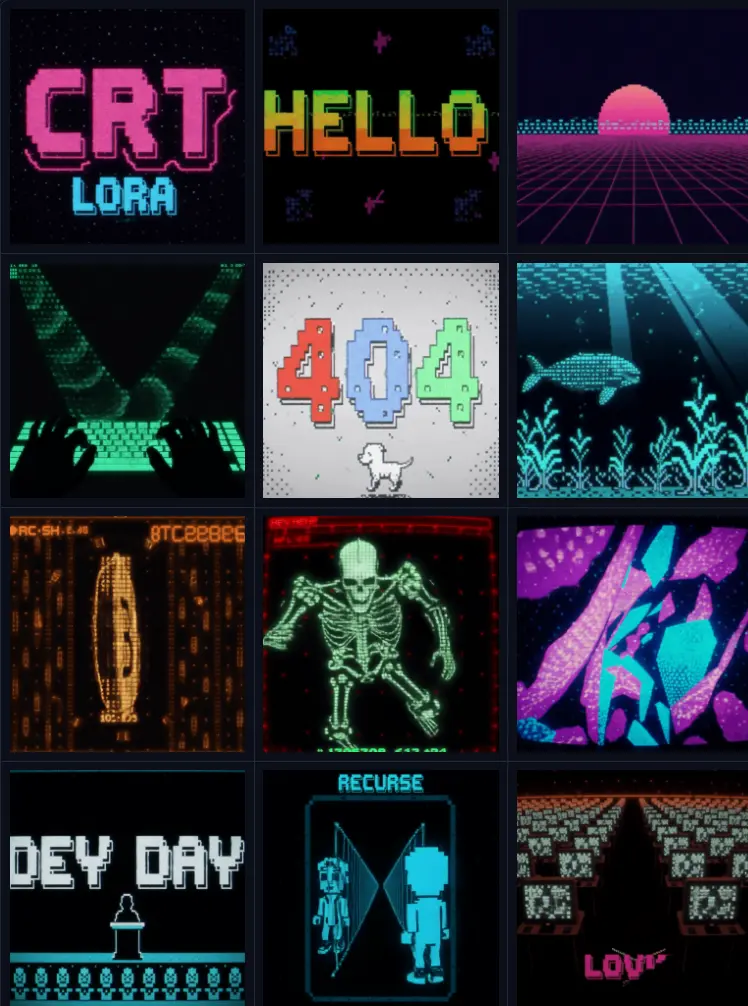
crtanim crtanim 是一款专为 LTX-2.3 22B 视频生成模型设计的开源 LoRA。它能将生成的视频内容完美复刻 80 年代末至 90 年代初的 CRT 显示器美学,包括扫描线、磷光余辉、色差、桶形畸变、信号噪声以及特有的低帧率卡顿感。
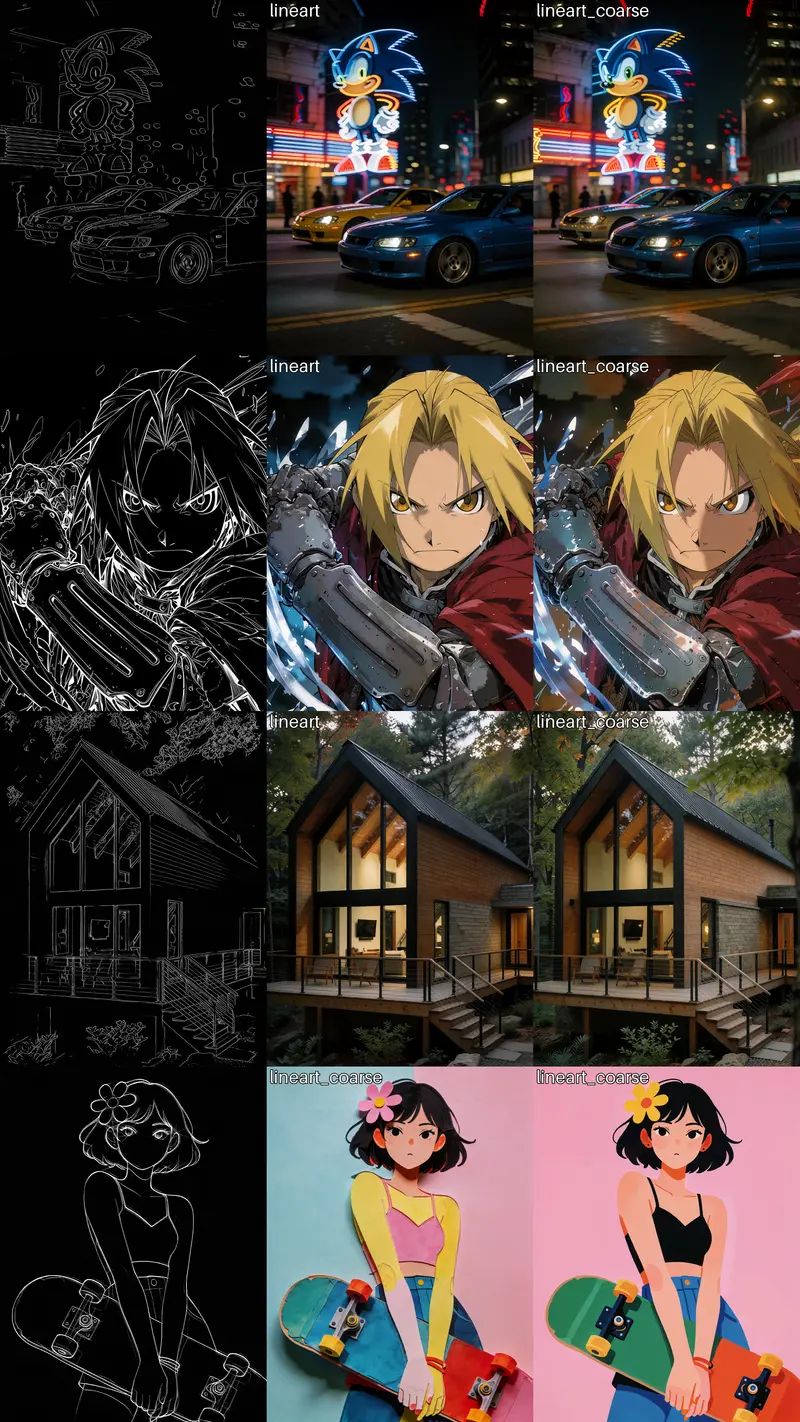
Krea 2 lineart edit Krea 2 Lineart Edit 是一组专为 Krea-2-Raw 模型设计的 LoRA,将简单的线稿草图转化为完全渲染、细节丰富的图像。它完美继承了 Krea 2 强大的编辑能力,让用户能够通过“线条约束 + 文本描述”的方式,精准控制最终画面的构图与风格。
Z-Image-Turbo-Art Z-Image-Turbo-Art是一款由开发者wikeeyang打造的融合微调文生图模型,核心基于Z-Image基座模型与Z-Image-Turbo分层融合后快速微调而成,是探索Z-Image基座模型风格化能力的一次实用尝试。
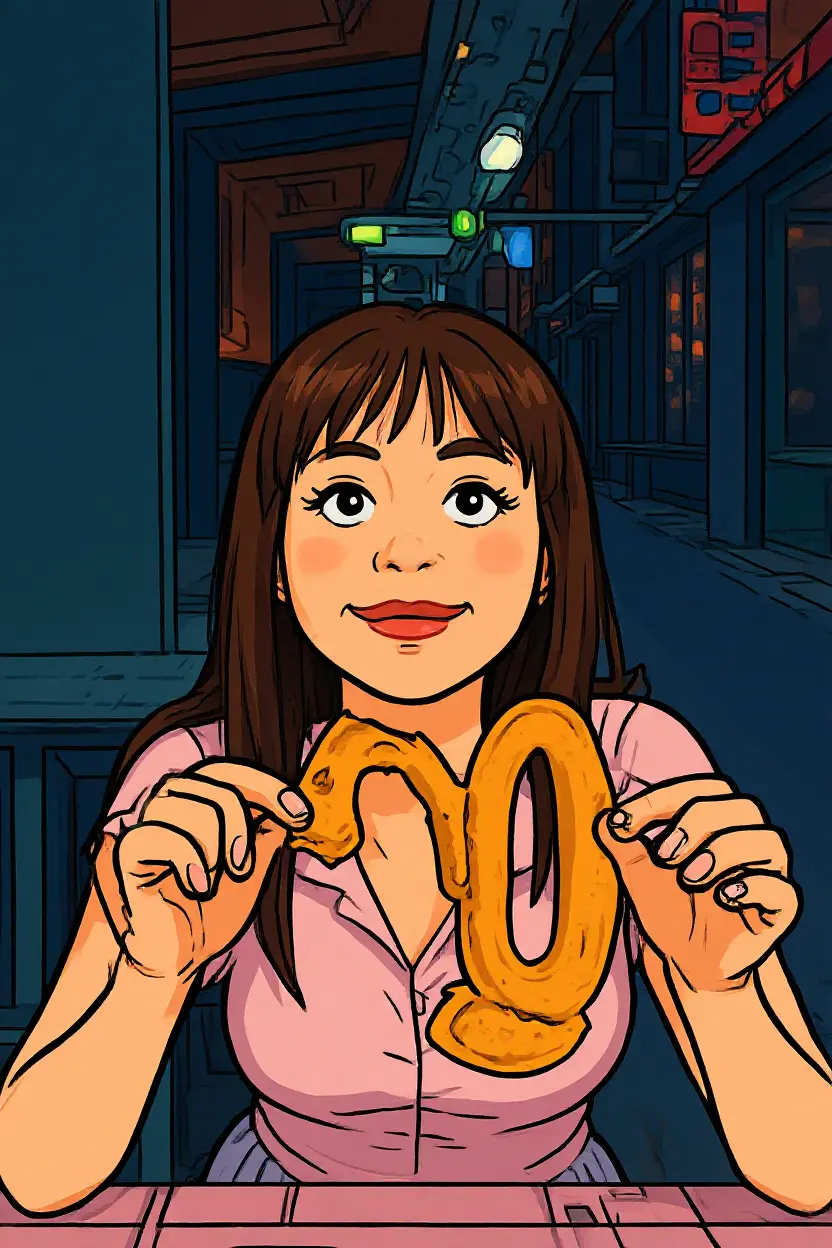
Style-Transfer Style-Transfer 是一款基于 Qwen-Image-Edit-2511 架构的实验性 LoRA 微调模型,专为风格转换与艺术变换设计。它能够将参考图像(如卡通、线稿、插画)的视觉风格精准迁移到源图像(如真人照片)上,同时最大程度保留源图像的结构与构图。
Anima-Light-Lavender Anima-Light-Lavender 是以Anima 系列中的 Anima-Base v1.0为基座、经后训练得到的版本。与基座模型相比,本版本的重点是提升模型对 512 token 量级自然语言描述的理解能力,并借助质量更高的训练数据改善整体生成效果。