nunchaku-flux.1-krea-dev nunchaku-flux.1-krea-dev 的意义在于,它证明了即使在 4-bit 低精度下,扩散模型依然可以生成高质量、富有细节的图像。通过 SVDQuant 与 Nunchaku 推理系统的结合,我们得以在不牺牲太多质量的前提下,大幅降低硬件门
artyvibe_balloons_v2 小时候大家应该都玩过魔术气球,这种气球经过手来回的扭折,可以制作成各式各样有趣的形状,像各种动物、花朵、武器等,今天分享的artyvibe_balloons_v2就是这样的一个Flux模型,使用非常简答的提示词即可创作出不错的作品。
Fix JPEG artifacts compression lora Fix JPEG artifacts compression lora是一款基于图像编辑模型Flux Kontext开发的微调LoRA模型,此模型是用来修复JPEG压缩伪影。
Anima-Light-Lavender Anima-Light-Lavender 是以Anima 系列中的 Anima-Base v1.0为基座、经后训练得到的版本。与基座模型相比,本版本的重点是提升模型对 512 token 量级自然语言描述的理解能力,并借助质量更高的训练数据改善整体生成效果。
Minimax-H3-Turbo Lightx2v团队发布Minimax-H3-Turbo,为MiniMax-H3模型提供推理加速能力。该LoRA支持4步快速生成,推荐配置为0.75强度搭配er_sde或sa_solver调度器。
Hyperdetailed Colored Pencil Hyperdetailed Colored Pencil 是一款专为追求高质量、细节丰富的艺术作品而设计的生成模型。无论是用于创作逼真的肖像画还是探索其他艺术形式,这款模型都能提供令人惊叹的效果。
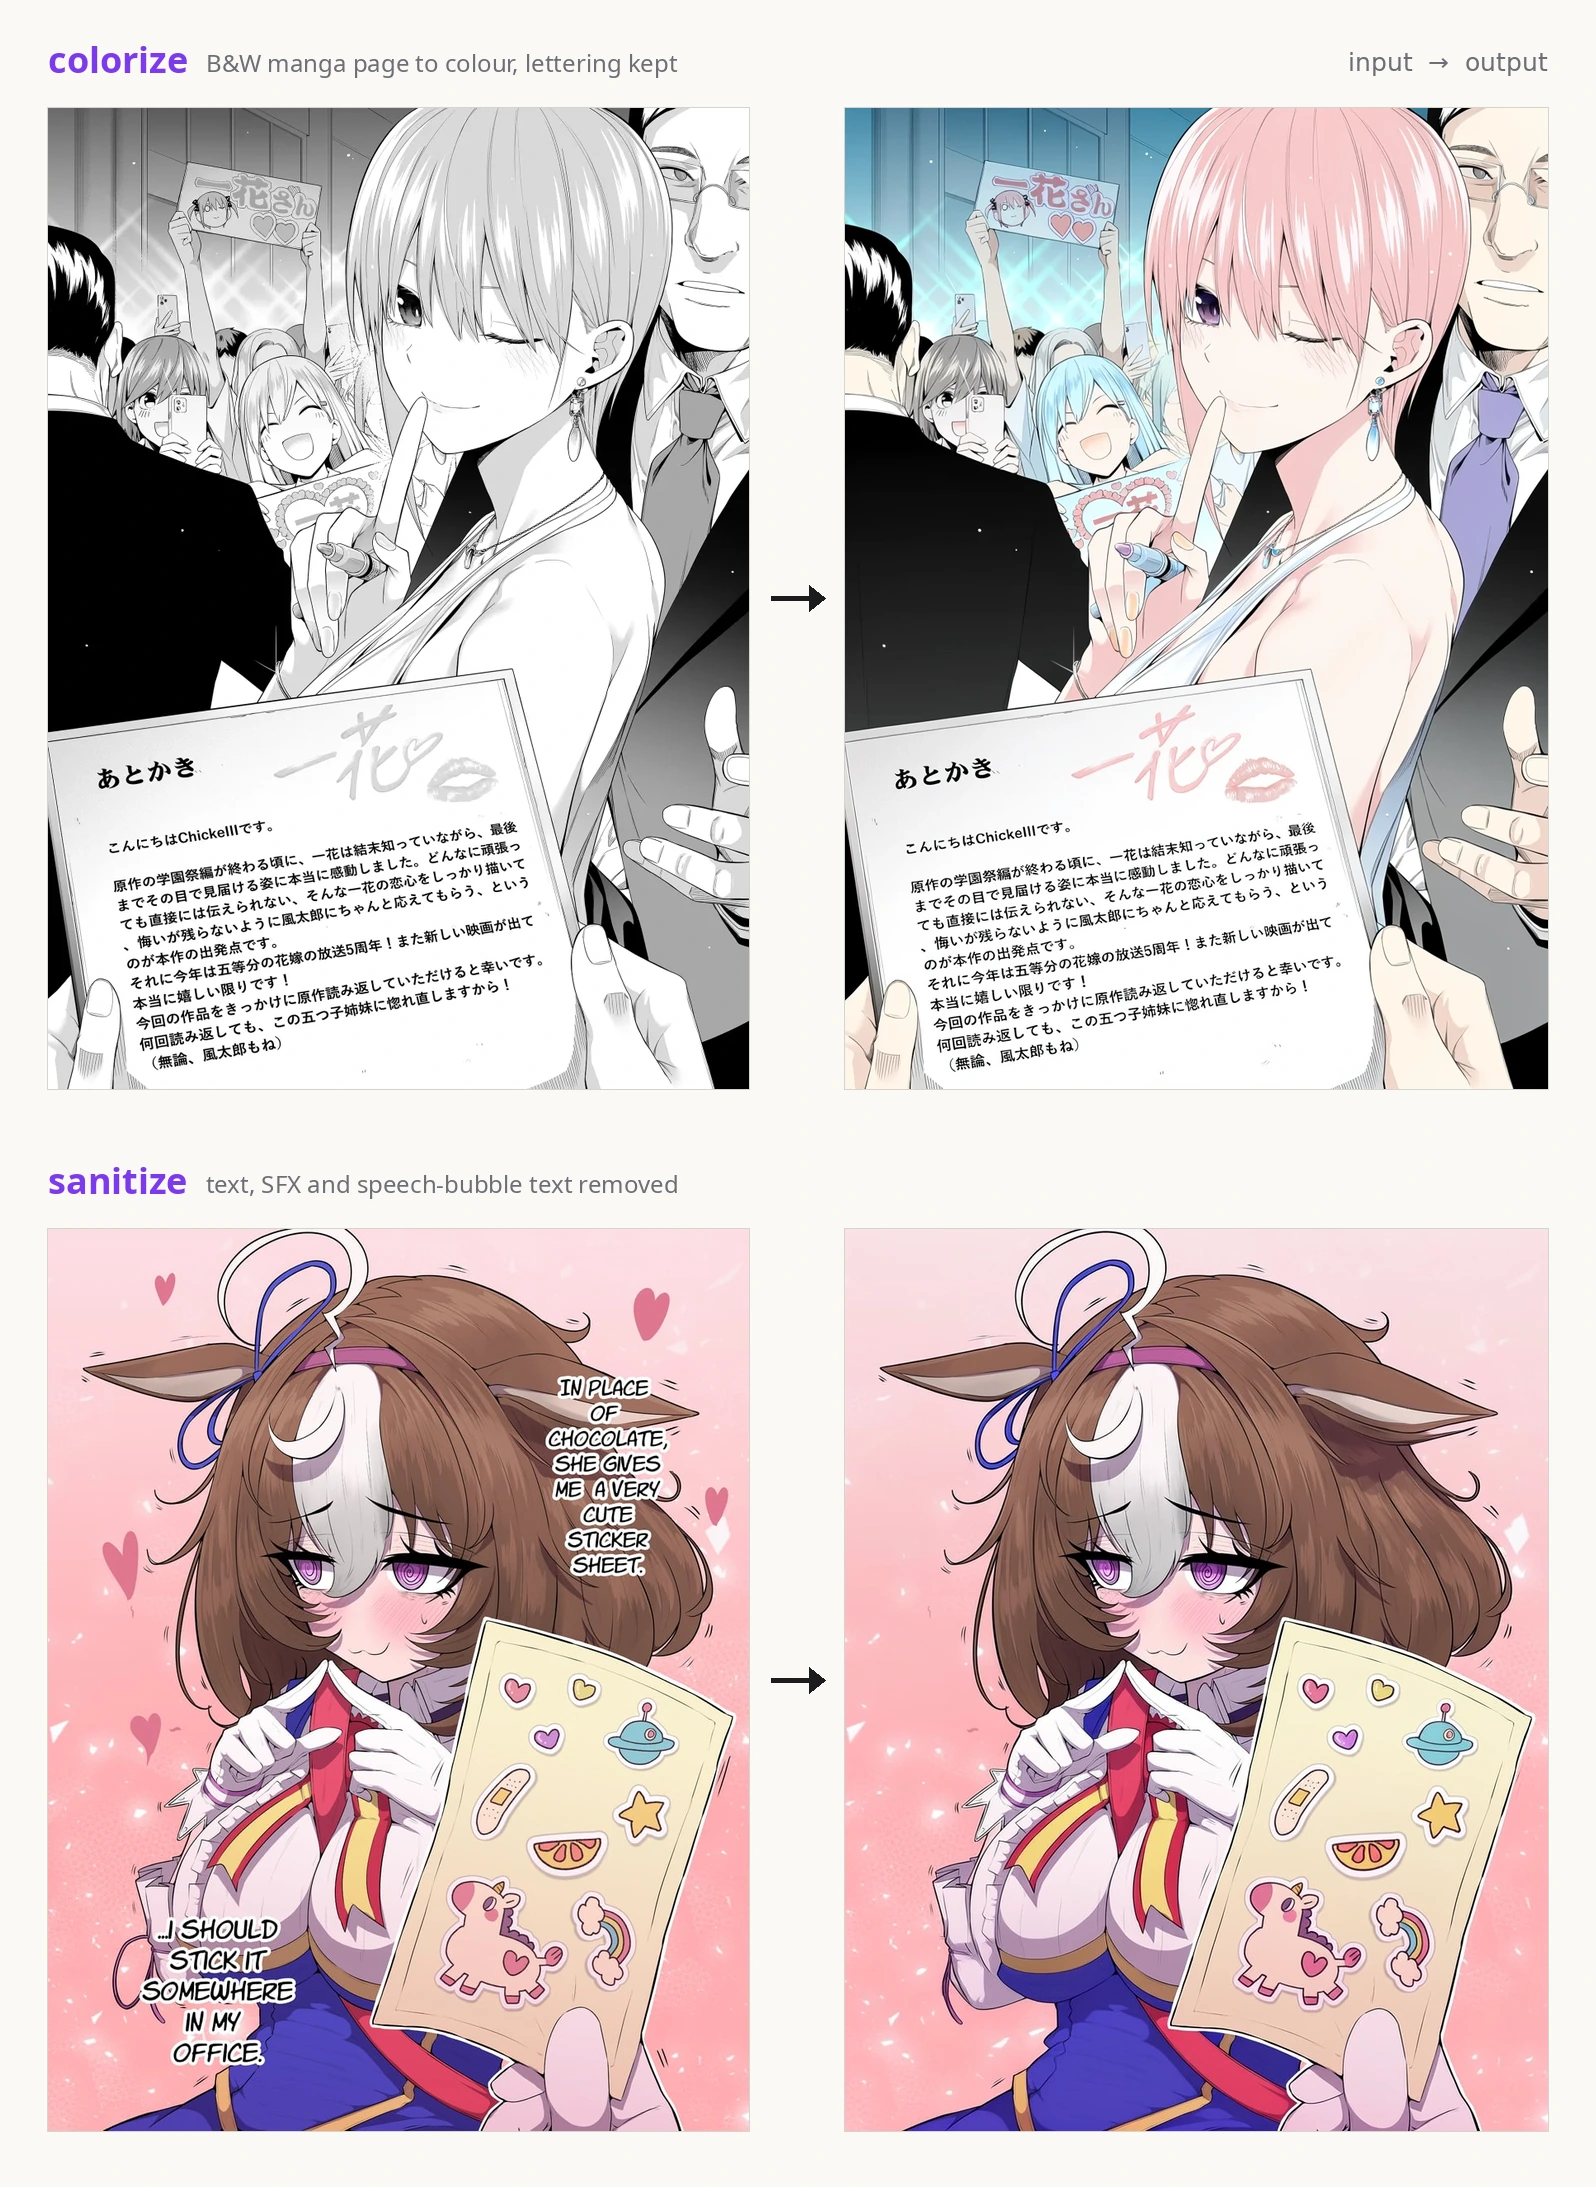
MOSS-Image i2i LoRAs 这套 MOSS-Image i2i LoRA 为 ComfyUI 打造,包含漫画上色、去文字水印、去马赛克三个独立 LoRA;依托 VAE 潜参考图生图,上色版本数据集充足效果更好,去文字、去遮挡版本训练样本偏少。
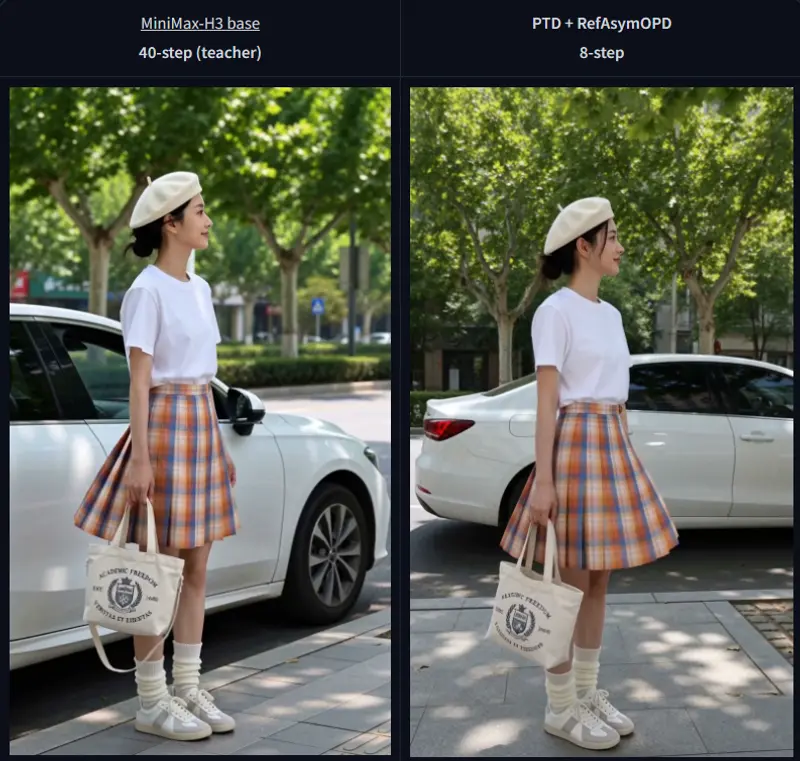
MiniMax-H3-PTD-RefAsymOPD-LoRAs MiniMax-H3 Ref2VA PTD + RefAsymOPD 加速 LoRA 代表了当前参考图像到音视频生成领域的一项高效工程实践。它通过精巧的同策略蒸馏设计,成功打破了“推理速度”与“生成质量”之间的传统权衡,为需要在本地或云端进行高频、高质量 Ref2VA 生成的开发者和创作者,提供了一套低成本、高保真且易于集成的解决方案。
Z-Image-Turbo-Art Z-Image-Turbo-Art是一款由开发者wikeeyang打造的融合微调文生图模型,核心基于Z-Image基座模型与Z-Image-Turbo分层融合后快速微调而成,是探索Z-Image基座模型风格化能力的一次实用尝试。
Qwen3-VL-32B Ultra Uncensored Heretic — MiniMax-H3 ComfyUI INT8 ConvRot 社区开发者推出了这款基于 Qwen3-VL-32B-Instruct-ultra-uncensored-heretic 定制的文本/视觉条件编码器。 该检查点经过深度裁剪与 INT8 ConvRot 量化,将原本超过 51 GB 的 BF16 模型压缩至约 24.55 GiB,使其能够在 RTX 5090 (32GB VRAM) 等高端消费级显卡上完成加载与推理,是运行 MiniMax-H3 的推荐版本。
Flux Kontext Zoom Out LoRA Flux Kontext Zoom Out LoRA 是一款专为图像编辑模型 FLUX.1 Kontext [dev] 训练的 LoRA模型,实现高质量的图像“放大”或“画布外扩”(zoom out)效果。
Any Ball AnyBall LoRA 是一个小巧但富有表现力的风格化Lora,用一个简单触发词 an1ball,就能快速进入独特的视觉世界,兼具趣味性与实用性,适合内容创作者、设计师和 AI 艺术探索者。
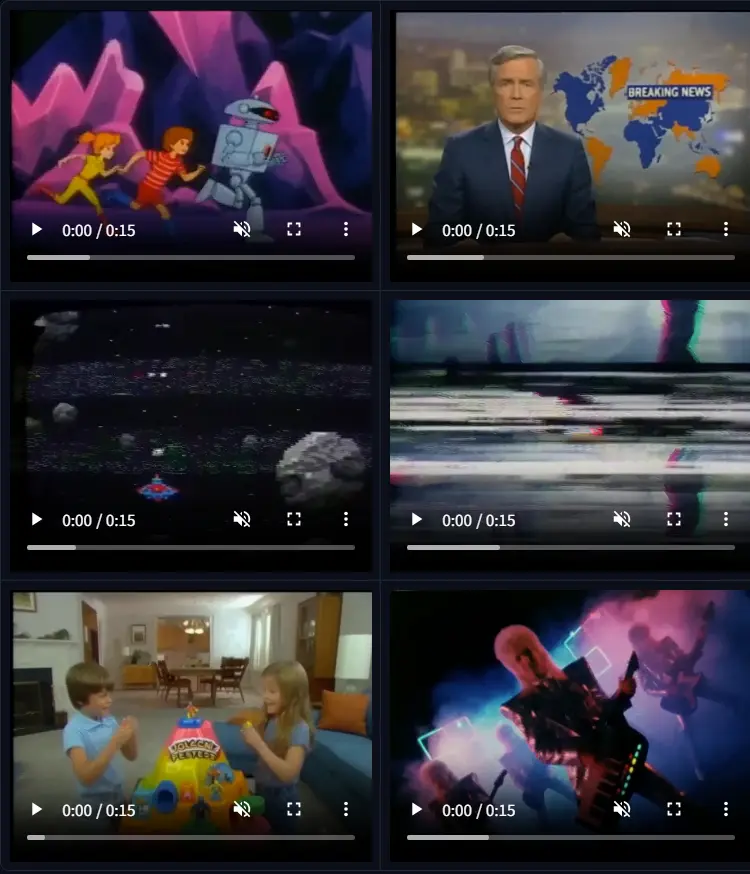
vh5tape 如果你想用 AI 复刻八十年代老旧录像带的复古画面,同时配套生成磁带噪音、沉闷单声道音效,vh5tape 这款社区 LoRA 就是专门为 MiniMax H3 全模态视频模型打造的复古风格工具。不同于普通图像滤镜,它可以做到画面损伤效果与音频磁带质感同步生成,一次性产出完整的 VHS 录像片段。
Live Wallpaper Style Live Wallpaper Style 是一款专为生成动态壁纸风格视频而设计的LoRA,提供了多种版本以满足不同需求,包括 Wan I2V 14B 720P、Wan I2V 14B 480P 和 Hunyuan T2V 版本。
Street Fighter Hodouken I2V Lora 通过 Street Fighter Hadouken I2V LoRA,你可以轻松将《街头霸王》中的经典“波动拳”招式融入你的视频创作中。无论是经典角色还是自定义形象,只需简单的提示词和参数设置,即可实现极具视觉冲击力的动作效果。
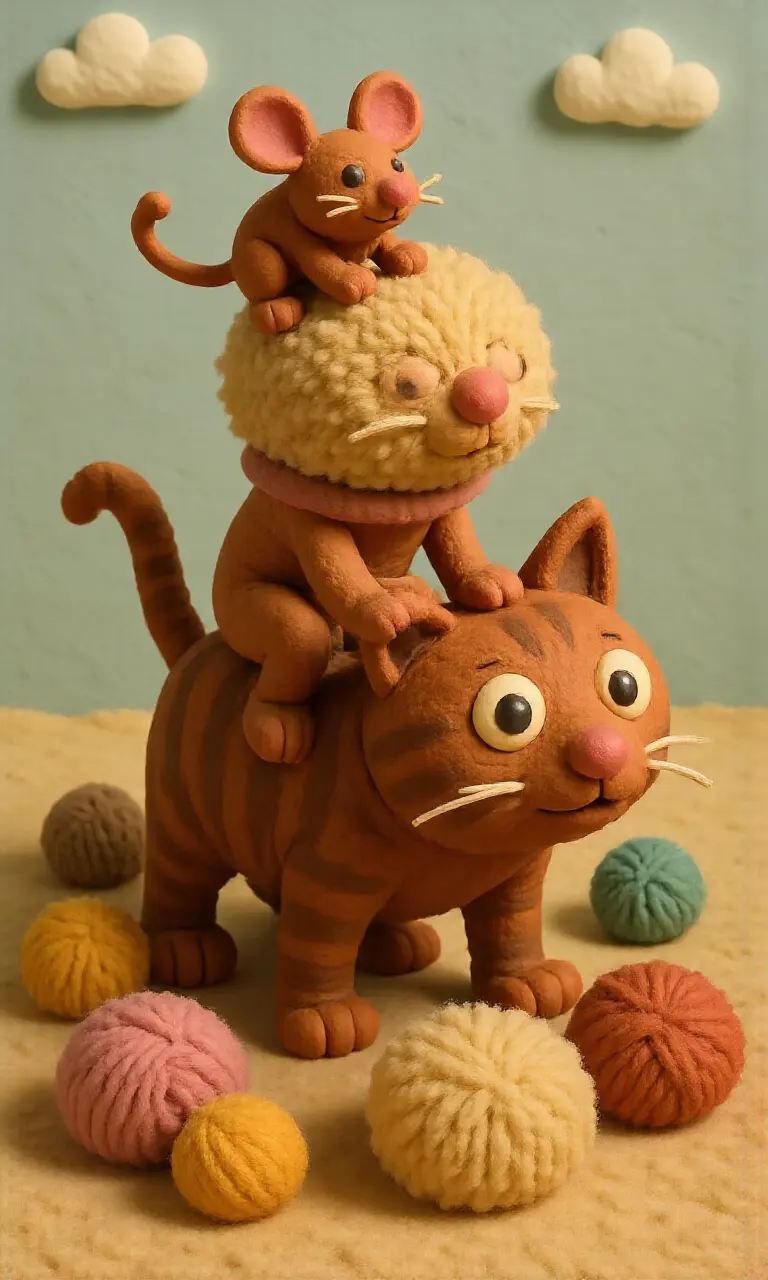
CLAY GPT for flux CLAY GPT for flux 是一个专为 Flux 设计的 LoRA 模型 ,其训练数据完全来自于 GPT-4o 生成的 Clay(黏土)风格图像 。该模型能够帮助用户在文本到图像生成任务中,快速还原出具有手工质感和动画风格的黏土艺术效果。
SDXL Anime VAE Decoder 开发者 Anzhc 推出 SDXL Anime VAE Decoder —— 一个仅对 SDXL 原生 VAE 解码器进行微调 的轻量模型,专为提升动漫图像生成质量而设计。