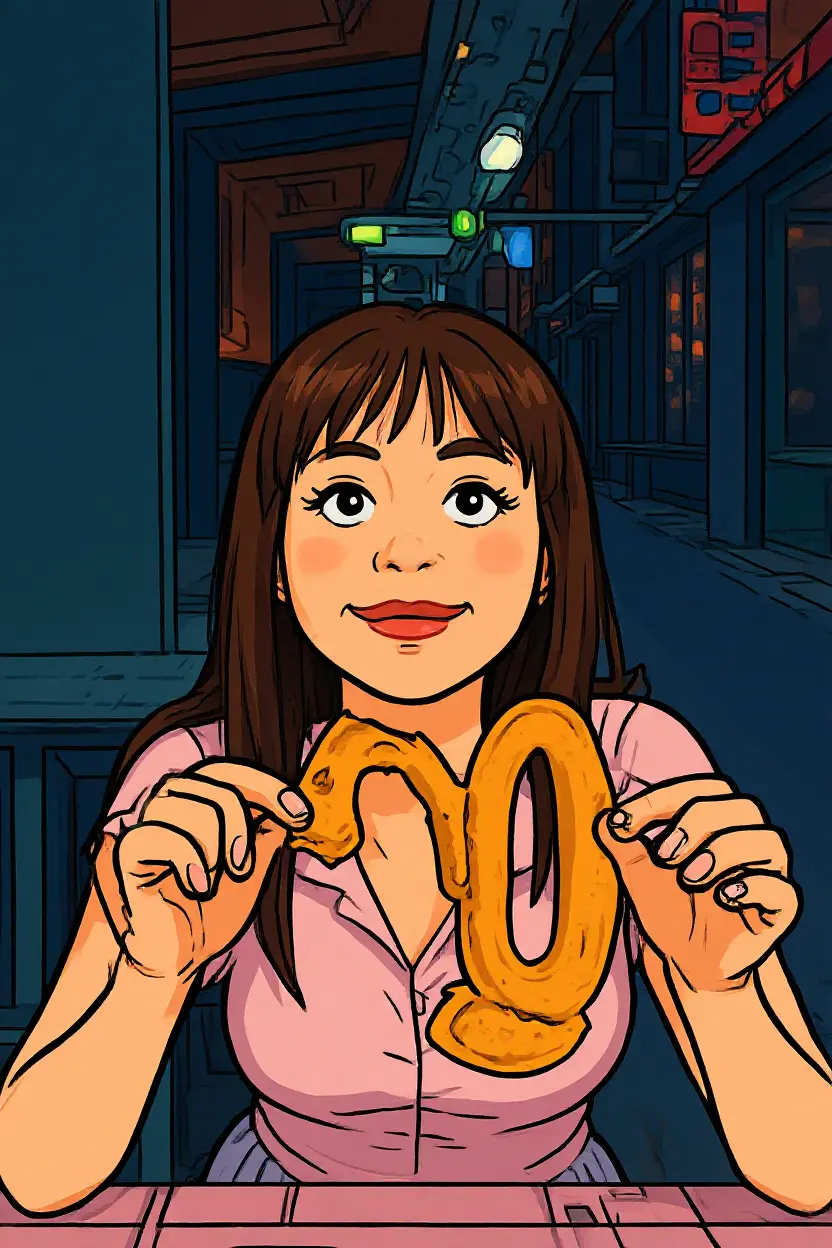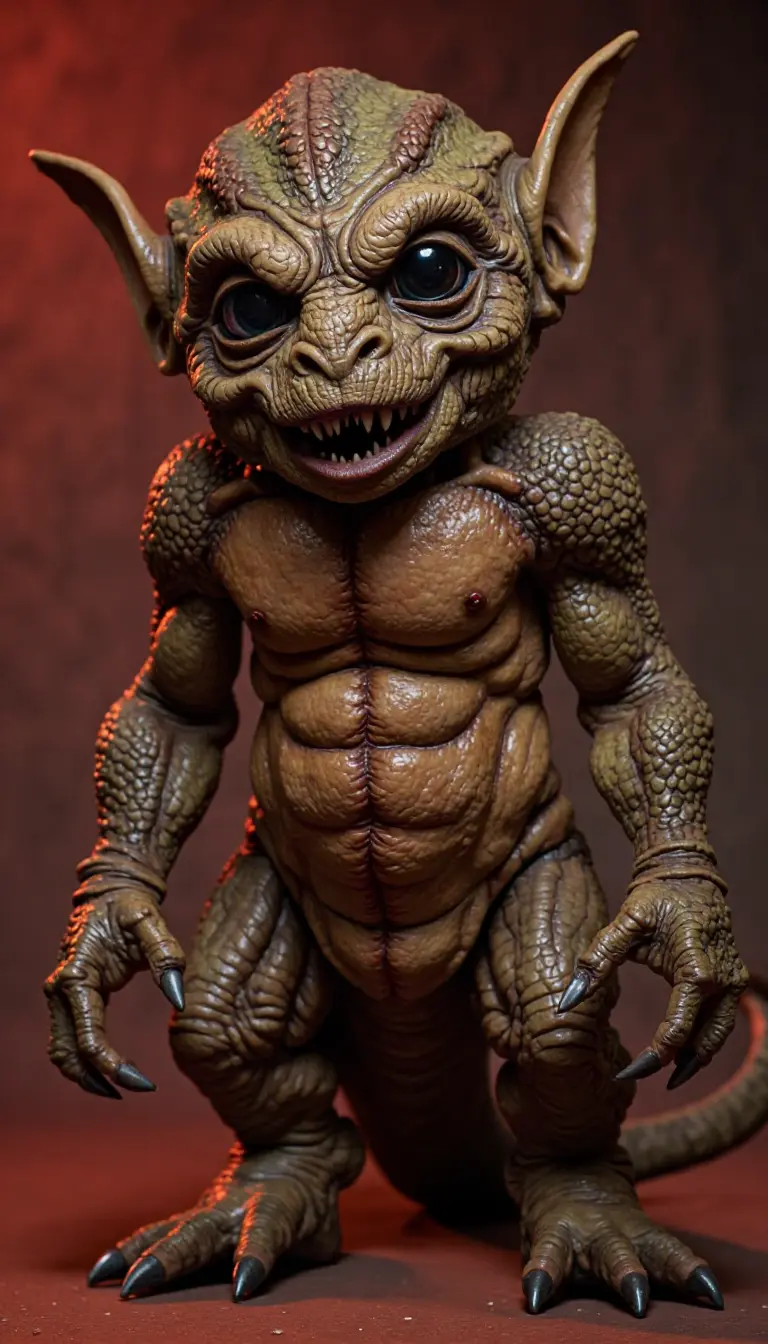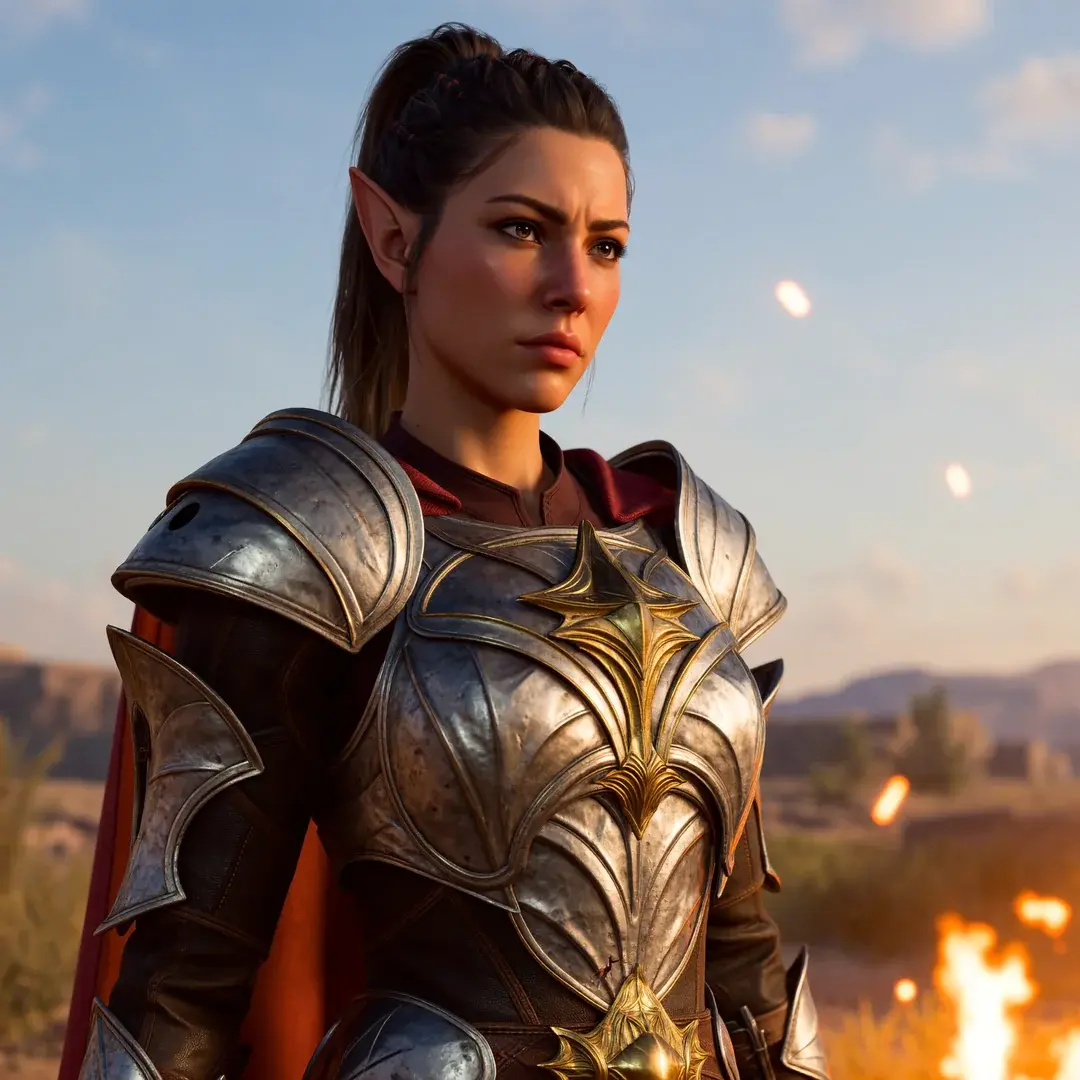
VestalWater’s Illustrious Styles for Qwen Image
VestalWater's Illustrious Styles for Qwen Image 是一次对 AI 图像美学方向的主动选择——它不迎合大众审美趋势,而是服务于特定创作者群体的需求:那些希望摆脱“AI塑料感”、追求更具手绘质感与专业实用性的用户。
AnyPose专为 Qwen Image Edit 2511 Lightning LoRA 设计,无需 ControlNet,无需骨骼图,仅凭一张参考图 + 简单提示词,即可让目标角色精准复刻任意姿势。
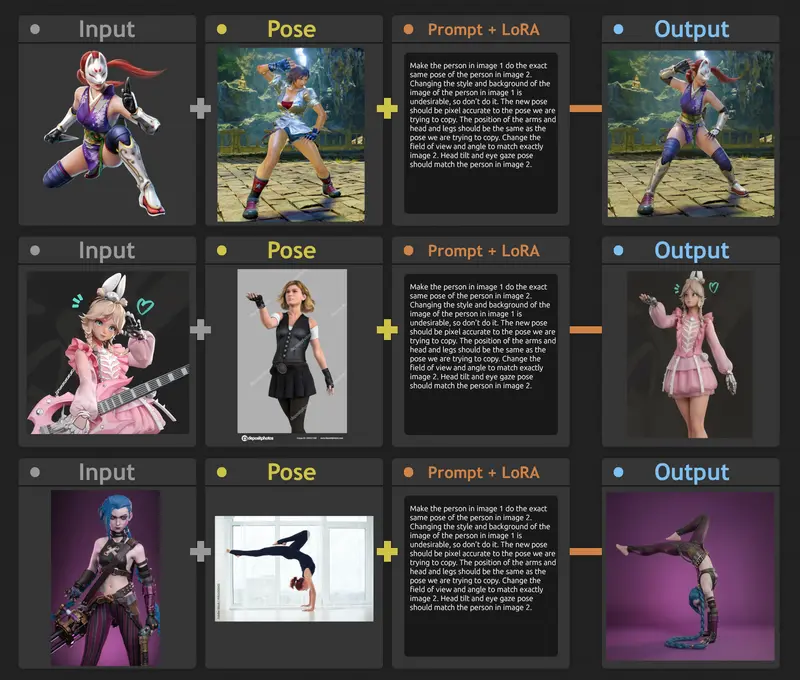
在使用 Qwen Image Edit (2511) 时,即使模型内置了 OpenPose,姿势控制仍常出现深度失真、肢体错位或非预期扭曲等问题。而手动通过 Blender 创建 OpenPose 骨骼不仅繁琐,对非 3D 用户门槛极高。
开发者lilylilith发布了AnyPose LoRA ——它专为 Qwen Image Edit 2511 Lightning LoRA 设计,无需 ControlNet,无需骨骼图,仅凭一张参考图 + 简单提示词,即可让目标角色精准复刻任意姿势。
AnyPose LoRA 通过在训练阶段对齐两张摆出相同姿势的角色图像(通常使用 Blender 渲染的 3D 人体模型),学习“如何将一张图的姿势迁移到另一张图的角色上”。推理时,用户只需提供:
模型即可在保留图像1风格与身份的前提下,将图像2的姿势“像素级”对齐迁移。

“让图像1中的人物做出与图像2中人物完全相同的姿势。改变图像1中人物的风格和背景是不可取的,所以不要这样做。新姿势应与我们试图复制的姿势在像素级别上精确一致。手臂、头部和腿部的位置应与我们试图复制的姿势相同。改变视场和角度以精确匹配图像2。头部的倾斜和眼神的视线姿势应与图像2中的人物一致。”
“移除图像2的背景,并用图像1的背景替换它。”
“图像1中的女人穿着白色紧身裤。”

为什么?AnyPose 会尝试“填充”原始图像中缺失的区域(如下半身),但若无参考,它只能靠猜测。提供完整初始图可大幅减少虚构内容。
AnyPose 的输出可通过自然语言提示精细调整:
这种“提示词驱动修正”虽需人工介入,但比重新生成或手动绘图高效得多。
尽管效果惊艳,AnyPose 仍存在以下限制:
| 问题类型 | 表现 | 原因 |
|---|---|---|
| 2D 风格失效 | 卡通、像素艺术、扁平插画等姿势迁移失败 | 训练数据主要来自 Blender 3D 渲染模型,缺乏 2D 姿势先验 |
| 极端复杂姿势 | 高难度瑜伽、杂技等动作出现肢体断裂或比例失真 | 模型未充分覆盖超复杂姿态空间 |
| 多角色干扰 | 两张图中任一含多人时,主体识别混乱 | 模型默认处理单人场景 |
开发团队已规划 V2 版本,重点改进: