HyperFlow H3 Flash

11 00

Video Rebirth 开源 HyperFlow H3 Flash,是基于 MiniMax H3(32B)压缩蒸馏得到的少步视频音频一体化模型,参数压缩至约 14B,支持同时输出视频 + 32kHz 立体声,原生适配 ComfyUI,消费级显卡即可部署,在 4 张 B200 上可实现 768p 视频实时生成。
作者
Video Rebirth
基础模型
MiniMax-H3
HyperFlow H3 Flash

Video Rebirth 正式开源 HyperFlow H3 Flash,作为该系列的第三代模型,它实现了对 MiniMax-H3 架构的深度压缩与少步推理优化。该模型在维持与 bf16 基线一致的生成质量前提下,将参数量从约 31B 缩减至 14B 级别,不仅支持在消费级显卡上运行,同时在 4 块 B200 GPU 配置下可实现 768p 视频的实时生成。
HyperFlow H3 Flash

核心规格与性能表现

HyperFlow H3 Flash 通过算法优化与量化技术,在生成质量与计算开销之间取得了明确的工程平衡:

  • 参数规模与推理效率:模型提供 fl2va(13.7B 参数)和 ref2va(13.9B 参数)两个版本。通过支持 4、6(默认)或 8 步推理,且完全无需无分类器引导(CFG),显著降低了单次生成的计算开销。
  • 输出规格:可生成 5.2 至 15 秒的视频,默认分辨率为 1344×768,帧率为 24 fps,并同步生成 32 kHz 立体声音频。
  • 推理速度:在生成 5.2 秒片段(6 步推理)的基准测试中,4 块 B200 GPU 耗时 8.7 秒(实现实时生成),单块 H200 耗时 36 秒,单块 RTX 5090 耗时 92 秒。
  • 显存占用:最小显存需求通过量化技术进一步压缩。Q4_K_M 量化版本仅需 9.1 GB 显存,Q8_0 版本为 14.9 GB,使其能够在配备 16 GB 系统内存及 24 GB 或 32 GB 显存的消费级 PC 上稳定运行。

多模态任务支持

该模型覆盖了从基础生成到复杂参考控制的多种工作流需求:

  • t2va(文本到视频音频):仅输入文本提示即可生成带同步音频的视频内容。
  • fl2va(关键帧到视频音频):支持输入提示词加首帧,或首尾双关键帧,用于精确控制视频的起始与结束状态。
  • ref2va(参考到视频音频):支持输入提示词及最多 12 个参考素材(涵盖图像、视频或音频),适用于需要保持高度主体一致性或复杂风格迁移的生成任务。

运行时选择与部署方案

针对不同硬件环境,官方提供了明确的运行时决策规则:系统内存 64 GB 及以下的 PC 推荐使用 GGUF 格式;而数据中心 GPU 或配备至少 69 GiB 系统内存及 24 GB 以上显存的 RTX GPU,则推荐使用 INT8 convrot 格式。

  • GGUF 运行时(面向消费级硬件):支持 ComfyUI、Unsloth Studio 和 stable-diffusion.cpp。量化级别覆盖 Q3_K_M(约 7.2 GB,最小占用)至 Q8_0(约 15.2 GB,最接近全精度)。以 ComfyUI 为例,用户需克隆相关自定义节点,下载约 15.7 GB 的 qwen3vl_32b 文本编码器,并通过 --fast-disk 参数启动,即可加载预设的 t2v、i2v 等工作流模板。
  • INT8 CONVROT 运行时(面向高性能计算):通过 Python 包(包含 CLI 和 diffusers 接口)部署。采用 W8A8 INT8 加低秩适配技术,显存占用约 16 GB。该方案主要面向 H100/H200/B200 等多卡集群,或在系统内存充足(≥69 GiB 配合 fp8 文本编码器,或 ≥91 GiB 配合 bf16)的高端单卡环境下运行,以提供完整的图像、视频和音频参考输入支持。

相关图书

MiniMax-H3-Facial-Realism-CloseUp

MiniMax-H3-Facial-Realism-CloseUp

MiniMax-H3-Facial-Realism-CloseUp 是一款专为 MiniMax H3 模型设计的实验性 LoRA 适配器,显著提升人像特写视频中的面部真实感与微表情细节。
vh5tape

vh5tape

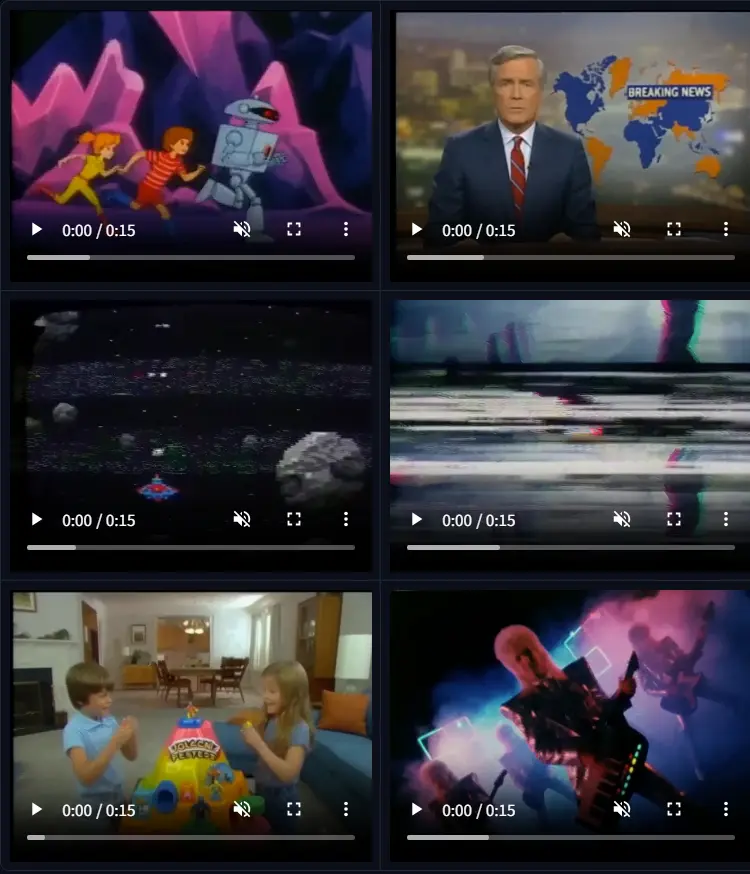
如果你想用 AI 复刻八十年代老旧录像带的复古画面,同时配套生成磁带噪音、沉闷单声道音效,vh5tape 这款社区 LoRA 就是专门为 MiniMax H3 全模态视频模型打造的复古风格工具。不同于普通图像滤镜,它可以做到画面损伤效果与音频磁带质感同步生成,一次性产出完整的 VHS 录像片段。
10Eros-Max

10Eros-Max

10Eros-Max 是一个基于 MiniMax H3 基础模型的实验性分支,旨在通过特征迁移(Feature Transfer)技术,将 LTX 2.3、Wan 2.2 以及 Krea 2 的学习模式融合到 H3 的 Transformer 架构中。该模型在保留 H3 核心音视频生成能力的同时,显著增强了视觉细节、运动连贯性及文本遵循能力。
MiniMaxH3 Enhancers

新MiniMaxH3 Enhancers

MiniMax H3 Enhancers 是面向 MiniMax H3 视频模型的画质增强 LoRA,目标是提升成片整体视觉质感,减少生成自带的模糊发虚问题,优化人脸、人物与背景细节,让视频观感更干净精致。