Open-H3-Regenerate-2K

23 00

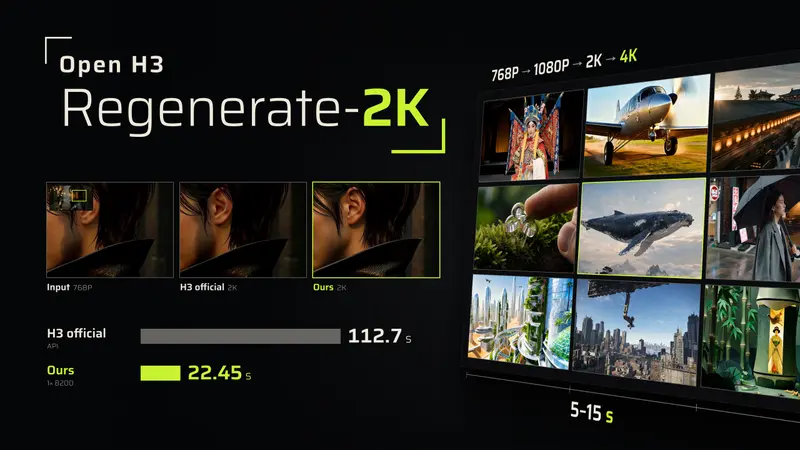
Open-H3-Regenerate-2K 由英伟达 Sana 团队推出,是MiniMax H3 闭源 2K 精炼 API 的开源替代方案。官方 H3 仅开放 768P 基础生成权重,2K 高清重绘能力只提供托管 API、不开放权重,这个项目补齐了本地部署的短板:输入任意低分辨率视频草稿,在潜在空间上采样后,只用 3 步扩散重绘,原生输出...
作者
英伟达 Sana 团队
基础模型
MiniMax H3
Open-H3-Regenerate-2K

MiniMax H3 基础模型在低分辨率下生成视频草稿具有成本优势,但其官方的 2K 分辨率重绘模型(H3-Regenerate-2K)仅以托管 API 形式提供,未开放模型权重。这导致开源社区无法在本地 GPU 上运行、适配或扩展该高分辨率生成能力。

Open-H3-Regenerate-2K

英伟达 Sana 团队推出 Open-H3-Regenerate-2K,作为该闭源 API 的开源替代品,通过引入精炼器 LoRA 与潜在空间上采样技术,实现了从低分辨率草稿(如 384P、512P、576P 或 768P)到原生 2K(2560×1440)甚至 4K(3840×2160)视频的高效重绘。

  • GitHub:https://github.com/NVlabs/Sana/tree/sol-engine/models/Open-H3-Regenerate-2K
  • Lora:https://huggingface.co/Efficient-Large-Model/Open-H3-Regenerate-2K-LoRA

该方案在保持草稿原有内容与运动轨迹的前提下,通过三步扩散过程显著提升了面部、织物、毛皮和植被等细节的全尺寸表现。

Sana 团队发布了一个改进版本,一致性大大提高。IC版本将低分辨率草稿保持在上下文中,因此人脸、唇同步、文字和布局保持忠实,同时生成高分辨率细节。

  • 🔌 MiniMax H3即插即用:只需加载LoRA
  • ⚙️ 灵活的3 / 4 / 8步推理,根据你的计算预算平衡速度和质量
  • 🎬 2K / 4K输出,以及384P → 768P放大
  • 模型:https://huggingface.co/Efficient-Large-Model/Open-H3-Regenerate-2K-IC

核心工作流:从低分辨率草稿到高分辨率

Open-H3-Regenerate-2K 的核心逻辑是“冻结主干,局部精炼”。其处理流程分为四个标准化步骤,避免了传统像素级缩放带来的高昂计算成本:

  1. 编码 (Encoding):使用 H3 视频 VAE 对输入的低分辨率草稿进行一次编码,提取潜在特征(Latent)。
  2. 放大 (Upscaling):引入社区模型 H3-Latent-Upscaler,通过学习的 3D 卷积网络,直接将潜在特征映射到目标分辨率网格(例如从 36×64 放大至 90×160),无需经历“解码为像素→调整尺寸→重新编码”的耗时往返过程。
  3. 重新生成 (Regeneration):将放大后的潜在特征重新加噪至 $\sigma = 0.909$,随后在三个 Euler 步骤中进行降噪(噪声调度为 $0.909 \rightarrow 0.857 \rightarrow 0.667 \rightarrow 0$)。此阶段关闭无分类器引导(CFG),确保每一步仅为目标分辨率下的一次 Transformer 调用。
  4. 解码 (Decoding):使用 H3 VAE 解码器将精炼后的潜在特征还原为视频帧。快速路径可采用 StreamRender-H3 的 24 层快速解码器以进一步压缩时间。

注:单纯的空间放大无法增加细节,它仅将布局、颜色和运动映射到更大的网格;真正的表面细节绘制由随后的三个扩散步骤完成。

关键技术与训练策略

1. 训练配方

模型训练遵循 SoL-Refiner 的 Stage I(高分辨率持续训练)配方。训练数据由 1280×704 或 2560×1440 的真实高质量片段及其退化副本(经抗锯齿双线性滤波器缩小 8× 至 64× 后恢复)构成。训练过程中,H3 Transformer 和视频 VAE 保持完全冻结,仅对精炼器 LoRA(rank 384,5000 步 EMA)进行训练,使用从 $\sigma = 0.91$ 下降的噪声水平上的流匹配速度损失。

2. 组件合并与少步推理

为追求极致推理速度,该方案整合了多项社区优化成果。精炼器 LoRA 在推理时与 LightX2V 的 FL2VA Turbo(使 H3 在四步内生成的 LoRA)以及 Alissonerdx 的 LMS Sharp 适配器合并为单一 LoRA 权重。由于草稿已具备固定的布局和运动,三步降噪足以完成细节重建。

3. 推理性能优化

在单块英伟达B200 GPU 上,处理从 1344×768 放大至 2560×1440 的潜在特征、执行三个精炼步骤及 VAE 解码,未优化时耗时 87.26 秒。通过引入以下优化,总耗时降至 22.45 秒(加速 3.9 倍):

  • SoL-Engine:采用 Sol-Attn 稀疏注意力机制(节省 39.99 秒)、带融合 SwiGLU 量化器的 MXFP8 线性层,以及每步 CUDA 图。
  • StreamRender-H3:使用剪枝至 24 层并经过蒸馏的快速 H3 VAE 解码器,将解码时间从 15.0 秒大幅削减至 1.6 秒。

性能评估与实验数据

在 RefinerBench-150 基准测试(涵盖日常场景、运动、动物、车辆、风景、肖像和快速相机运动的 150 个视频)中,Open-H3-Regenerate-2K 与官方 API 进行了同输入、同输出(2560×1440)的严格对比:

  • VBench 评估:在美学质量、成像质量和主题一致性三个维度上得分高于官方 API。官方 API 仅在运动平滑度和动态程度上略占优势,背景一致性两者持平。
  • UniPercept 评估:在感知质量的三个轴上全面领先。美学(IAA)和技术图像质量(IQA)平均高出约 8 分,结构和纹理(ISTA)平均高出约 3 分。
  • 用户盲测研究:在 200 次成对判断中(权衡清晰度、细节、自然度、伪影和时间稳定性),87% 的参与者更偏好 Open-H3-Regenerate-2K 的输出结果。

部署与组件集成指南

由于 Open-H3-Regenerate-2K 是一个整合了多项社区技术的工程方案,其本地部署并非单一模型的下载,而是需要正确配置和集成以下核心组件。

1. 基础环境与依赖

  • 硬件要求:推荐使用支持 MXFP8 和高效稀疏注意力的现代 GPU(如英伟达B200 或同级别高显存显卡),以复现 22 秒级的 2K 生成速度。
  • 软件依赖:需配置支持 SoL-Engine 优化的 PyTorch 环境,包括 CUDA 图支持、MXFP8 线性层库以及相应的稀疏注意力算子。

2. 核心模型组件准备

在运行推理前,需确保以下模型权重已下载并放置在正确的目录中:

  • H3 基础组件:冻结的 H3 Transformer 权重与 H3 视频 VAE 权重。
  • H3-Latent-Upscaler:社区提供的 3D 卷积网络权重,用于潜在空间的直接放大(2K 映射为每边 2.5 倍,4K 需连续应用两次)。
  • 合并后的精炼器 LoRA:需获取或自行合并包含以下三部分的单一 LoRA 权重文件:
    1. Open-H3-Regenerate-2K 基础精炼器 LoRA。
    2. LightX2V 的 FL2VA Turbo LoRA。
    3. LMS Sharp 适配器。

3. 推理配置与运行逻辑

  • 输入兼容性:脚本需配置为接受任意低分辨率草稿(384P 至 768P),并支持指定目标输出分辨率(768P, 1080P, 2K, 4K)。
  • 噪声调度设置:推理脚本必须严格配置为从 $\sigma_0 = 0.909$ 开始,执行 3 步 Euler 降噪,且关闭无分类器引导 (CFG),以确保每一步仅产生一次 Transformer 调用,维持少步推理的性能优势。
  • 解码器切换:在推理配置中,显式调用 StreamRender-H3 的 24 层快速 VAE 解码器,而非默认的 36 层解码器,以激活 1.6 秒的极速解码路径。

4. 适用范围说明

该方案支持 5 到 15 秒的视频片段单次通过精炼。例如,一个 15 秒(360 帧)的片段可在一次运行中直接重新生成为 2K 分辨率,无需分块处理。
相关图书

MiniMax-H3 T2VA Prompt Rewriter LoRA

MiniMax-H3 T2VA Prompt Rewriter LoRA

lightx2v团队开源的MiniMax-H3 T2VA Prompt Rewriter LoRA是一款基于Qwen3.6-27B微调的LoRA适配器,专为将简短文本提示转换为MiniMax-H3文本生成音视频(T2VA)任务所需的结构化描述而设计。
H3-Latent-Upscaler-2x

H3-Latent-Upscaler-2x

在处理 MiniMax H3 视频时,传统的放大流程是“VAE 解码 → 像素缩放 → VAE 重编码”,这不仅耗时,还会引入额外的画质损失。H3-Latent-Upscaler-2x 提供了一种纯隐空间的解决方案,它能直接将干净的视频隐空间映射到 2 倍大的空间网格上,全程不触碰像素域。
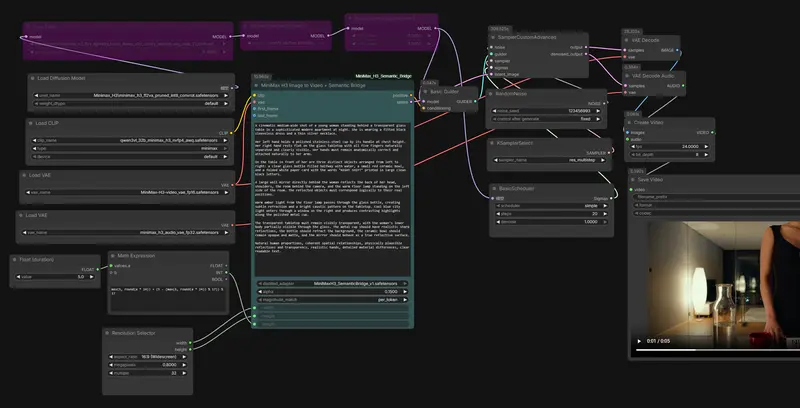
MiniMax H3 Semantic Bridge

MiniMax H3 Semantic Bridge

MiniMax H3 Semantic Bridge 是一个紧凑的条件空间适配器,解决视频生成模型中常见的“语义结构丢失”问题。它并非传统的 LoRA 或权重合并,而是一个通过跨架构表示迁移与蒸馏技术生成的独立模块(仅约 11 MB)。
H3 Ripple

H3 Ripple

H3 Ripple 是面向 MiniMax H3 FL2VA 的专用LoRA,核心能力是涟漪式视频编辑:只修改一到两个锚定关键帧,再由这个LoRA把画面改动平滑扩散、贯穿整条视频片段,不用逐帧处理。