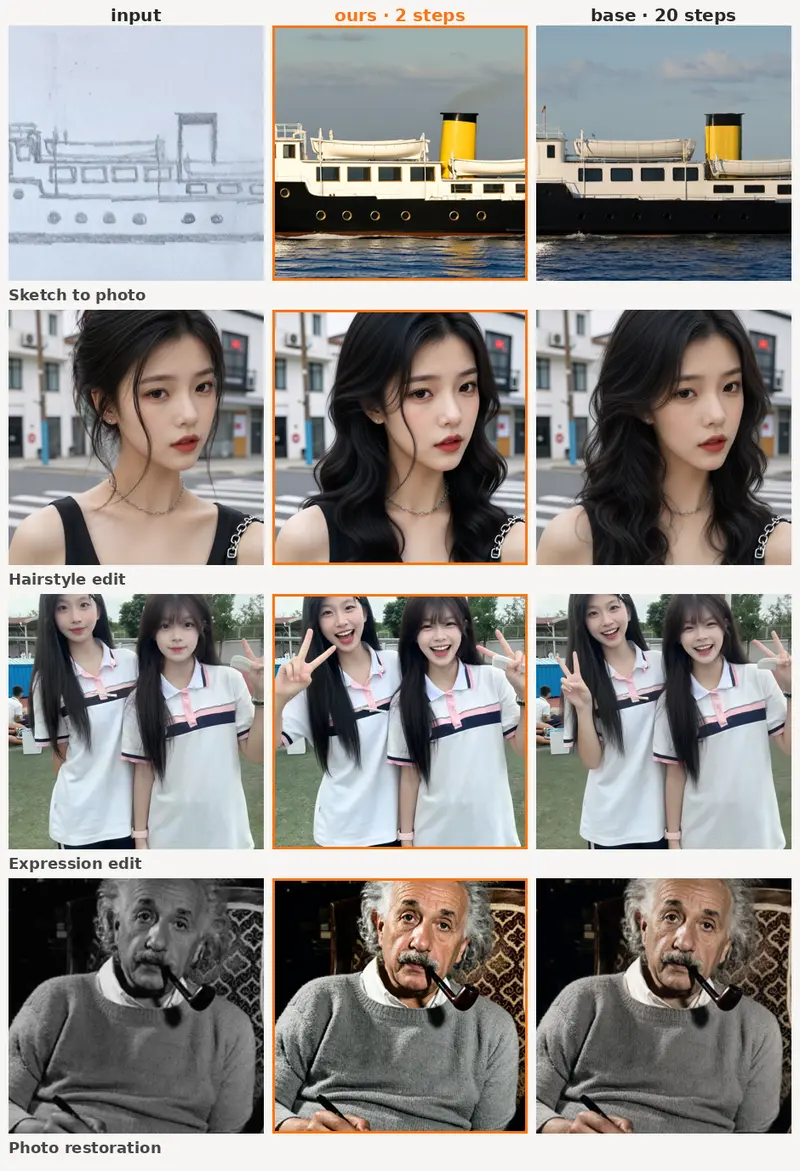
Qwen-Image-2.1-DMD2-2steps
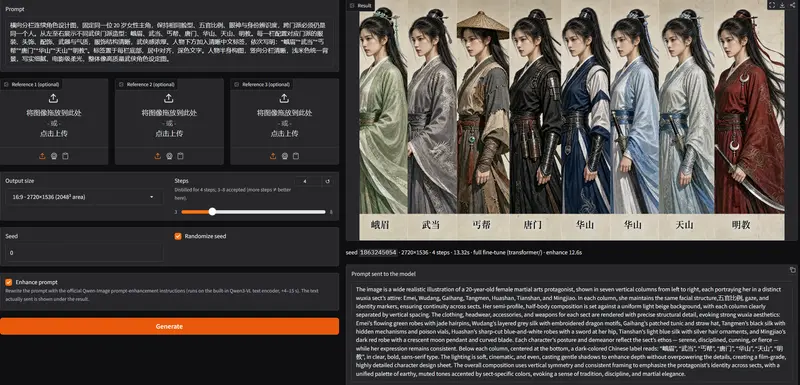
DMD2 蒸馏 LoRA 给 Qwen-Image-2.1 做两步加速,仅注意力层微调;在大幅减少采样步数的前提下,文生图和图像编辑效果贴近原版 20 步模型,主打交互式实时绘图。
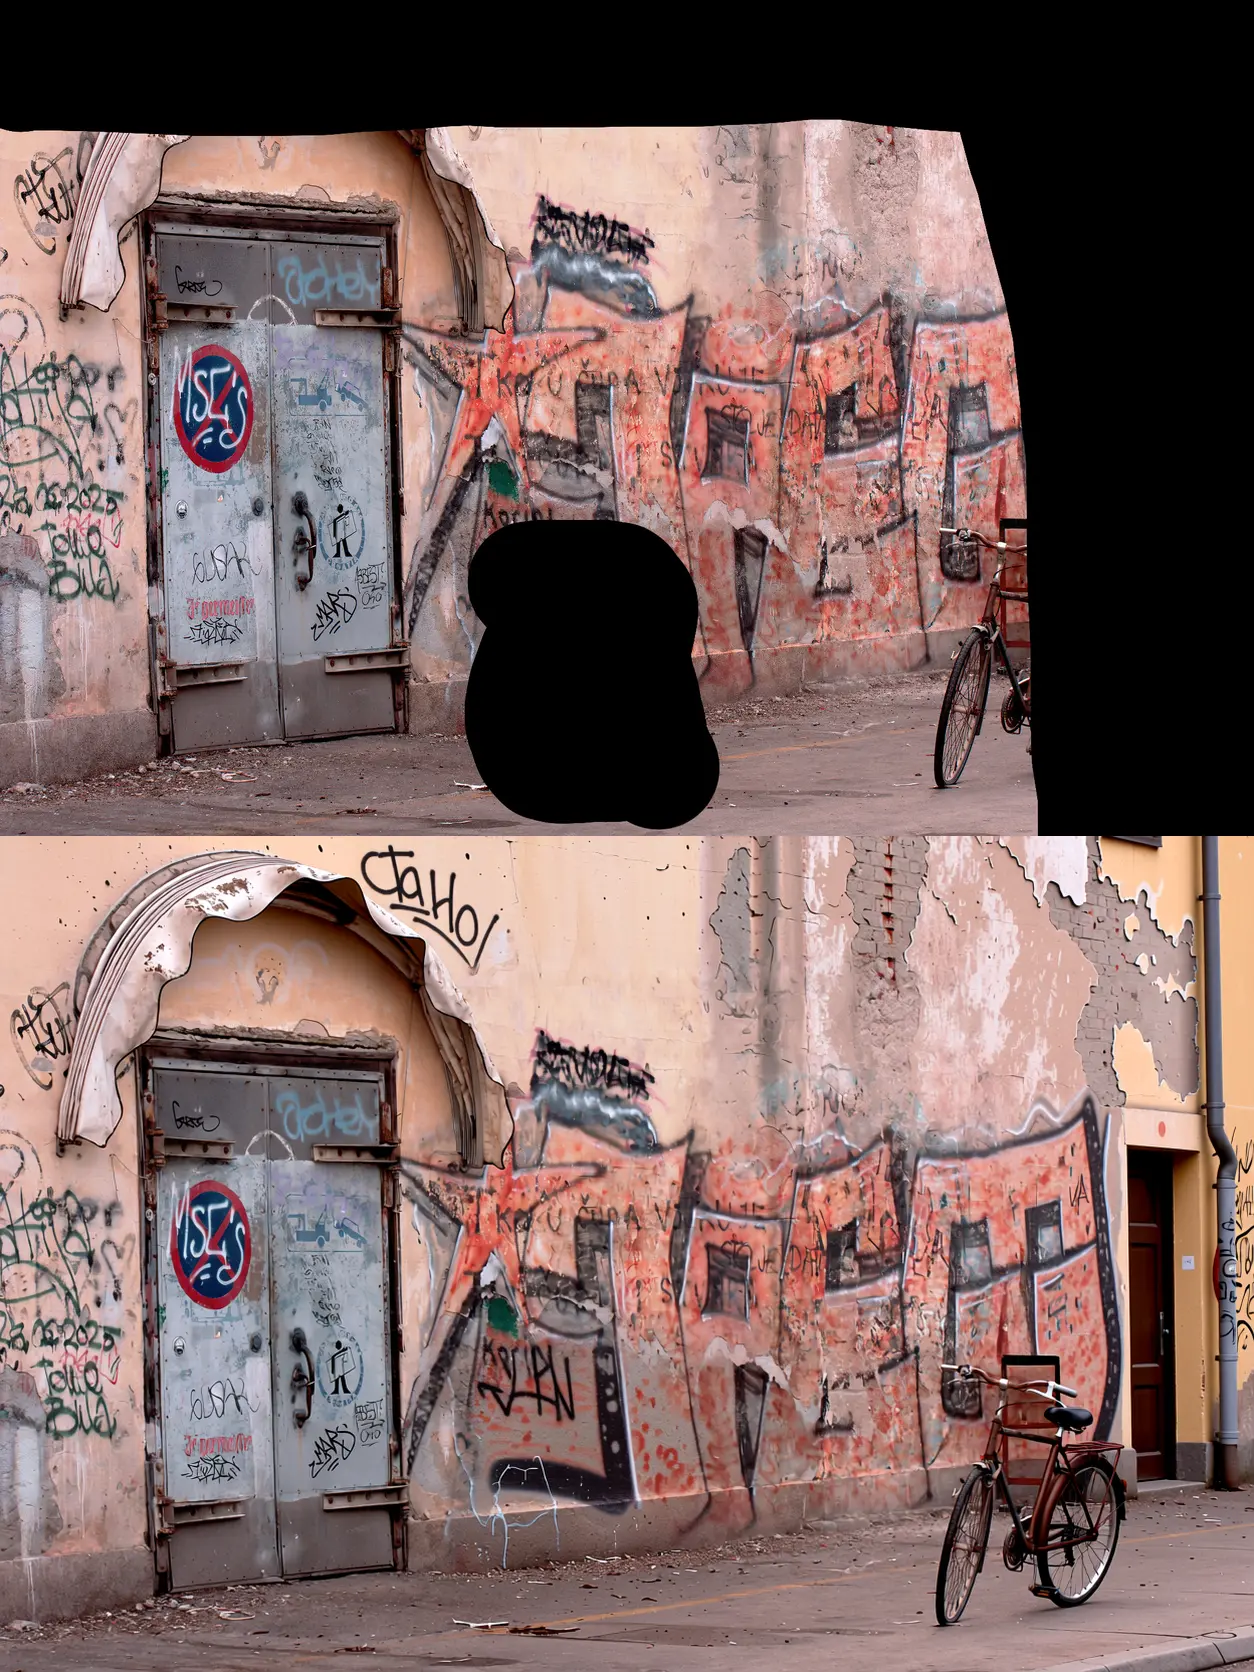
Qwen Image 2.1 Outpaint LoRA 是专为通义Qwen Image 2.1打造的外绘(Outpaint)LoRA,核心解决原生Qwen Image 2.1扩图时原图容易移位、重新构图的痛点。
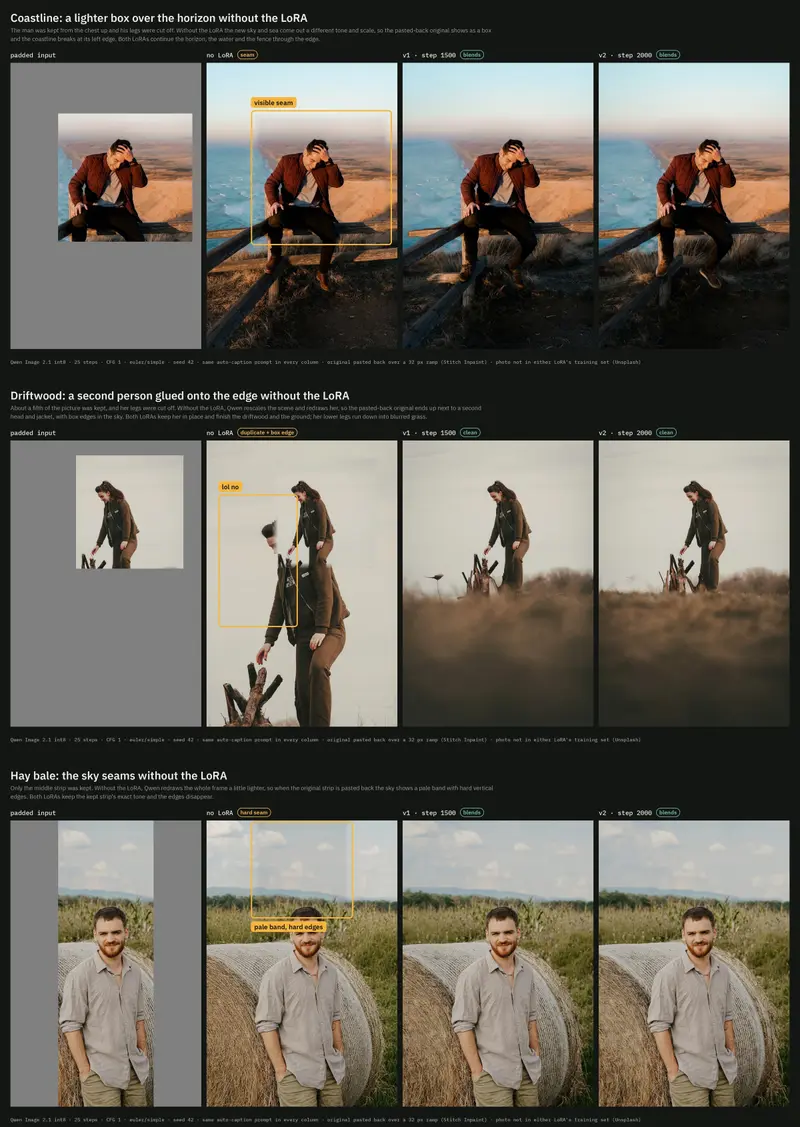
Qwen Image 2.1 Outpaint LoRA 是专为通义Qwen Image 2.1打造的外绘(Outpaint)LoRA,核心解决原生Qwen Image 2.1扩图时原图容易移位、重新构图的痛点。使用#808080纯灰色填充画布空白区域作为参考图,模型会自动延续场景填充灰色区域,原始图像像素保持固定位置不变,实现干净无缝的画面外扩。
两个正式版本均为rank32,适配ComfyUI权重键格式diffusion_model.transformer_blocks.*,共384个张量,加载到Comfy-Org发布的Qwen Image 2.1基础模型。
| 文件 | 版本&训练信息 | 适用场景 |
|---|---|---|
| qwen-image-2.1-outpaint.safetensors | v1,1500步,约1MP分辨率训练 | 支持极端大幅度扩图、小图放置到大画布 |
| qwen-image-2.1-outpaint-v2.safetensors | v2,2000步,1~2MP,人物/时尚图像集训练 | 中小幅度扩图,人像、服饰场景效果更好 |
| qwen21_outpaint_v1_000001250.safetensors | v1 1250步 | 和1500步版本效果接近 |
| qwen21_outpaint_v1_000000500.safetensors | v1 500步 | 基础可用,填充效果更朴素 |
二者核心能力一致,都可以锁定原图位置,保证拼接干净。
指令本身就是触发词,放在提示词最前方:
Outpaint the image: replace the solid gray areas with a seamless continuation of the scene, keeping the existing picture unchanged.
可选追加:Scene: <图片内容描述>
推荐搭配Qwen3-VL 8B编码器自动读取原图,生成场景描述,省去手动写图描述。
重要注意:不要用Set Latent Noise Mask做蒙版锁定原图,原生Qwen2.1使用该节点会在接缝生成明显矩形边框;这个LoRA自带锁定原图的能力。
若成品在原图粘贴处出现亮框、重影边缘,检查LoRA是否成功加载;Civitai工作流会跳过缺失LoRA文件静默运行基础模型,不会报错。
原生Qwen Image2.1做外绘极易重新缩放、重构画面,甚至直接返回灰色边框;加载本LoRA后原图像素坐标锁定,接缝颜色阶跃明显降低。
倾斜图像测试(旋转17°):无LoRA全部12张图出现原图偏移,最大偏移95px;加载v1/v2后全部样本原图零偏移,解决斜向扩图重影、裁切问题。
训练工具:ostris/ai-toolkit;231张原图,生成924组训练对,覆盖单边、对角两侧、角落、三边、全边框、小窗口等多种布局。
训练素材包含CC-BY摄影、CC0博物馆画作、CC0动漫图。
超参:rank32,alpha32,AdamW8bit,固定LR1e-4,1500步,1250步左右收敛。
68张精选素材,47张人像服饰、21张场景/室内/绘画;保留区域占画布45%~93%,无极端小窗口案例。目标分辨率1408,2000步。