Qwen3-VL-32B Ultra Uncensored Heretic — MiniMax-H3 ComfyUI INT8 ConvRot

957 00

社区开发者推出了这款基于 Qwen3-VL-32B-Instruct-ultra-uncensored-heretic 定制的文本/视觉条件编码器。 该检查点经过深度裁剪与 INT8 ConvRot 量化,将原本超过 51 GB 的 BF16 模型压缩至约 24.55 GiB,使其能够在 RTX 5090 (32GB VRAM) 等高端消...
作者
ethanfel
基础模型
MiniMax-H3
Qwen3-VL-32B Ultra Uncensored Heretic — MiniMax-H3 ComfyUI INT8 ConvRot

为了让庞大的 MiniMax-H3 视频生成模型能在消费级显卡上流畅运行,社区开发者推出了这款基于 Qwen3-VL-32B-Instruct-ultra-uncensored-heretic 定制的文本/视觉条件编码器。

  • 模型:https://huggingface.co/ethanfel/Qwen3-VL-32B-Ultra-Heretic-MiniMax-H3-ComfyUI-INT8-ConvRot

该检查点经过深度裁剪与 INT8 ConvRot 量化,将原本超过 51 GB 的 BF16 模型压缩至约 24.55 GiB,使其能够在 RTX 5090 (32GB VRAM) 等高端消费级显卡上完成加载与推理,是运行 MiniMax-H3 的推荐版本。

核心特性:精准裁剪与高效量化

1. 针对 MiniMax-H3 架构定制

MiniMax-H3 使用语言层 49 之后、未经归一化的隐藏状态作为条件输入。因此,该检查点进行了精确的结构裁剪:

  • 保留部分:Qwen3-VL 嵌入层、语言层 0-49、完整的视觉塔(Visual Tower)。
  • 省略部分:语言层 50-63、最终语言归一化层及 LM Head。
    这种“只取所需”的策略大幅减少了显存占用,同时确保了与 H3 生成模型的完美兼容。

2. INT8 ConvRot 量化技术

为了在有限显存下保持高精度,模型采用了先进的混合量化方案:

  • INT8 ConvRot:对 350 个逐行语言矩阵进行量化,每组大小为 256,显著降低内存带宽需求。
  • BF16 保留:551 个关键张量(包括完整视觉塔和所有归一化层)保留为 BF16 精度,确保视觉特征提取的准确性。
  • FP32 缩放:包含 351 个 FP32 权重缩放因子,进一步维持数值稳定性。

3. “Heretic”去审查版本

该模型源自 llmfan46/Qwen3-VL-32B-Instruct-ultra-uncensored-heretic,经过了 Heretic v1.2.0 ARA 编辑(针对语言层 31-40 的 attn.o_proj)。

  • 低拒绝率:源模型报告显示,其拒绝率从原始模型的 99/100 降至 4/100。
  • 性能平衡:在大幅减少安全过滤的同时,保持了较高的智力水平(PIQA 92.87%, MMLU 79.87%),KL 散度仅为 0.0421。
    注意:去审查并不意味着完全移除所有安全限制,且可能对模型通用质量产生细微影响。

安装与使用指南

1. 文件下载

  • 文件名:qwen3vl_32b_minimax_h3_ultra_uncensored_heretic_int8_convrot.safetensors
  • 大小:24.55 GiB
  • SHA-256:d84547412144b7c50a6ec77437a889b869d3ace88da77ef1775d3d2a4901c192

2. ComfyUI 部署

  1. 将 .safetensors 文件放入以下目录:
    ComfyUI/models/text_encoders/MiniMax-H3/
    
  2. 在 ComfyUI 中使用 CLIPLoader 节点。
  3. 选择该文件,并将类型设置为 minimax (对应 MiniMax-H3)。
  4. 确保已安装并固定 comfy-kitchen 依赖(推荐版本 >= 0.2.26)。

3. 硬件要求与验证

  • 推荐显卡:NVIDIA GeForce RTX 5090 (32GB VRAM) 或更高。
  • 显存占用:编码完成后约分配 24.7 GiB,保留 26.1 GiB。
  • 环境建议:建议使用当前最新的 ComfyUI 环境及其推荐的 PyTorch 构建(CUDA 12.8+)。虽然测试中在 CUDA 12.8 下通过回退操作成功运行,但升级到 CUDA 13.0+ 可获得更优的内核性能。

相关图书

MiniMax-H3-Looping-Sketch-Anime

MiniMax-H3-Looping-Sketch-Anime

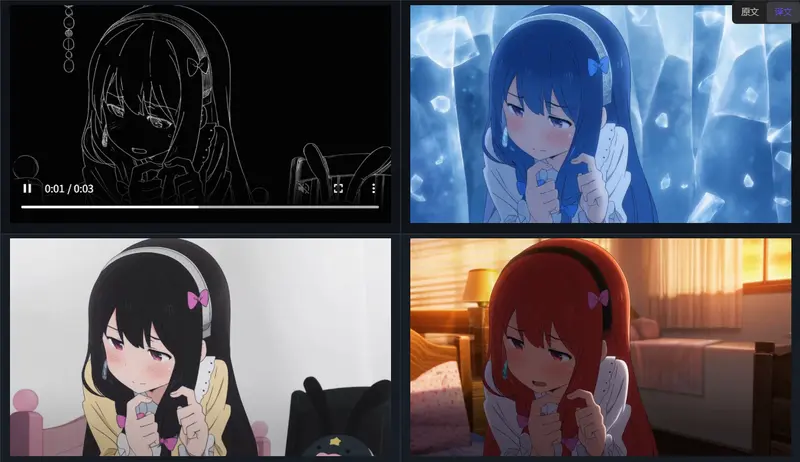
MiniMax-H3-Looping-Sketch-Anime专为生成具有循环动画(Looping)效果的手绘草图风格视频而设计,能够将普通的动态场景转化为充满艺术感的粗糙线条与极简色块。
Minimax-H3-Turbo

Minimax-H3-Turbo

Lightx2v团队发布Minimax-H3-Turbo,为MiniMax-H3模型提供推理加速能力。该LoRA支持4步快速生成,推荐配置为0.75强度搭配er_sde或sa_solver调度器。
MiniMax-H3-PTD-RefAsymOPD-LoRAs

新MiniMax-H3-PTD-RefAsymOPD-LoRAs

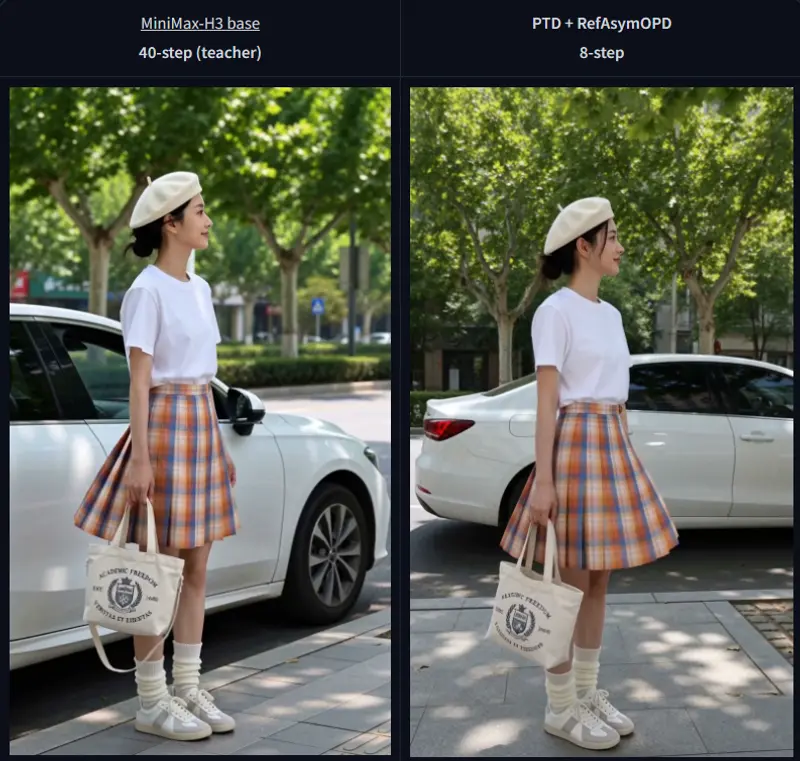
MiniMax-H3 Ref2VA PTD + RefAsymOPD 加速 LoRA 代表了当前参考图像到音视频生成领域的一项高效工程实践。它通过精巧的同策略蒸馏设计,成功打破了“推理速度”与“生成质量”之间的传统权衡,为需要在本地或云端进行高频、高质量 Ref2VA 生成的开发者和创作者,提供了一套低成本、高保真且易于集成的解决方案。