MiniMax H3 Realism People LoRA

219 00

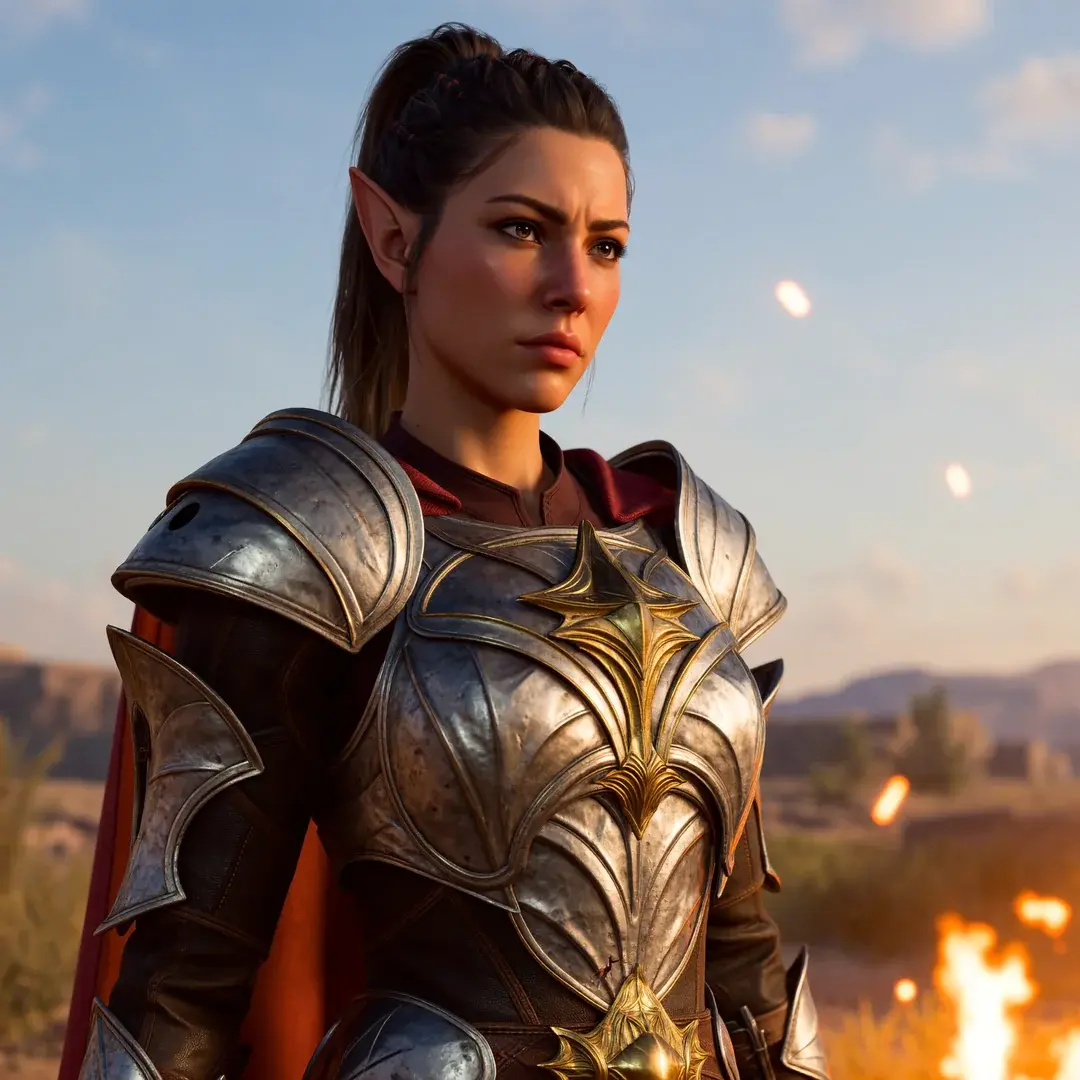
MiniMax H3 Realism People LoRA 是一个专为 H3 设计的Lora,旨在将写实人物的表现力推向新的高度:从经得起推敲的面部微表情,到自然的皮肤毛孔纹理,再到纪录片风格的持机运动感。
作者
fal
触发词
r34l1sm
基础模型
MiniMax H3
MiniMax H3 Realism People LoRA

MiniMax H3 本身已具备强大的通用视频生成能力,但在处理以人物为核心的特写镜头时,往往缺乏那种“呼吸感”和真实的皮肤细节。MiniMax H3 Realism People LoRA 是一个专为 H3 设计的适配器,旨在将写实人物的表现力推向新的高度:从经得起推敲的面部微表情,到自然的皮肤毛孔纹理,再到纪录片风格的持机运动感。

  • 训练器:https://fal.ai/models/minimax/h3/ref2va/trainer
MiniMax H3 Realism People LoRA

作为前代 Realism LoRA 的继任者,它在更大的 curated 数据集上重新训练,显著提升了人物镜头的真实度与连贯性。

核心亮点:细节决定成败

  • 🎬 电影级布光与运镜:模拟真实片场的灯光逻辑,赋予画面层次感;运动轨迹带有微妙的“手持摄影”抖动,摆脱了 AI 视频常见的平滑塑料感。
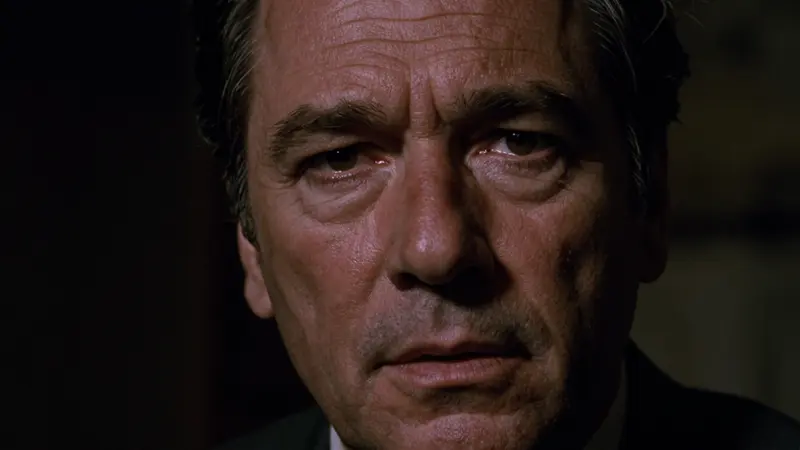
  • 👤 极致的面部与皮肤细节:在特写镜头下,皮肤保持自然的纹理而非过度磨皮,眼睛神采和微表情(如皱眉、眨眼)高度连贯。
  • 🗣️ 原生音画同步保留:在提升画质的同时,完美保留了 H3 原生的音频同步能力,适合生成带对话的人物短片。
  • 🔄 全模式支持:兼容 T2V(文本生成)、I2V(图像生成)和 R2V(参考生成),应用场景广泛。

技术揭秘:为什么高分辨率训练是关键?

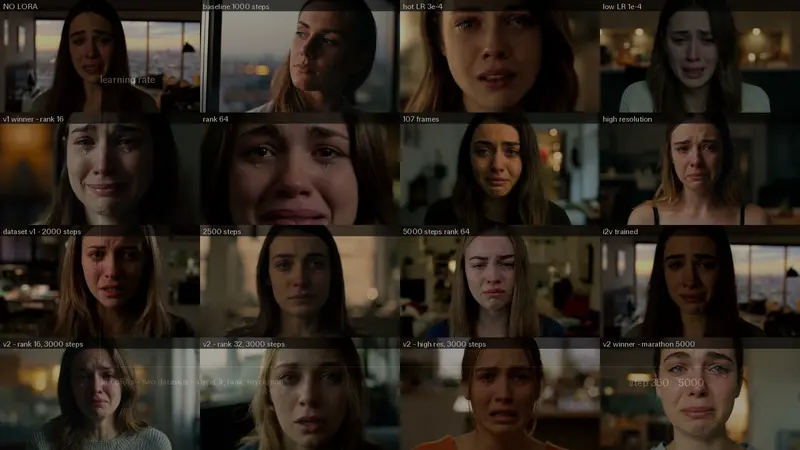
开发者通过 16 种不同配置(步数、rank、学习率、分辨率)的并排人工评审发现,训练分辨率对最终效果的影响远超 rank 大小或训练步数。

  • 高频细节的承载:皮肤纹理、毛孔、细发丝等细节存在于高空间频率中。如果在低分辨率桶中训练,潜空间无法有效承载这些信息,导致 LoRA 学不到真正的“质感”。
  • 最终配置:发布的版本采用 Rank 32,训练 1500 步,并在高分辨率桶上进行训练。这是经过严格对比后,在细节还原与模型稳定性之间取得的最佳平衡点。

使用指南

1. 触发词

在使用该 LoRA 时,请在提示词中加入触发词:

r34l1sm
2. 推荐设置

  • LoRA 强度:通常建议在 0.75 – 1.25 之间调整。对于追求极致写实的场景,可以尝试 1.0 或略高;若希望保留更多原始模型的创意自由度,可适当降低。
  • 搭配建议:该 LoRA 可以与 Turbo LoRA 配合使用以加速推理,但可能需要微调强度以保持风格一致性。

3. 适用场景

  • 人物肖像与访谈:生成逼真的面对面交流场景。
  • 纪录片风格片段:捕捉工人、运动员或日常角色的自然状态。
  • 情感表达特写:需要展现复杂微表情(如争论、喜悦、悲伤)的镜头。

相关图书

vh5tape

vh5tape

如果你想用 AI 复刻八十年代老旧录像带的复古画面,同时配套生成磁带噪音、沉闷单声道音效,vh5tape 这款社区 LoRA 就是专门为 MiniMax H3 全模态视频模型打造的复古风格工具。不同于普通图像滤镜,它可以做到画面损伤效果与音频磁带质感同步生成,一次性产出完整的 VHS 录像片段。
ClipProj-MiniMax-H3

ClipProj-MiniMax-H3

MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。
Minimax H3真实电影质感

Minimax H3真实电影质感

MinimaxH3CinematicRealism 是针对 Minimax H3 视频模型专门训练的风格 LoRA。它的核心作用,是解决 AI 生成视频常见的塑料感、AI 失真问题,直接在模型生成阶段调整光影、色彩、胶片颗粒与镜头语言,让成片拥有真实电影质感。
MiniMax-H3 Fused Turbo (INT8 ConvRot)

MiniMax-H3 Fused Turbo (INT8 ConvRot)

MiniMax-H3 Fused Turbo 是一个经过深度优化的 21 GB ComfyUI 扩散模型文件,专为 MiniMax H3 视频生成设计。它通过融合蒸馏的 Turbo LoRA 和运动平滑风格 LoRA,并采用 INT8 ConvRot 量化技术,实现了在 4 步内完成高质量的文本/图像到视频(T2V/I2V)及参考到视频(Ref2V)生成。