H3-Latent-Upscaler-2x 在处理 MiniMax H3 视频时,传统的放大流程是“VAE 解码 → 像素缩放 → VAE 重编码”,这不仅耗时,还会引入额外的画质损失。H3-Latent-Upscaler-2x 提供了一种纯隐空间的解决方案,它能直接将干净的视频隐空间映射到 2 倍大的空间网格上,全程不触碰像素域。
transformation_lora transformation_lora是一个MiniMax H3的视觉变换LoRA。它可以在两张图片、两种场景之间生成顺滑无缝的视觉形变过渡。模型会拆解初始画面里的主体、轮廓、纹理,再重新组合,自然过渡到目标画面。
ClipProj-MiniMax-H3 MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。
MiniMax-H3-Image pDMD 2-Step LoRA 社区开发者 akhaliq 推出了 pDMD 2-NFE LoRA。该方案通过引入概率分布蒸馏匹配(pDMD)技术,将原本固定为 6 步的去噪过程压缩至 2 次去噪评估(NFE),在保持原生 4096×4096(16 MP)分辨率的同时,显著提升了推理速度。
Viggle-Animate Viggle‑Animate 主打一套特殊的视频角色替换方案:只需要把源视频里某一帧画面,在图像编辑器中修改重绘目标角色,就可以把这个新角色完整扩散到整条视频片段。源视频原本的运动轨迹、相机运镜、时间线全部保留不变。
10Eros-Max 10Eros-Max 是一个基于 MiniMax H3 基础模型的实验性分支,旨在通过特征迁移(Feature Transfer)技术,将 LTX 2.3、Wan 2.2 以及 Krea 2 的学习模式融合到 H3 的 Transformer 架构中。该模型在保留 H3 核心音视频生成能力的同时,显著增强了视觉细节、运动连贯性及文本遵循能力。
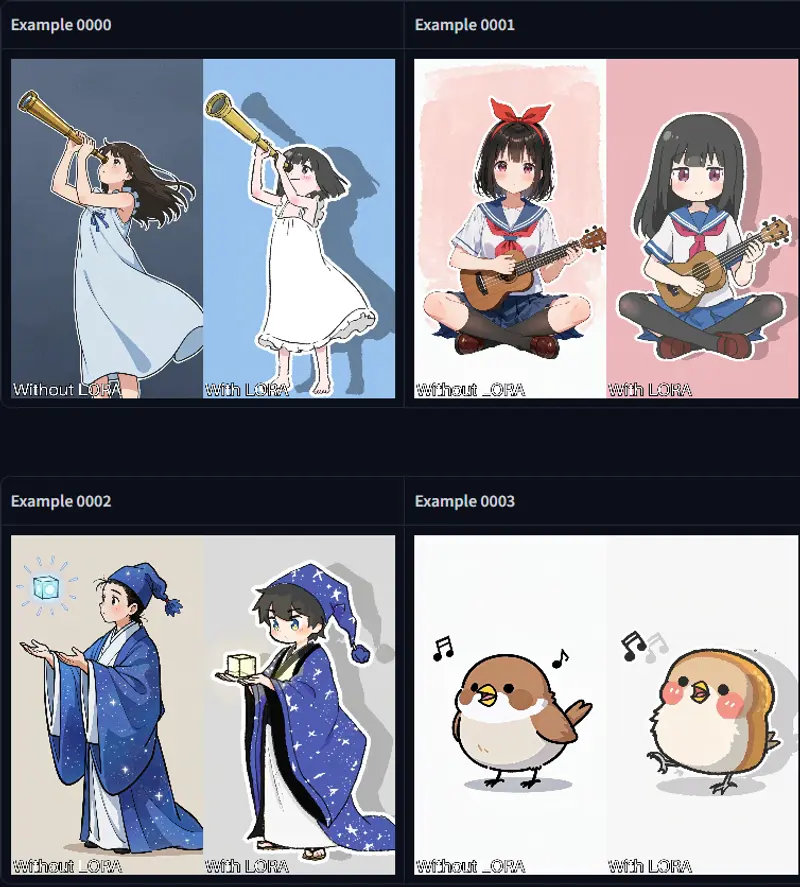
MiniMax-H3-Looping-Sketch-Anime MiniMax-H3-Looping-Sketch-Anime专为生成具有循环动画(Looping)效果的手绘草图风格视频而设计,能够将普通的动态场景转化为充满艺术感的粗糙线条与极简色块。
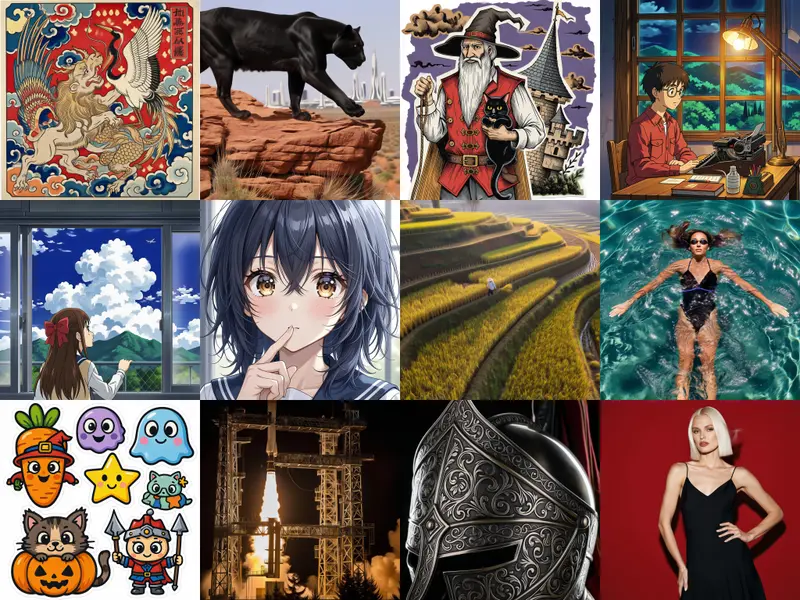
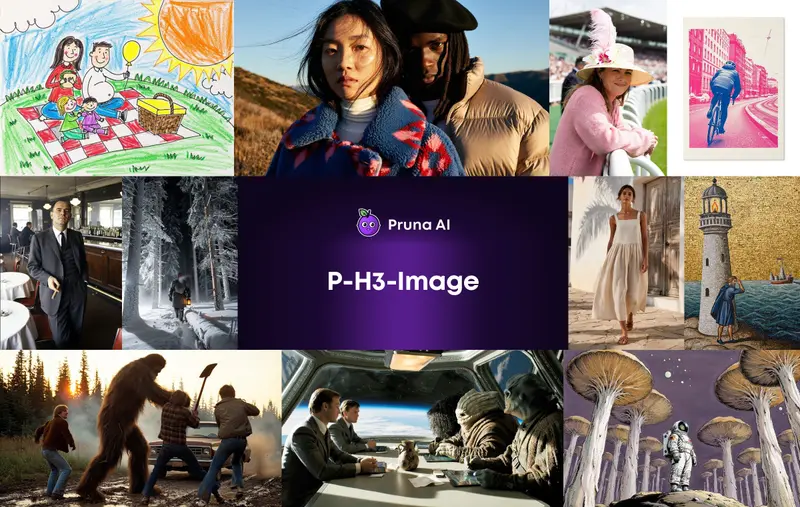
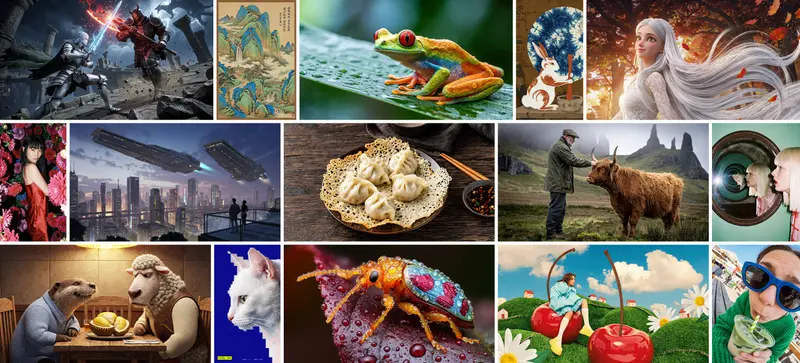
P-H3-Image Pruna AI 推出 P-H3-Image,一款开放权重文生图 + 图像编辑模型,基于 MiniMax H3 视频大模型改造而来。视频模型天生学习物体多角度形态、材质光影、空间一致性,很适合迁移到图像生成
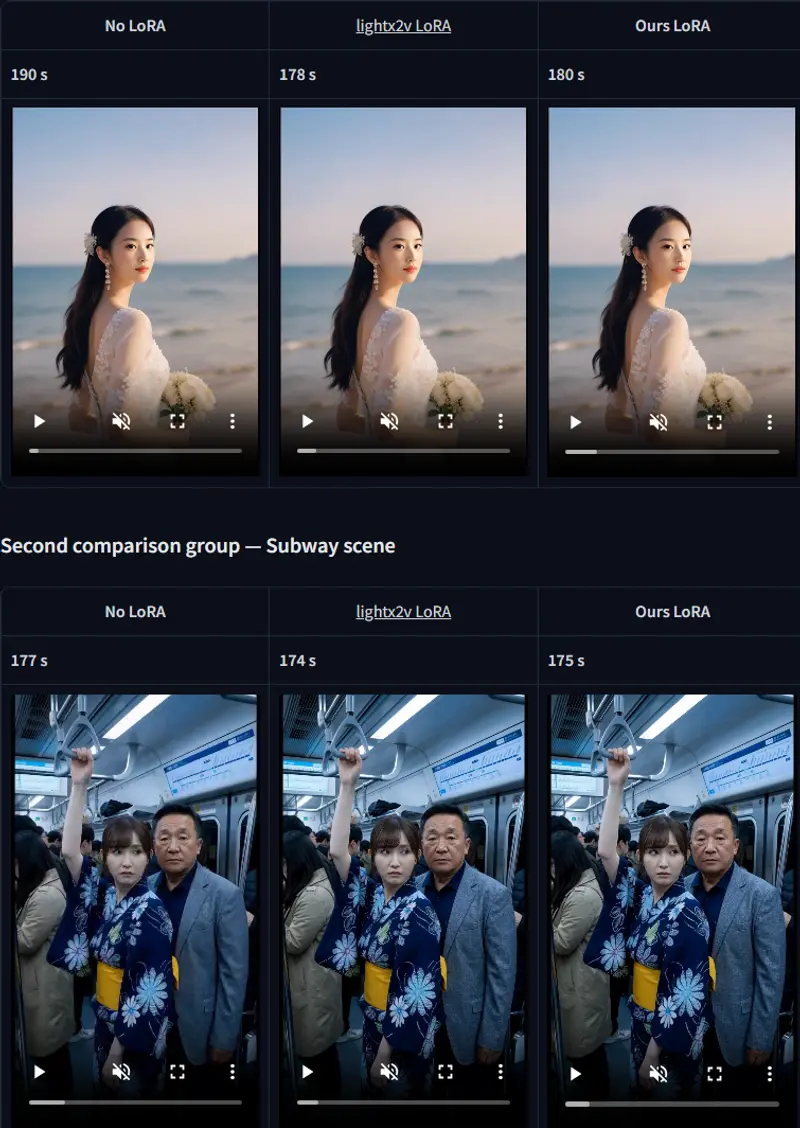
MiniMax H3 Turbo MiniMax H3 Turbo 是一个专为 H3 设计的推理加速 LoRA,它能将文本生成视频(T2V)和图像生成视频(I2V)的采样步数压缩至 4 步,同时保持联合音视频生成的连贯性。
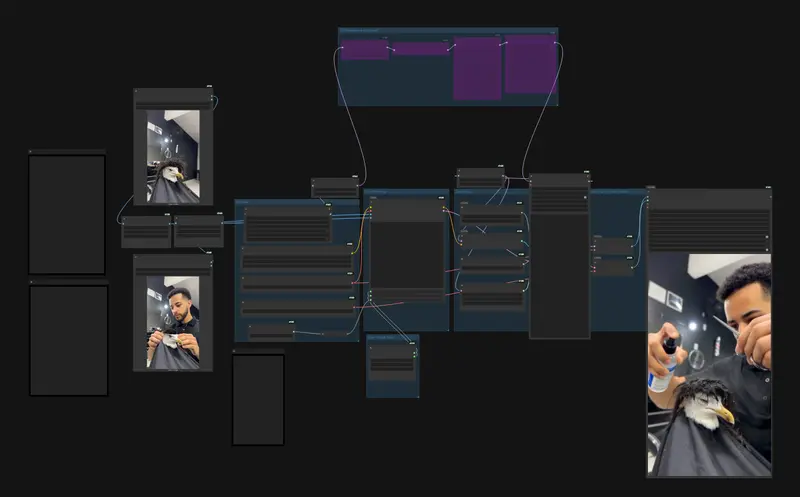
H3 Ripple H3 Ripple 是面向 MiniMax H3 FL2VA 的专用LoRA,核心能力是涟漪式视频编辑:只修改一到两个锚定关键帧,再由这个LoRA把画面改动平滑扩散、贯穿整条视频片段,不用逐帧处理。
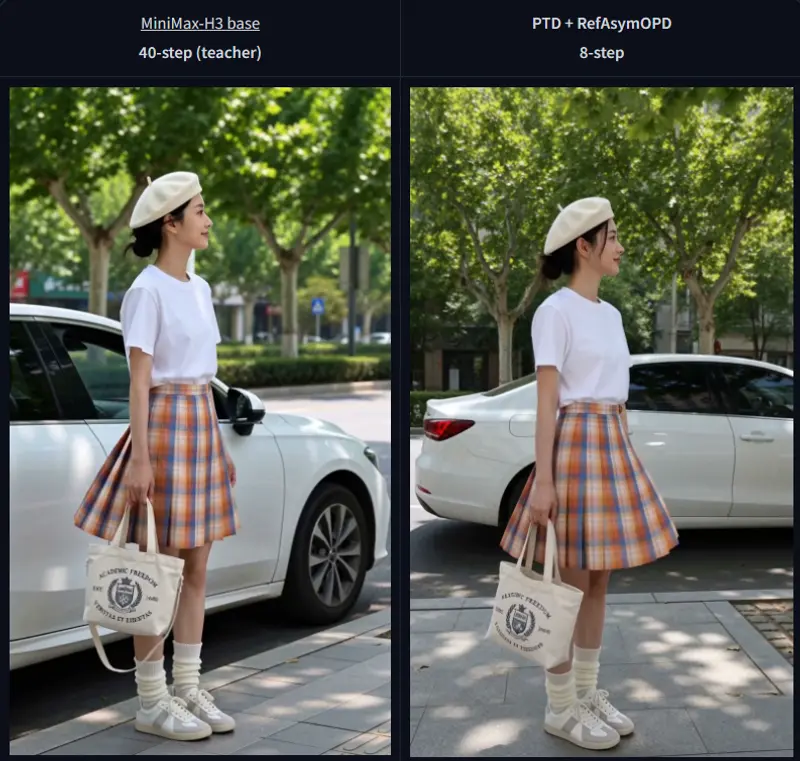
MiniMax-H3-PTD-RefAsymOPD-LoRAs MiniMax-H3 Ref2VA PTD + RefAsymOPD 加速 LoRA 代表了当前参考图像到音视频生成领域的一项高效工程实践。它通过精巧的同策略蒸馏设计,成功打破了“推理速度”与“生成质量”之间的传统权衡,为需要在本地或云端进行高频、高质量 Ref2VA 生成的开发者和创作者,提供了一套低成本、高保真且易于集成的解决方案。
Minimax-H3-Turbo Lightx2v团队发布Minimax-H3-Turbo,为MiniMax-H3模型提供推理加速能力。该LoRA支持4步快速生成,推荐配置为0.75强度搭配er_sde或sa_solver调度器。
MiniMax-H3 Turbo 4-Step — ComfyUI Pruned-Model LoRAs 此Lora由 larryvrh 创建的原始 MiniMax-H3 Turbo LoRA 的第三方 ComfyUI 兼容性转换版本,专为剪枝/曲线形态 MiniMax-H3 检查点设计。转换解决了原始权重张量键命名空间不匹配导致的加载失败问题,并包含两个进一步训练的 checkpoint-500 变体。所有文件均为部分兼容版本,保留核心注意力与MLP适配器,移除51对AdaLN投影以适配剪枝架构。
MiniMax-H3 Fused Turbo (INT8 ConvRot) MiniMax-H3 Fused Turbo 是一个经过深度优化的 21 GB ComfyUI 扩散模型文件,专为 MiniMax H3 视频生成设计。它通过融合蒸馏的 Turbo LoRA 和运动平滑风格 LoRA,并采用 INT8 ConvRot 量化技术,实现了在 4 步内完成高质量的文本/图像到视频(T2V/I2V)及参考到视频(Ref2V)生成。
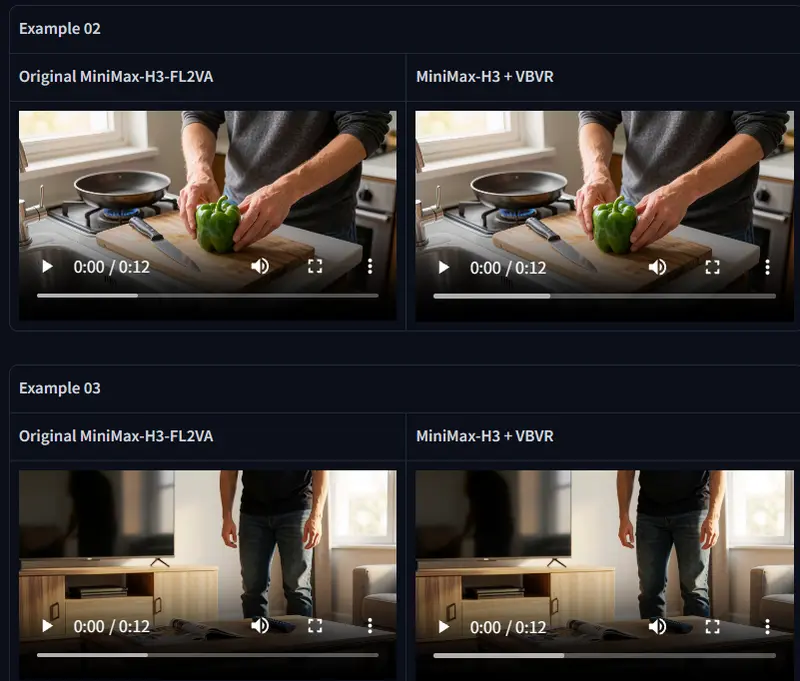
Minimax-H3-VBVR Minimax-H3-VBVR是面向 MiniMax-H3 图生视频(I2V) 的LoRA模型,基于VBVR-Pro-SFT-Video数据集专门做适配重建与重预处理,对齐H3的训练管线,目标解决原生视频生成里常见的空间与物体一致性缺陷。
新MiniMaxImage_hdr_diffusers_vae 社区发布了第三方开发的 MiniMaxImage_hdr_diffusers_vae(简称 HDR VAE)。该变分自编码器(VAE)并非官方原生组件,而是专为优化 MiniMax-H3 的重建与增强工作流而设计。
MiniMax-H3 ORB360 CardSpin MiniMax-H3 ORB360 CardSpin 是适配 MiniMax-H3 Ref2VA 的LoRA。同一份LoRA文件,依靠提示词切换,可以生成两种完全不同的视频动态效果。
TaoMate-H3 TaoMate-H3 是阿里巴巴 TaoLive AIGC 团队开发的低延迟流式音视频生成运行时,底层基于 MiniMax H3,以小块分片形式同步生成音频与视频,支持 480p、768p、1080p 横竖屏分辨率的长连续视频生成。
Pika H3 Flex Pika H3 Flex 是 Pika 推出的面向专业影视迭代的后训练视频音频模型,基于 MiniMax-H3 主干开发,主打极速采样、多参考镜头控制,同时开放本地权重推理,兼顾本地离线运行与云端高清渲染。
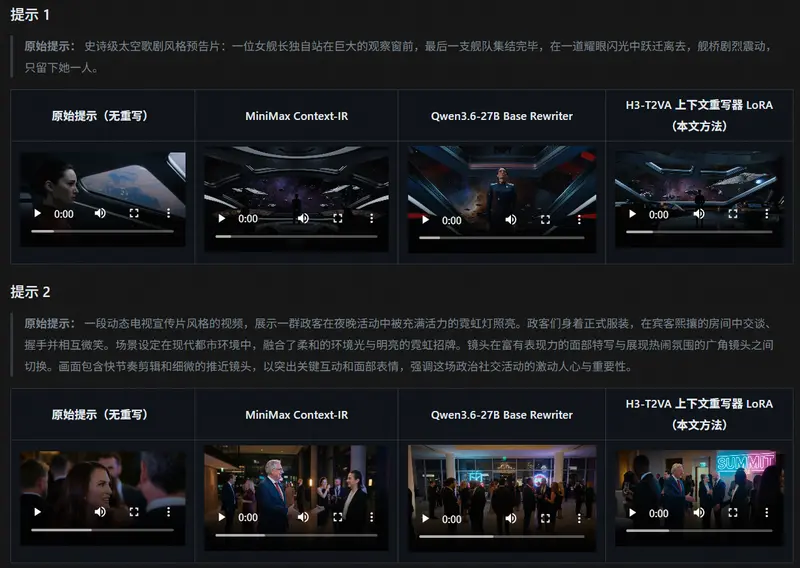
MiniMax-H3 T2VA Prompt Rewriter LoRA lightx2v团队开源的MiniMax-H3 T2VA Prompt Rewriter LoRA是一款基于Qwen3.6-27B微调的LoRA适配器,专为将简短文本提示转换为MiniMax-H3文本生成音视频(T2VA)任务所需的结构化描述而设计。