MiniMax H3 Turbo

294 00

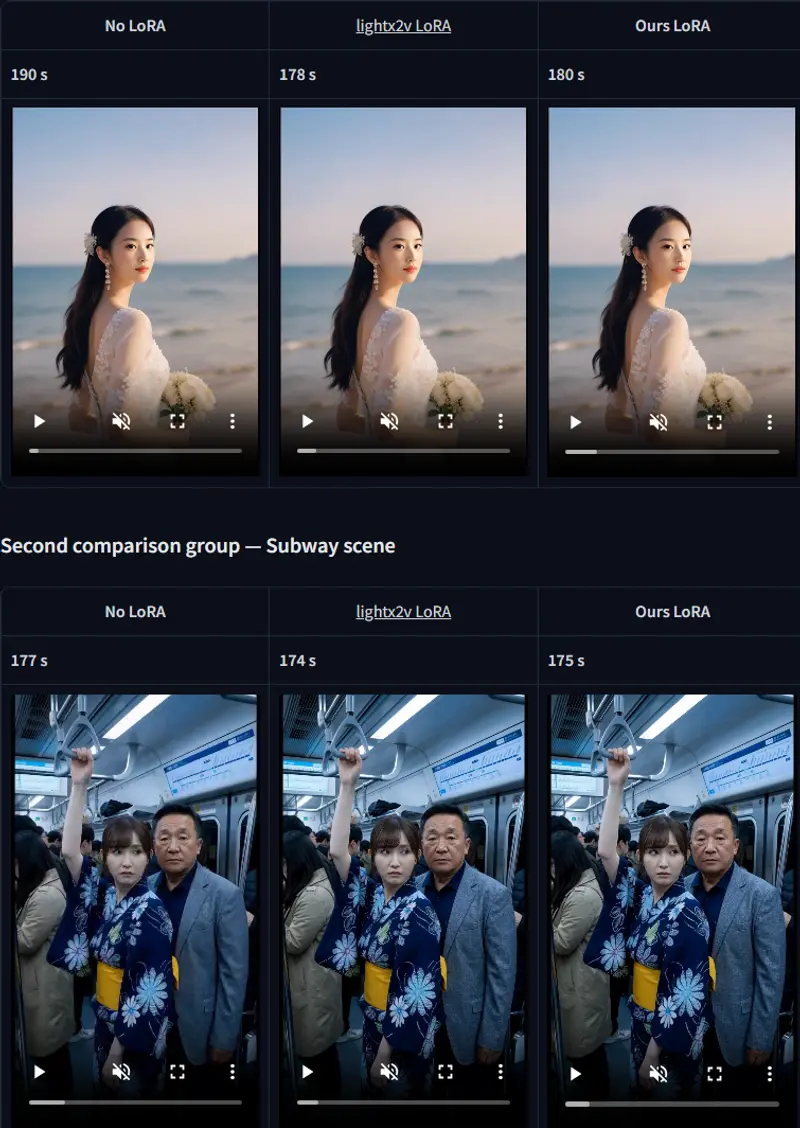
MiniMax H3 Turbo 是一个专为 H3 设计的推理加速 LoRA,它能将文本生成视频(T2V)和图像生成视频(I2V)的采样步数压缩至 4 步,同时保持联合音视频生成的连贯性。
作者
joyfox
基础模型
MiniMax-H3
MiniMax H3 Turbo

在 ComfyUI 中运行 MiniMax H3 虽然效果惊艳,但动辄几十步的采样过程让等待变得漫长。MiniMax H3 Turbo 是一个专为 H3 设计的推理加速 LoRA,它能将文本生成视频(T2V)和图像生成视频(I2V)的采样步数压缩至 4 步,同时保持联合音视频生成的连贯性。

MiniMax H3 Turbo

这不是简单的“跳过步骤”,而是通过修改模型的速度预测场,让模型在极少的评估次数下依然能走出正确的去噪轨迹。

核心亮点:快,且稳

  • 极速推理:仅需 4 步 Euler 采样即可生成 10 秒视频。相比传统的 20-50 步,速度提升显著。
  • 音画同步:LoRA 覆盖了共享的 Transformer 块以及独立的音频/视频输出路径,确保在加速的同时,声音和画面依然保持高度的时序同步。
  • 双模式支持:完美支持 T2V(纯文本驱动)和 I2V(首帧/尾帧控制)。
  • 即插即用:标准的 .safetensors LoRA 格式,直接放入 models/loras/ 即可使用,无需替换基础模型。

推荐设置(严格遵循合约)

为了获得最佳效果,请严格按照以下参数配置你的 ComfyUI 工作流:

参数推荐值说明
LoRA 强度1.0必须全强度加载,否则轨迹会偏离。
采样步数4这是模型训练的固定区间,不可随意增减。
采样器Euler唯一验证过的采样算法。
调度器simple配合 Euler 使用。
CFG禁用 (1.0)Turbo 模型通常不需要 Classifier-Free Guidance。
Sigma 路径特定序列1.0 → 0.9729... → 0.9230... → 0.8 → 0.0

注意:如果你改变了步数、采样器或 Sigma 路径,生成的视频可能会出现严重的伪影或崩坏。

工作原理:学习“捷径”

普通的加速方法往往是粗暴地减少步数,导致每一步的误差累积。MiniMax H3 Turbo 则是通过微调,让模型学会在更大的积分区间内做出更准确的速度预测(Velocity Prediction)。它修改了模型内部的注意力、MLP 以及音视频输出头,使其专门适配这 4 个固定的去噪边界。

如何使用

  1. 下载 LoRA:将文件放入 ComfyUI/models/loras/。
  2. 加载基础模型:使用 minimax_h3_fl2va_pruned_bf16.safetensors(来自 Comfy-Org)。
  3. 应用 LoRA:在模型加载后添加 LoRA 节点,强度设为 1.0。
  4. 配置采样器:选择 Euler,步数设为 4,调度器选 simple,关闭 CFG。
  5. 开始生成:输入提示词或连接首帧图片,点击队列。

注意事项

  • 画质权衡:4 步生成必然会在精细纹理和长期运动稳定性上有所牺牲。它适合快速预览、社交媒体短视频或对极致细节要求不高的场景。
  • 依赖基础模型:这个 LoRA 不能独立运行,必须配对指定的 BF16 基础模型。
  • 实验性:虽然 4 步是官方验证的合约,但你仍可以尝试微调 Sigma 路径或强度来寻找适合你特定内容的“甜蜜点”,但需自行承担崩坏风险。

相关图书

10Eros-Max

10Eros-Max

10Eros-Max 是一个基于 MiniMax H3 基础模型的实验性分支,旨在通过特征迁移(Feature Transfer)技术,将 LTX 2.3、Wan 2.2 以及 Krea 2 的学习模式融合到 H3 的 Transformer 架构中。该模型在保留 H3 核心音视频生成能力的同时,显著增强了视觉细节、运动连贯性及文本遵循能力。
Minimax H3真实电影质感

Minimax H3真实电影质感

MinimaxH3CinematicRealism 是针对 Minimax H3 视频模型专门训练的风格 LoRA。它的核心作用,是解决 AI 生成视频常见的塑料感、AI 失真问题,直接在模型生成阶段调整光影、色彩、胶片颗粒与镜头语言,让成片拥有真实电影质感。
HyperFlow for MiniMax-H3

HyperFlow for MiniMax-H3

Video Rebirth 推出面向 MiniMax-H3 的加速 LoRA 项目 HyperFlow,依靠无数据流自蒸馏训练,将原本 49 次模型前向推理压缩至仅 8 次,在保留视频 + 音频生成能力的同时,实现约 3 倍端到端加速,原生适配 Diffusers 模块化管线。
MiniMax-H3-x-Z-Image-native

MiniMax-H3-x-Z-Image-native

MiniMax-H3-x-Z-Image-native 是一个将 Z-Image 强大的空间注意力特征移植到 MiniMax H3 引擎上的 ComfyUI 原生版本。该模型旨在通过增强场景的丰富度与纹理细节,同时保持 H3 原有的身份一致性,解决传统视频生成中常见的“逐镜头锐化偏移”问题。