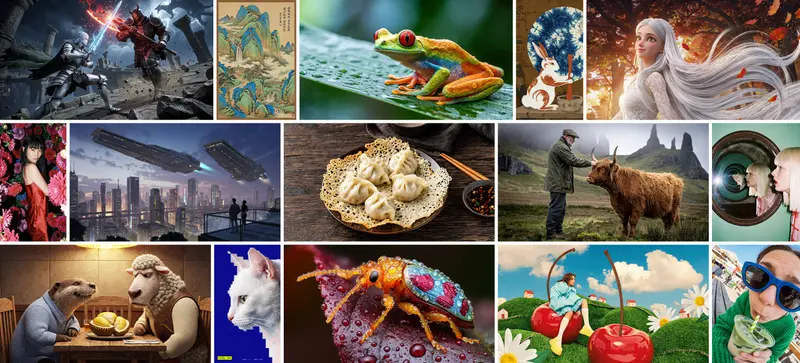
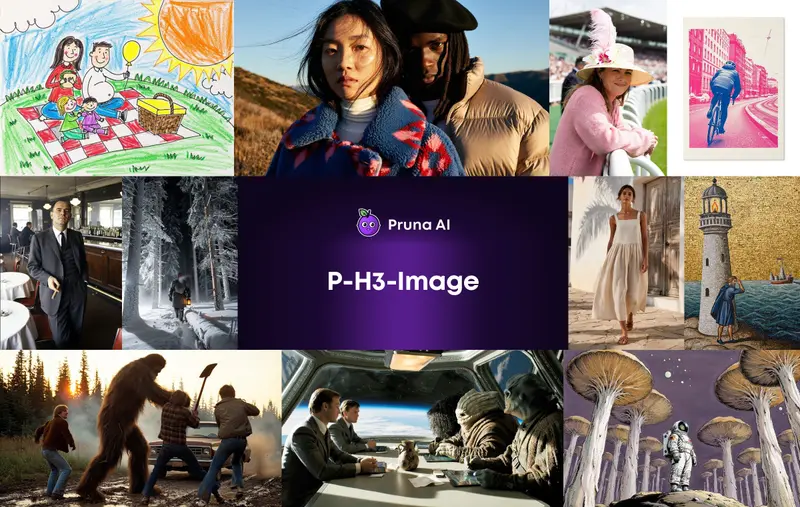
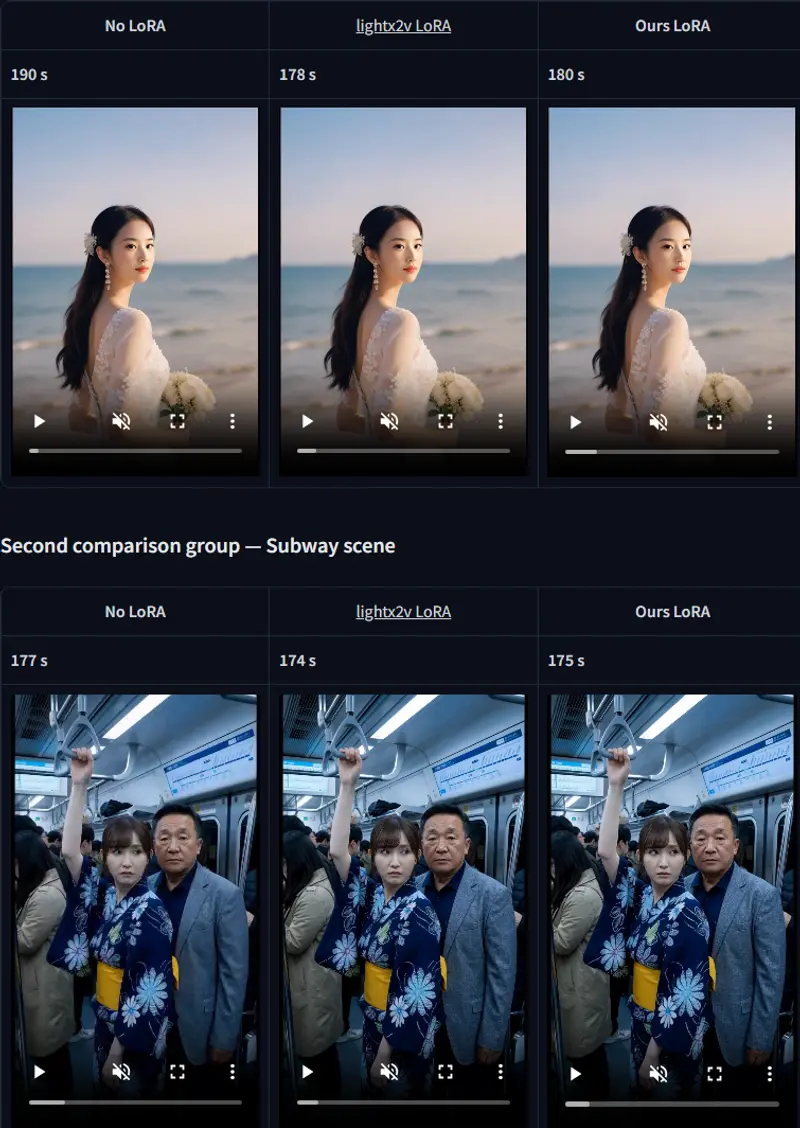
Pruna AI发布了 P-H3-Image,这是一款基于 MiniMax-H3 视频模型改造而成的开源权重图像生成与编辑模型。通过对其底层架构的全面重构与深度优化,该模型成功将原本庞大且缓慢的视频生成模型,转变为高效、轻量且在照片级真实感与电影级场景中表现卓越的开放图像模型。

核心技术重构与优化
为了克服原版 H3 模型生成单张图像时模糊、缓慢且显存占用过高的问题,Pruna AI 对模型的每个组件进行了针对性改造:
- 提示词上采样器 (Prompt Upsampler):基于 Qwen3.5-9B 训练的小型模块,能将用户简短的请求转化为 H3 易于理解的提示词,同时保持输出图像的自然感,避免过度“光泽化”。
- 文本编码器蒸馏:将原版 32B 的庞大文本编码器通过知识蒸馏压缩至 4B(体积从 67 GB 降至 9 GB),在保持图像质量不变的前提下大幅降低了内存开销。
- 扩散调度优化:调整了针对视频优化的调度器以更好地提取图像精细细节,并引入高级 DMD(Distribution Matching Distillation)蒸馏技术,将生成步数从 50 步大幅缩减至 8 步,速度提升约 5 倍。
- Transformer 骨干精简:用更小巧的等效模块替换了原模型中处理时间步的块(占原 Transformer 的 40%),使骨干参数量从 33B 降至 20B,且无需重新训练。
- 单帧专用解码器:重新训练了解码器,使其能够将单帧潜变量直接解码为清晰的静态图像,解决了原版多帧视频解码器在处理单帧时模糊或缓慢的问题。
- 深度量化支持:提供 8-bit 和 4-bit 量化版本。最小化版本下载体积仅 20 GB(原版为 143 GB),8 MP 图像生成峰值显存占用降至约 21 GB。
性能表现与能力边界
- 速度与显存优势:在 NVIDIA B200 上生成 4 MP 图像仅需 2.6 秒(原版 12.4 秒);在消费级/工作站级 L40S (48 GB) 上,4-bit 版本生成 4 MP 图像仅需 6.3 秒。
- 擅长场景:在纪录片与编辑摄影、真实皮肤纹理肖像、电影剧照、动漫帧、绘画版画以及包含简短文本的平面设计中表现尤为出色。同时继承了视频模型的多参考图融合能力,支持最多使用 9 张参考图像进行场景组合与编辑。
- 已知限制:极短、过长或包含大量“炒作词”(如 stunning, 8k)的提示词会削弱生成质量;在 8 MP 以下分辨率时,手部、小背景人物及精细细节可能出现扭曲;小号密集文本(如正文或代码)生成不可靠,但简短的引用文本效果良好。
使用指南与提示词技巧
P-H3-Image 已获得 ComfyUI 的原生支持,用户可直接下载 bf16、8-bit 或 4-bit 权重使用,无需额外自定义节点。为获得最佳效果,官方建议遵循以下提示词规范:
- 明确图像类型:开篇即定义媒介,如 “a photograph by a street photographer” 或 “a frame from an anime TV series”。
- 结构化场景描述:清晰描述视角、主要主体以及光源方向。
- 文本生成规范:若需在图像中生成文字,请用引号括起并保持简短。
- 避免过度修饰:跳过 “masterpiece”、“8k” 等空洞的炒作词汇,它们易导致图像过饱和与不自然的光泽感。
- 图像编辑指令:明确描述最终期望,并指出需保留的元素,例如:“Edit <Picture 1>. The pickup truck is red. Keep everything else exactly as it is.”