MiniMax-H3-Fun-Controlnet-Union

213 00

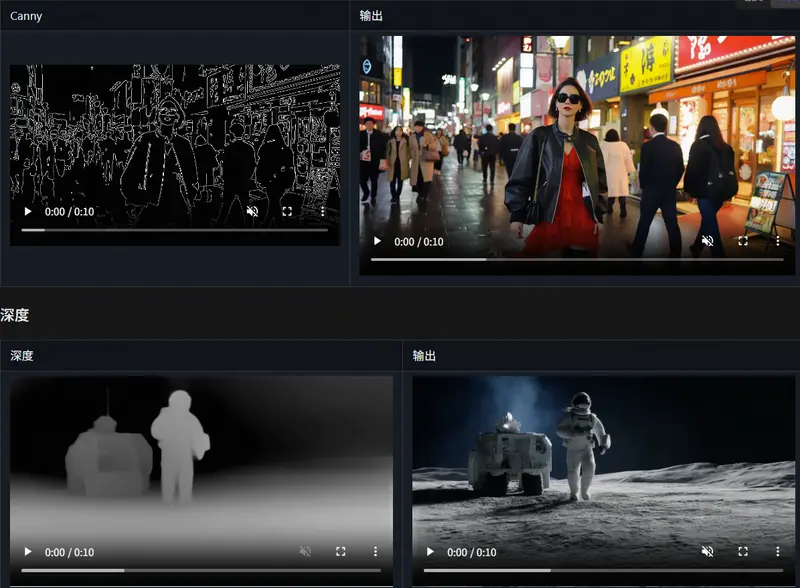
MiniMax-H3-Fun-Controlnet-Union 是一个用于 MiniMax-H3 的 ControlNet-Union 模型,使用 VideoX-Fun 流水线训练而成。单个检查点可使 MiniMax-H3 视频生成器根据 Canny、Depth、HED、MLSD 或 Pose 控制视频进行条件生成,同时也支持视频修复(i...
作者
Alibaba-PAI
基础模型
MiniMax-H3
MiniMax-H3-Fun-Controlnet-Union

MiniMax-H3-Fun-Controlnet-Union 是一个专为 MiniMax H3 视频生成模型设计的通用 ControlNet 分支。基于 VideoX-Fun 流水线训练,它通过单个检查点实现了对多种控制条件(Canny、Depth、HED、MLSD、Pose)的统一支持,并具备强大的视频修复(Inpainting)能力。该模型旨在让用户能够以极高的精度控制视频生成的结构、动作和构图,同时保持高效的推理速度。

MiniMax-H3-Fun-Controlnet-Union

核心特性

  • 统一控制接口:
    • 无需为不同的控制类型切换模型。单个 .safetensors 文件即可处理 Canny(边缘)、Depth(深度)、HED(软边缘)、MLSD(直线段) 和 Pose(姿态) 五种主流控制条件。
  • 引导蒸馏 (Guidance-Distilled):
    • 运行时只需设置 guidance_scale = 1.0。
    • 每步仅需一次前向传播,无需传统的分类器无引导(CFG),显著提升了生成效率。
  • 支持视频修复 (Inpainting):
    • 控制输入通道扩展至 49 维(包含潜在表示、被遮罩的潜在表示及遮罩通道)。
    • 允许用户在保留原视频部分内容的同时,根据控制信号重新生成特定区域。
  • 高效架构设计:
    • 控制分支仅连接到 Transformer 的 5 个关键层(第 0、10、20、30、40 层)。
    • 通过零门控投影(zero-gated projection)将控制信号注入主分支,确保在不干扰基础模型能力的前提下实现精准控制。
  • 可控强度调节:
    • 提供 control_context_scale 参数(0.0 – 1.0)。
    • 1.0 为最强控制效果;降低该值可减弱控制信号的引导强度;0.0 则完全关闭控制分支,回归纯文本生成。

模型规格与部署

  • 文件大小:约 6.8 GB(仅包含控制分支权重:control_proj_in + 5 个 control_blocks)。
  • 依赖要求:必须加载在基础 MiniMax-H3 Transformer 模型之上使用。
  • 格式:.safetensors。

使用指南与最佳实践

  1. 帧数对齐:
    • 生成视频的帧数会自动向下取整到 VAE 可解码的最大值,公式为 17 * n + 5。
    • 时长上限为 15 秒。
  2. 分辨率与宽高比:
    • 画布大小受固定的像素预算限制(Height 和 Width 均为 32 的倍数)。
    • 模型会保持控制视频原有的宽高比进行生成。
  3. 帧率:固定为 24 fps。
  4. 提示词建议:
    • 为了获得更稳定的生成结果,建议在 Prompt 中详细描述场景环境、主体特征以及摄像机视角。
  5. 推荐参数:
    • num_inference_steps: 40
    • guidance_scale: 1.0
    • control_context_scale: 1.0 (默认最强控制)
适用场景

  • 舞蹈/动作迁移:使用 Pose 控制视频,让新角色完美复刻参考视频中的动作。
  • 建筑/室内设计可视化:使用 MLSD 或 Depth 图,根据线稿或深度信息生成逼真的室内场景视频。
  • 艺术风格重绘:使用 Canny 或 HED 边缘图,在保持物体轮廓不变的情况下改变视频的艺术风格。
  • 局部修改与修复:结合 Inpainting 功能,修改视频中的特定物体或背景,而无需重新生成整个片段。

相关图书

HyperFlow H3 Flash

HyperFlow H3 Flash

Video Rebirth 开源 HyperFlow H3 Flash,是基于 MiniMax H3(32B)压缩蒸馏得到的少步视频音频一体化模型,参数压缩至约 14B,支持同时输出视频 + 32kHz 立体声,原生适配 ComfyUI,消费级显卡即可部署,在 4 张 B200 上可实现 768p 视频实时生成。
MiniMax-H3-Image pDMD 2-Step LoRA

MiniMax-H3-Image pDMD 2-Step LoRA

社区开发者 akhaliq 推出了 pDMD 2-NFE LoRA。该方案通过引入概率分布蒸馏匹配(pDMD)技术,将原本固定为 6 步的去噪过程压缩至 2 次去噪评估(NFE),在保持原生 4096×4096(16 MP)分辨率的同时,显著提升了推理速度。
MiniMax-H3-Character-Swap-LoRA

MiniMax-H3-Character-Swap-LoRA

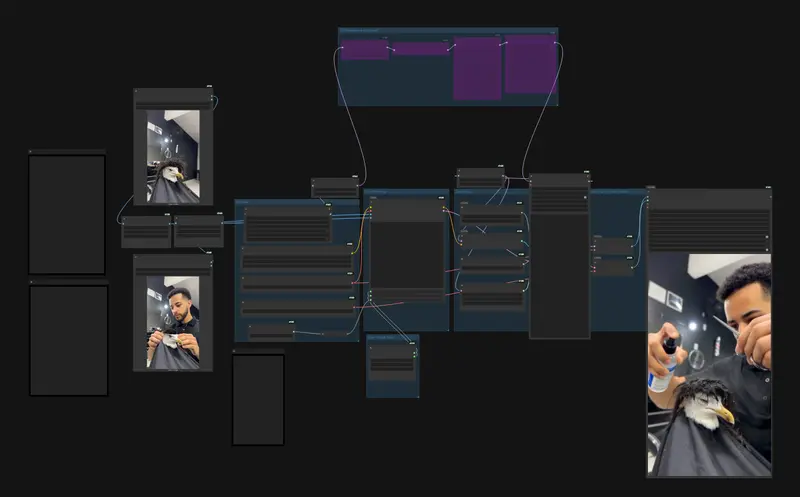
面向MiniMax H3视频模型的专用角色替换LoRA,依托H3 Relay 2.0在ComfyUI搭建端到端工作流,实现“参考图换脸/换角色,保留原视频表演动作”。项目尚在实验阶段,适合短镜头创作,长视频、复杂遮挡场景存在不稳定问题。
FastH3

FastH3

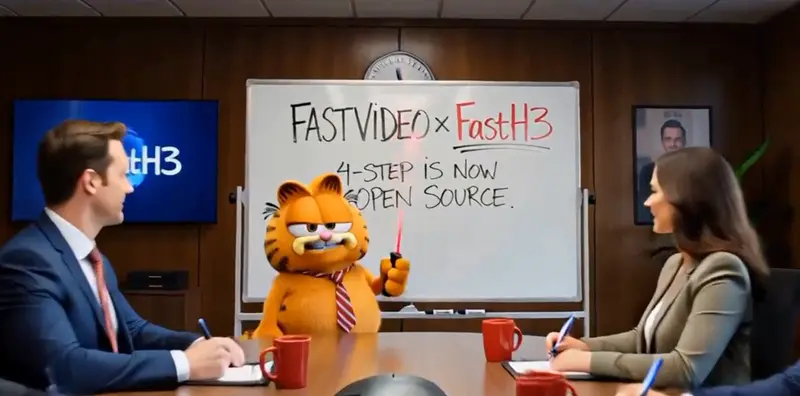
FastVideo 联合 Nuva Lab、英伟达 FastGen 团队推出 FastH3,一款经过稀疏蒸馏优化、面向商用落地的 MiniMax H3 音视频生成开源模型。在单张 Blackwell 架构 B200 显卡上最高实现14.38 倍推理提速,15 秒 768p 音视频生成耗时不到 13 秒,大幅降低原生 H3 的超长等待时间。