H3-Latent-Upscaler-2x

298 00

在处理 MiniMax H3 视频时,传统的放大流程是“VAE 解码 → 像素缩放 → VAE 重编码”,这不仅耗时,还会引入额外的画质损失。H3-Latent-Upscaler-2x 提供了一种纯隐空间的解决方案,它能直接将干净的视频隐空间映射到 2 倍大的空间网格上,全程不触碰像素域。

作者
Mamad8
基础模型
MiniMax H3
H3-Latent-Upscaler-2x

在处理 MiniMax H3 视频时,想把分辨率提升 2 倍通常很麻烦:你得先 VAE 解码成像素,用传统放大器拉伸,再重新编码回隐空间。这不仅慢,还会引入额外的画质损失。H3-Latent-Upscaler-2x 提供了一种更高效的思路:直接在隐空间里把尺寸翻倍,完全跳过像素域的来回折腾。

需要明确的是,这不是一个用来让视频变清晰的放大器。它的输出如果直接解码,可能比原图还柔和。它的核心价值是快和省,让你能在隐空间里无缝衔接后续的高分生成流程。

核心定位:效率优先,而非画质增强

  • 适用对象:仅针对完全去噪的干净 H3 视频隐空间。千万别用在带噪声的中间态隐空间上。
  • 时间维度不变:它只放大空间尺寸(宽高×2),视频时长和音频隐空间保持原样。
  • 非终端工具:如果你只是想增强一段已经做好的视频,请老老实实用传统的像素空间放大器。这个工具是为“继续在隐空间生成”服务的。

工作原理:轻量级校正网络

开发者并没有训练一个庞大的超分模型,而是采用了一种巧妙的策略:

  1. 构建教师数据:将低分隐空间解码 → Lanczos 像素放大 2 倍 → 重新编码,得到“目标高分隐空间”。
  2. 学习残差校正:在一个简单的双线性插值基础上,训练一个轻量级网络来学习“插值结果”与“真实高分隐空间”之间的差异。
  3. 多重损失约束:除了常规的隐空间重建损失,还加入了 SSIM、空间一致性和时间一致性损失,确保放大后的隐空间在时序上是稳定的。

整个过程没有修改 H3 生成器本身,因此它是一个纯粹的、可插拔的后处理模块。

ComfyUI 使用指南

  1. 安装节点:使用 ComfyUI-H3-Latent-Upscaler-Mamad8 自定义节点包。
  2. 放置模型:将 h3_clean_latent_upscaler_v1_mamad8.safetensors 放入 ComfyUI/models/h3_latent_upscalers/ 目录。
  3. 工作流衔接:
    • 输入必须是干净的 H3 隐空间。
    • 放大后若想继续生成高分辨率内容,需要显式地重新加噪并配合高分辨率续作工作流。
    • 音频隐空间可直接透传,无需额外处理。

什么时候该用它?

场景推荐方案
想把已完成的视频变清晰❌ 请用传统像素放大器
想在生成过程中无缝切换到高分辨率✅ H3-Latent-Upscaler-2x
隐空间还在去噪过程中❌ 不支持,仅支持干净隐空间
需要保留原始音频和时间长度✅ 完美支持

相关图书

ClipProj-MiniMax-H3

ClipProj-MiniMax-H3

MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。
Viggle-Animate

Viggle-Animate

Viggle‑Animate 主打一套特殊的视频角色替换方案:只需要把源视频里某一帧画面,在图像编辑器中修改重绘目标角色,就可以把这个新角色完整扩散到整条视频片段。源视频原本的运动轨迹、相机运镜、时间线全部保留不变。
MiniMax-H3-Turbo

MiniMax-H3-Turbo

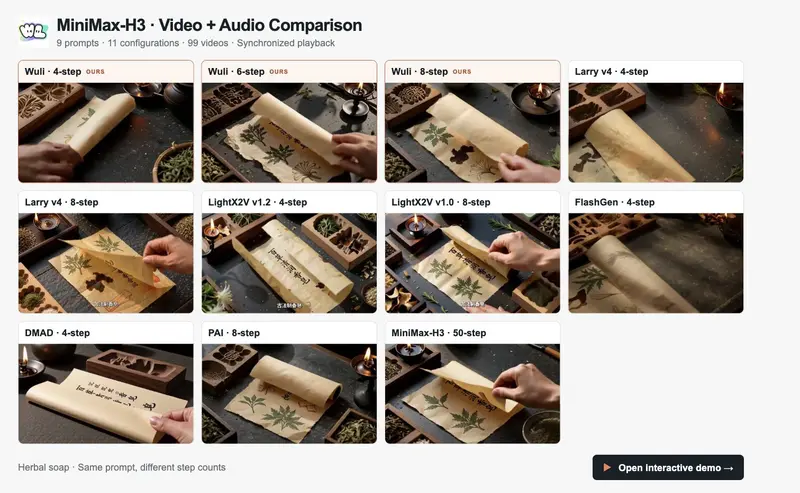
阿里系呜里科技(Wuli)推出MiniMax-H3-Turbo,基于MiniMax-H3模型做加速优化,把音视频生成压缩至最少4步即可完成。项目提供4步、6步、8步三套变体,开发者可以在速度与生成效果之间灵活取舍。
transformation_lora

transformation_lora

transformation_lora是一个MiniMax H3的视觉变换LoRA。它可以在两张图片、两种场景之间生成顺滑无缝的视觉形变过渡。模型会拆解初始画面里的主体、轮廓、纹理,再重新组合,自然过渡到目标画面。