MiniMax-H3-Image-VAE

169 00

MiniMax H3 的默认 VAE 是为视频设计的,处理单张图像时往往需要凑够时间维度,流程比较繁琐。MiniMax H3 single-image VAE 是一个实验性的专用检查点,它能直接把单个时间步(T=1)的 H3 隐空间解码成一张完整的图片。

作者
Mamad8
基础模型
MiniMax H3
MiniMax-H3-Image-VAE

MiniMax H3 的默认 VAE 是为视频设计的,处理单张图像时往往需要凑够时间维度,流程比较繁琐。MiniMax H3 single-image VAE 是一个实验性的专用检查点,它能直接把单个时间步(T=1)的 H3 隐空间解码成一张完整的图片。

MiniMax-H3-Image-VAE

它的目的不是追求极致的画质,而是提供一条简单、直接的单图处理路径。你不需要额外的自定义节点或复杂的解码器头,直接用 ComfyUI 标准的 Load VAE 节点就能加载使用。

重要提醒:别用它跑视频

  • 仅限单图:这个 VAE 是专门为单帧图像微调的。
  • 视频会糊:如果你把它用在视频工作流里,代替原版 H3 VAE,会导致多帧重建质量大幅下降,出现块状网格重影和跨帧混合的问题。
  • 各归其位:做视频请继续用原版 MiniMax H3 VAE,只在处理单张图片往返(Encode/Decode)时使用这个版本。

画质预期:够用,但不完美

由于是针对单帧优化的,它在保留细节上有一些妥协:

  • 整体柔和:输出画面可能会显得稍微有点“肉”,不够锐利。
  • 细节丢失:细小的文字、发丝、树叶边缘或复杂的微纹理可能会变得模糊或消失。
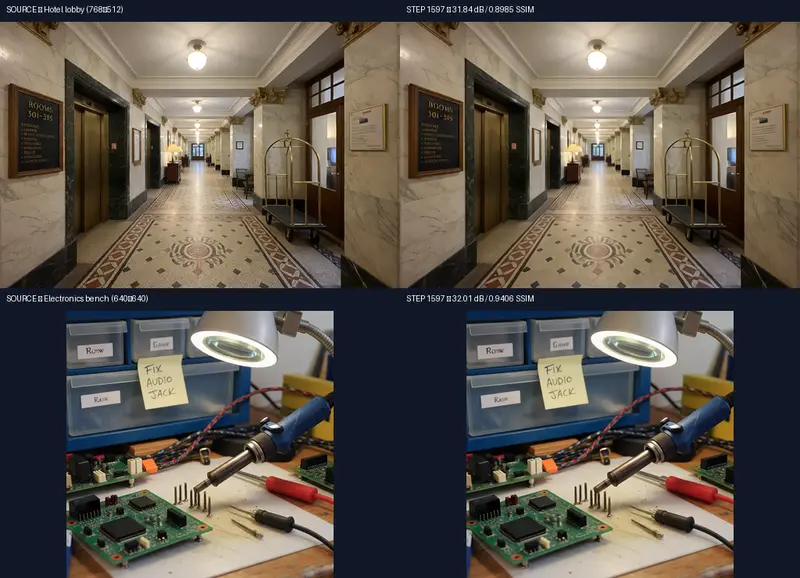
  • 参考指标:在测试集上,PSNR 约为 30.4 dB,SSIM 约为 0.94。对于日常预览或不需要像素级精确的场景,它是完全可用的。

它是怎么来的?

开发者冻结了原版 H3 的编码器,只微调解码器和后量化卷积层。训练数据包括 5 万多张 Booru Essence 图片和伪相机照片,采用了渐进式的分辨率课程(从 256 到 384 像素)。最终选定的第 1597 步模型被合并回了标准的 H3 VAE 格式,所以兼容性很好。

如何在 ComfyUI 中使用

  1. 下载模型:将 minimax_h3_t1_image_vae_step1597.safetensors 放入 ComfyUI/models/vae/ 目录。
  2. 加载节点:使用 ComfyUI 自带的 Load VAE 节点加载它。
  3. 正常连接:配合标准的 VAE Encode 和 VAE Decode 节点使用。
  4. 格式要求:它期望接收的是 MiniMax H3 格式的 24 通道隐空间,且时间维度 T=1。
相关图书

Qwen3-VL-32B Ultra Uncensored Heretic — MiniMax-H3 ComfyUI INT8 ConvRot

Qwen3-VL-32B Ultra Uncensored Heretic — MiniMax-H3 ComfyUI INT8 ConvRot

社区开发者推出了这款基于 Qwen3-VL-32B-Instruct-ultra-uncensored-heretic 定制的文本/视觉条件编码器。 该检查点经过深度裁剪与 INT8 ConvRot 量化,将原本超过 51 GB 的 BF16 模型压缩至约 24.55 GiB,使其能够在 RTX 5090 (32GB VRAM) 等高端消费级显卡上完成加载与推理,是运行 MiniMax-H3 的推荐版本。
MiniMax H3 Realism People LoRA

MiniMax H3 Realism People LoRA

MiniMax H3 Realism People LoRA 是一个专为 H3 设计的Lora,旨在将写实人物的表现力推向新的高度:从经得起推敲的面部微表情,到自然的皮肤毛孔纹理,再到纪录片风格的持机运动感。
MiniMax-H3-PTD-RefAsymOPD-LoRAs

MiniMax-H3-PTD-RefAsymOPD-LoRAs

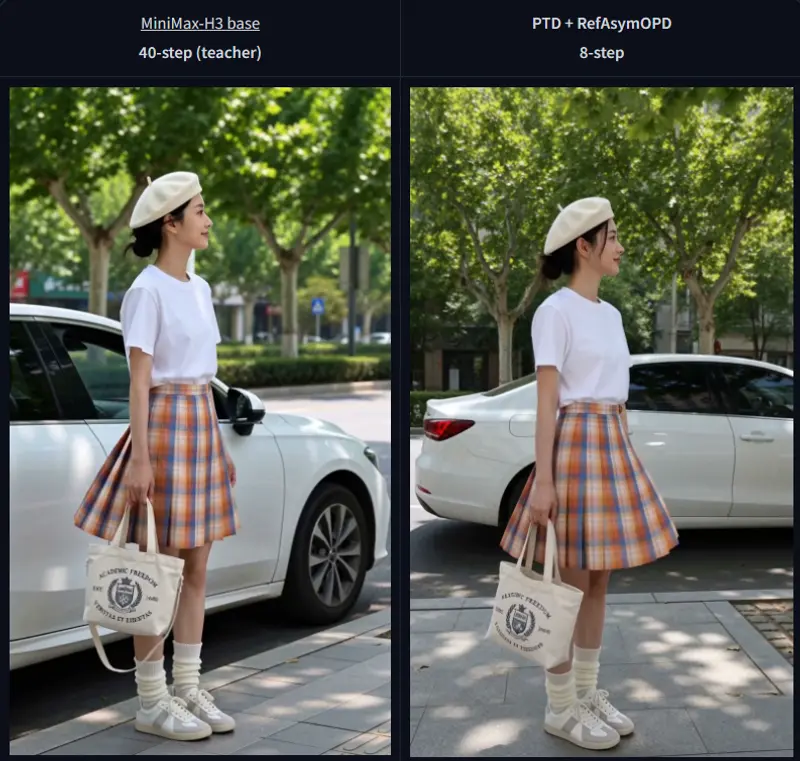
MiniMax-H3 Ref2VA PTD + RefAsymOPD 加速 LoRA 代表了当前参考图像到音视频生成领域的一项高效工程实践。它通过精巧的同策略蒸馏设计,成功打破了“推理速度”与“生成质量”之间的传统权衡,为需要在本地或云端进行高频、高质量 Ref2VA 生成的开发者和创作者,提供了一套低成本、高保真且易于集成的解决方案。
P-H3-Image

P-H3-Image

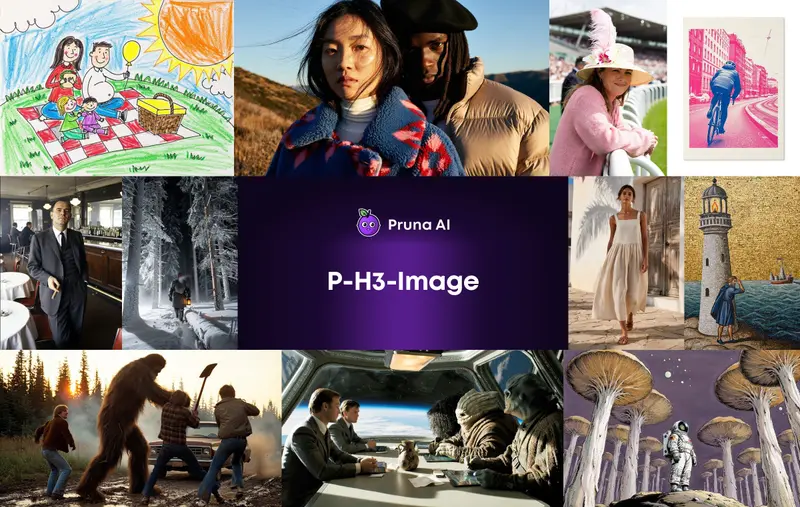
Pruna AI 推出 P-H3-Image,一款开放权重文生图 + 图像编辑模型,基于 MiniMax H3 视频大模型改造而来。视频模型天生学习物体多角度形态、材质光影、空间一致性,很适合迁移到图像生成