动漫视频线稿上色(MiniMax-H3 LoRA)
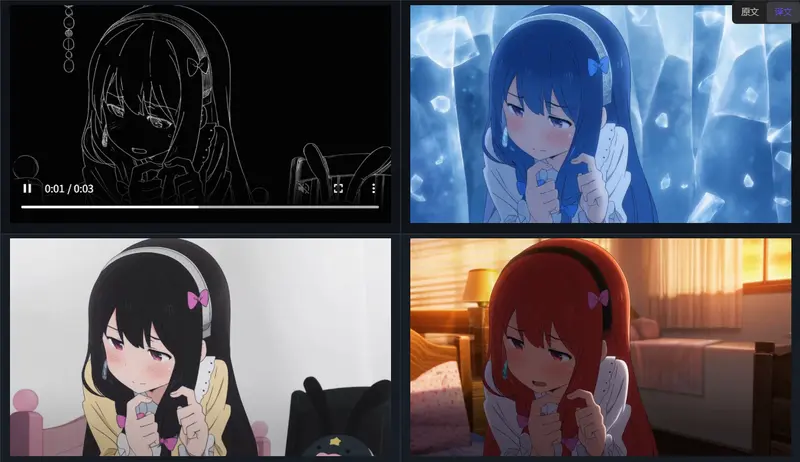
动漫视频线稿上色是在视频生成模型 MiniMax-H3 上微调的 LoRA,能够从输入的线稿视频生成精美的动漫画面。
MiniMax-H3 Fused Turbo 是一个经过深度优化的 21 GB ComfyUI 扩散模型文件,专为 MiniMax H3 视频生成设计。它通过融合蒸馏的 Turbo LoRA 和运动平滑风格 LoRA,并采用 INT8 ConvRot 量化技术,实现了在 4 步内完成高质量的文本/图像到视频(T2V/I2V)及参考到视频...
MiniMax-H3 Fused Turbo 是一个经过深度优化的 21 GB ComfyUI 扩散模型文件,专为 MiniMax H3 视频生成设计。它通过融合蒸馏的 Turbo LoRA 和运动平滑风格 LoRA,并采用 INT8 ConvRot 量化技术,实现了在 4 步内完成高质量的文本/图像到视频(T2V/I2V)及参考到视频(Ref2V)生成。该方案不仅大幅降低了推理步数,还显著减少了显存占用,是目前追求极致速度与效率用户的理想选择。
de-rope(去位置编码干扰)技术,可在两次 4 步传递中实现更干净的运动修复,总成本远低于传统 25 步生成。.safetensors 文件,避免了 ComfyUI 实时加载 LoRA 时产生的巨大显存备份开销(峰值显存从 ~69 GB 降至 ~48 GB)。UNETLoader 即可。| 管道配置 | 步数 | 耗时 (10s, 1152×640) | 备注 |
|---|---|---|---|
| Fused Turbo (本模型) | 4 | 76 秒 | 推荐默认设置 |
| Fused Turbo + de-rope | 4 + 4 | ~374 秒 (冷启动) | 第2次传递仅处理突变帧,画质更稳 |
| 标准单次传递 | 6 | 80 秒 | 略慢于 4 步融合版 |
| 标准单次传递 | 25 | 292 秒 | 传统高质量模式 |
注:在 16GB 显存显卡上,通过 KJNodes 的
MiniMaxChunkFeedForward分块技术,峰值显存可控制在 11 GB 左右,使得该模型在消费级显卡上也可流畅运行。
diffusion_models/minimax_h3_fused_refdelta_r1024_turbo8_mystic07_int8_convrot.safetensorsComfyUI/models/diffusion_models/ 目录。minimax_h3_video_vae_int8_convrot.safetensors & minimax_h3_audio_vae_fp32.safetensors (放入 models/vae/)qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors (放入 models/text_encoders/)ComfyUI-MAINodes (用于 de-rope/DyRoPE) 和 ComfyUI-PlagueKind-Nodes-only-sparse (用于 SLA)。res_multistep / simple (音频表现优于 Euler)warm375 或 warm100 适配器以增强运动幅度,但需注意 warm375 可能会引入轻微的风格偏差(如镜像伪影)。虽然实时堆叠 LoRA 也能达到相同效果,但 ComfyUI 在处理 INT8 模型的 LoRA 补丁时,会为每个被修改的权重保留一份原始副本作为备份。对于 21 GB 的 INT8 模型,这会导致额外的 ~21 GB 显存开销。融合版通过离线一次性完成加法并量化,彻底消除了这一备份需求,使得在有限显存下运行更大分辨率或更长视频成为可能。