FastH3

163 00

FastVideo 联合 Nuva Lab、英伟达 FastGen 团队推出 FastH3,一款经过稀疏蒸馏优化、面向商用落地的 MiniMax H3 音视频生成开源模型。在单张 Blackwell 架构 B200 显卡上最高实现14.38 倍推理提速,15 秒 768p 音视频生成耗时不到 13 秒,大幅降低原生 H3 的超长等待时间。
作者
FastVideo
基础模型
MiniMax-H3
FastH3

FastVideo 联合 Nuva Lab 和 NVIDIA FastGen 团队正式开源了 FastH3。这是一个基于 MiniMax H3 进行后训练的文本到视频与音频(T2VA)生成模型,通过极致的推理优化,为商业级工作负载提供生产就绪的高速视频生成方案。

FastH3

核心亮点:速度与质量的平衡

  • 极致加速:
    • 在单张 NVIDIA Blackwell (B200) GPU 上实现最高 14 倍 的加速比。
    • 在 8× B200 集群上,生成 15 秒 768p 视频仅需不到 13 秒,远低于实时时长。
  • 高质量保留:
    • 使用超过 1,000 小时的 B200 训练时间,配合真实世界的多镜头、视觉音频同步数据分布。
    • 原生支持可变分辨率、宽高比(方形、竖屏、横屏、超宽)和时长,所有能力集成在单个检查点中。
  • 完全开源:
    • 提供完整的模型权重、预提取的 LoRA 以及训练/推理代码。
    • 推荐版本为 4 步 VSA / Data-Free 检查点,无需目标视频数据,仅凭提示词即可训练。

技术原理:如何做到 4 步生成?

FastH3 通过两大核心技术将 Base H3 的 49 次 DiT 调用减少至 4 次,并大幅降低每次调用的计算成本:

  1. 分布匹配蒸馏 (DMD2):
    • 利用冻结的 Base H3 作为教师模型,通过判别器提供的分数估计差异来训练学生模型。
    • 结合反向模拟和合成视频运行,让学生模型在少步状态下也能保持高质量输出。
  2. 视频稀疏注意力 (VSA):
    • 引入可训练的稀疏注意力机制,学生模型仅保留约 10% 符合条件的视频块(90% 稀疏度),使用 tile-64 内核。
    • 文本和音频部分保持密集注意力,确保语义和声音的准确性。
    • 注意:VSA 检查点必须配合 FastVideo 的 VSA-H3 后端和 tile-64 CUDA 内核使用,无法直接替换为密集注意力。

性能基准 (NVIDIA B200)

以下数据为端到端延迟(含编码、去噪、解码、音频混音及文件输出),基于 1344×768 @ 24FPS:

模型 / 运行时时长1× B200 (秒)4× B200 (秒)8× B200 (秒)相对 Base H3 加速比 (1× / 4×)
Base H3 · Dense FA415s678.7193.1–1.0× / 1.0×
FastH3 V1 (VSA / Data-Free)15s47.215.512.8814.38× / 12.48×
FastH3 V1 (Dense / Data-Free)15s91.325.6–7.43× / 7.54×

注:VSA / Data-Free 是推荐的默认性能路径,使用了优化的 tile-64 CUDA VSA 内核、区域 DiT 编译及融合的视频 VAE。
后续发展路线图

  1. 质量与运动增强:发布 8 步模型选项,优化低噪声判别器样本及运动敏感损失,以进一步提升生成质量。
  2. 扩展条件类型:推出 FL2VA(首/末帧到视频)和 Ref2VA(参考图到视频)的蒸馏检查点,支持更复杂的创作工作流。
  3. 并行解码蒸馏 (PDD):与 NVIDIA FastGen 团队合作,应用最新的 PDD 算法进行新一轮训练。
  4. 本地化与多平台支持:优化针对 NVIDIA RTX、DGX Spark 以及 Apple MLX (Apple Silicon) 的运行效率,探索 FP8/NVFP4 量化支持。

如何使用

  • 硬件要求:推荐使用 NVIDIA Blackwell (B200) 以获得最佳性能,但权重本身是硬件无关的,可在其他兼容 H3 运行时的设备上运行。
  • 软件依赖:必须安装 FastVideo 及其 VSA-H3 后端内核。
  • 获取方式:完整权重和 LoRA 已开源,可通过 FastVideo 仓库获取。

相关图书

MiniMax H3 Realism People LoRA

MiniMax H3 Realism People LoRA

MiniMax H3 Realism People LoRA 是一个专为 H3 设计的Lora,旨在将写实人物的表现力推向新的高度:从经得起推敲的面部微表情,到自然的皮肤毛孔纹理,再到纪录片风格的持机运动感。
transformation_lora

transformation_lora

transformation_lora是一个MiniMax H3的视觉变换LoRA。它可以在两张图片、两种场景之间生成顺滑无缝的视觉形变过渡。模型会拆解初始画面里的主体、轮廓、纹理,再重新组合,自然过渡到目标画面。
MiniMax-H3-Character-Swap-LoRA

MiniMax-H3-Character-Swap-LoRA

面向MiniMax H3视频模型的专用角色替换LoRA,依托H3 Relay 2.0在ComfyUI搭建端到端工作流,实现“参考图换脸/换角色,保留原视频表演动作”。项目尚在实验阶段,适合短镜头创作,长视频、复杂遮挡场景存在不稳定问题。
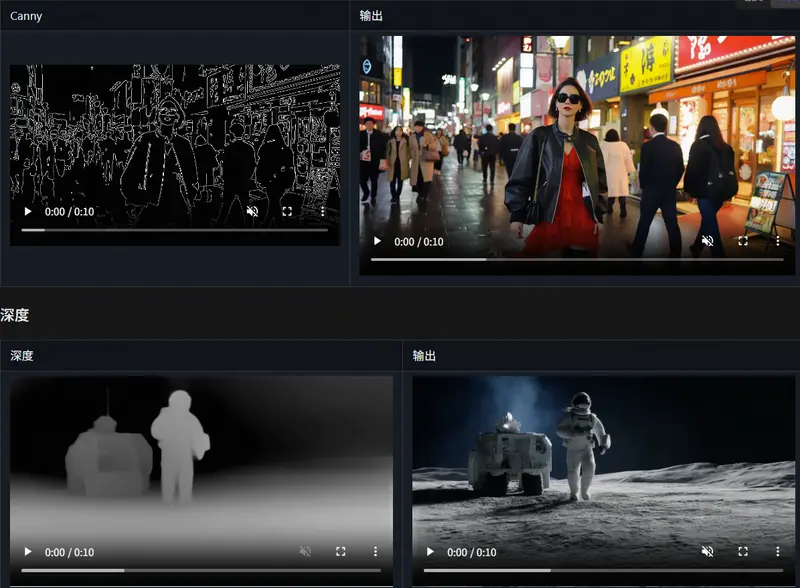
MiniMax-H3-Fun-Controlnet-Union

MiniMax-H3-Fun-Controlnet-Union

MiniMax-H3-Fun-Controlnet-Union 是一个用于 MiniMax-H3 的 ControlNet-Union 模型,使用 VideoX-Fun 流水线训练而成。单个检查点可使 MiniMax-H3 视频生成器根据 Canny、Depth、HED、MLSD 或 Pose 控制视频进行条件生成,同时也支持视频修复(inpainting)。