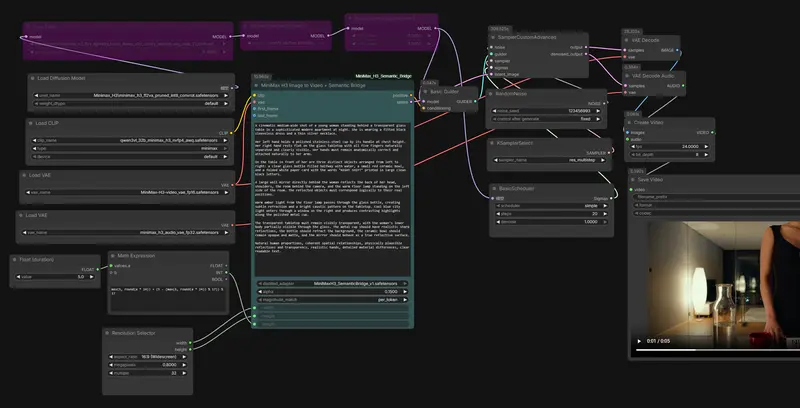
MiniMax H3 Semantic Bridge
MiniMax H3 Semantic Bridge 是一个紧凑的条件空间适配器,解决视频生成模型中常见的“语义结构丢失”问题。它并非传统的 LoRA 或权重合并,而是一个通过跨架构表示迁移与蒸馏技术生成的独立模块(仅约 11 MB)。
如果你想用 AI 复刻八十年代老旧录像带的复古画面,同时配套生成磁带噪音、沉闷单声道音效,vh5tape 这款社区 LoRA 就是专门为 MiniMax H3 全模态视频模型打造的复古风格工具。不同于普通图像滤镜,它可以做到画面损伤效果与音频磁带质感同步生成,一次性产出完整的 VHS 录像片段。
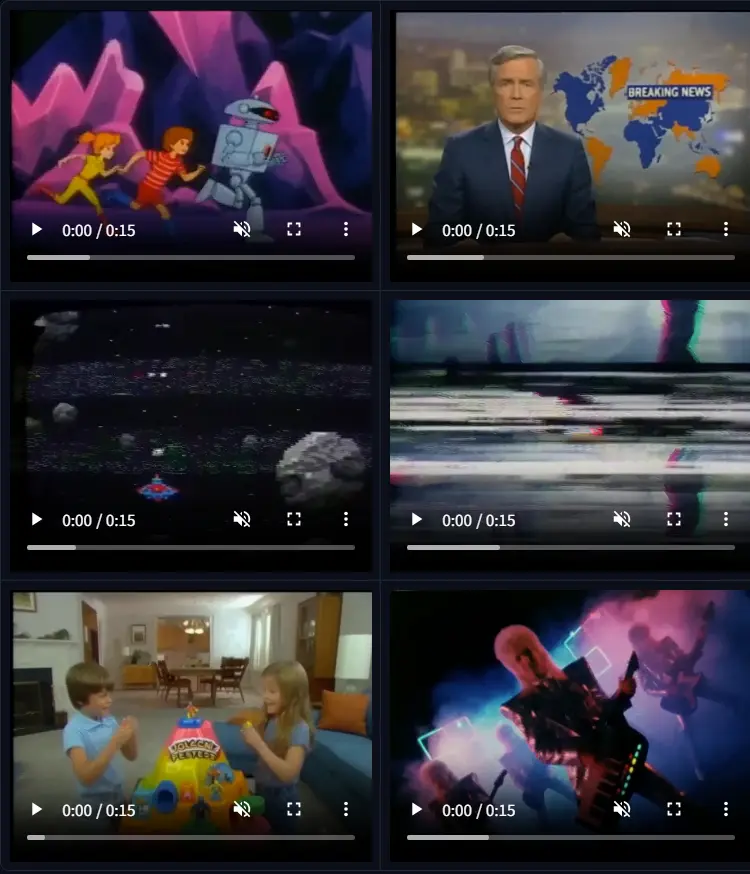
vh5tape 是一款专为 MiniMax H3 视频生成模型设计的风格化 LoRA。它并非简单的后期滤镜,而是通过训练让模型原生理解并生成“从 1980 年代广播电视录制到已过黄金期 VHS 录像带”的完整视听体验。这包括模糊的细节、色度溢出、追踪噪点、磁头切换条带,以及与之匹配的沉闷单声道音频、磁带嘶声和颤音。
该 LoRA 将视觉与听觉的“磨损感”封装为一个可通过提示词精确调节的旋钮,提供三个预设等级:
| 损伤等级 | 推荐提示短语 | 适用场景 |
|---|---|---|
| 轻微 | lightly worn VHS tape with slight analog noise | 怀旧氛围、柔和复古感 |
| 中等 | worn VHS tape recording with visible tape damage | 标准 80 年代电视质感 |
| 重度 | badly damaged VHS tape with heavy tracking errors and distortion | 恐怖题材、Found Footage、极端复古 |
遵循 “触发词优先 → 损伤等级 → 场景描述” 的结构:
vh5tape, badly damaged VHS tape with heavy tracking errors and distortion. A loud
1980s local used car commercial: a salesman in a plaid suit shouts at a car lot
with strings of pennant flags and a spinning price sign, cheesy synthesizer
jingle, echoing announcer voice.
vh5tape 置于提示词最开头。⚠️ 这是最容易踩坑的地方! vh5tape 仅兼容非精炼、非旋转的基础模型。官方 ComfyUI H3 教程默认的
minimax_h3_fl2va_pruned_int8_convrot不兼容,会导致面部扭曲、肢体融化和物体消失。
| 检查点 | 兼容性 |
|---|---|
✅ minimax_h3_fl2va_bf16.safetensors | 强烈推荐 |
✅ minimax_h3_fl2va_pruned_fp8_scaled.safetensors | 可用 |
❌ *_int8_convrot / nvfp4 / w4a8 | 不兼容(旋转/量化基存储) |
vh5tape.safetensors 放入 ComfyUI/models/loras/。UNETLoader(bf16/fp8) → LoraLoaderModelOnly → MiniMaxH3ImageToVideo / 采样器。0.7–0.9 可柔化重度提示的过冲;上调至 ~1.5 可推向几乎无法观看的极端磁带效果(适合恐怖片)。balanced 扩展模式可安全开启,不会丢失触发词和损伤短语。vh5tape-comfyui.safetensors 包含显式 .alpha 张量和基础模型元数据,在第三方加载器中更不易出错,权重与原版逐位相同。