MiniMax-H3-Fun-Controlnet-Union
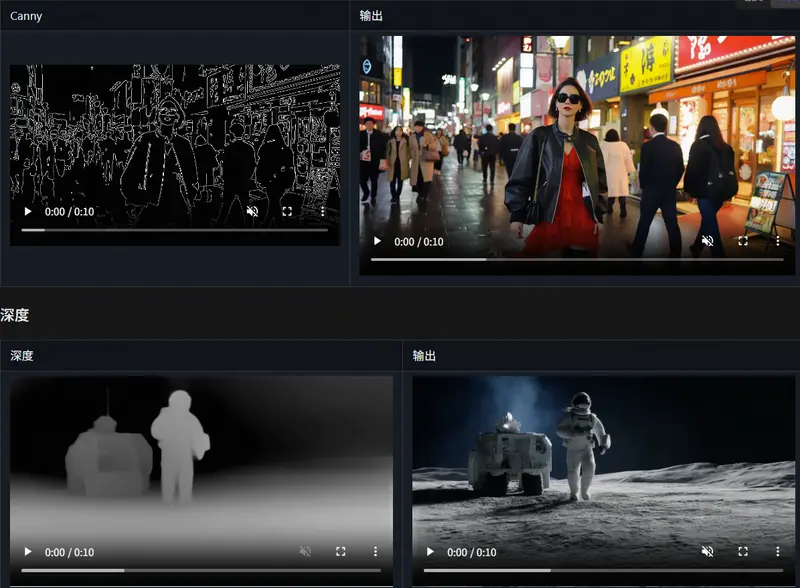
MiniMax-H3-Fun-Controlnet-Union 是一个用于 MiniMax-H3 的 ControlNet-Union 模型,使用 VideoX-Fun 流水线训练而成。单个检查点可使 MiniMax-H3 视频生成器根据 Canny、Depth、HED、MLSD 或 Pose 控制视频进行条件生成,同时也支持视频修复(inpainting)。
Video Rebirth 推出面向 MiniMax-H3 的加速 LoRA 项目 HyperFlow,依靠无数据流自蒸馏训练,将原本 49 次模型前向推理压缩至仅 8 次,在保留视频 + 音频生成能力的同时,实现约 3 倍端到端加速,原生适配 Diffusers 模块化管线。
Video Rebirth 团队发布 HyperFlow,一款专为 MiniMax-H3 设计的 8 步 LoRA 适配器。该模型通过无数据流自蒸馏获得,运行于官方 diffusers Modular Pipeline,将默认 49 次前向传播压缩至 8 次,在 4×H200 上实现端到端约 3 倍加速(每段剪辑从 ~175 秒降至 ~60 秒),同时保持视频+立体声音频的完整输出能力。
HyperFlow 并非通用 LoRA,其文件包含第二个 time embedder 的键,必须使用 hyperflow-h3 包中的 load_hyperflow_lora 加载,而非 diffusers 原生接口。基础权重、VAE、条件器及 t2va/fl2va/ref2va 三种工作流均保持官方版本不变,确保与上游生态完全兼容。
HyperFlow 的核心创新在于对官方管线的三项可逆修改:
TwoTimeEmbedder 包装基础 embedder,为 r 添加带 LoRA 的副本,并用文件中存储的固定 gate 混合两者。条件行(关键帧/参考)保持 r=t,行为与官方去噪器一致。文件格式为标准 safetensors,含 PEFT 风格键(DiT 块 bf16,time embedders fp36)及自描述头(sigmas、gate、rank、alpha、base_model_revision 等),可通过 read_metadata 仅读取元信息而不加载张量。
在 fl2va 工作流(124 帧,1344×768,seed 0)下对比:
| 配置 | 基础 49 NFE | HyperFlow 8 NFE | 加速比 |
|---|---|---|---|
| 4×H200, Ulysses degree 4 | ~175s | ~60s | 2.9× |
| 1×H200, auto CPU offload | ~395s | ~130s | 3.0× |
加速低于理论 49:8 比值,因文本编码与 VAE 解码占比上升。峰值显存约 80GB/卡(LoRA 增 2.8GB);单 GPU 需设 memory_reserve_margin="24GB" 避免 VAE 被驱逐。
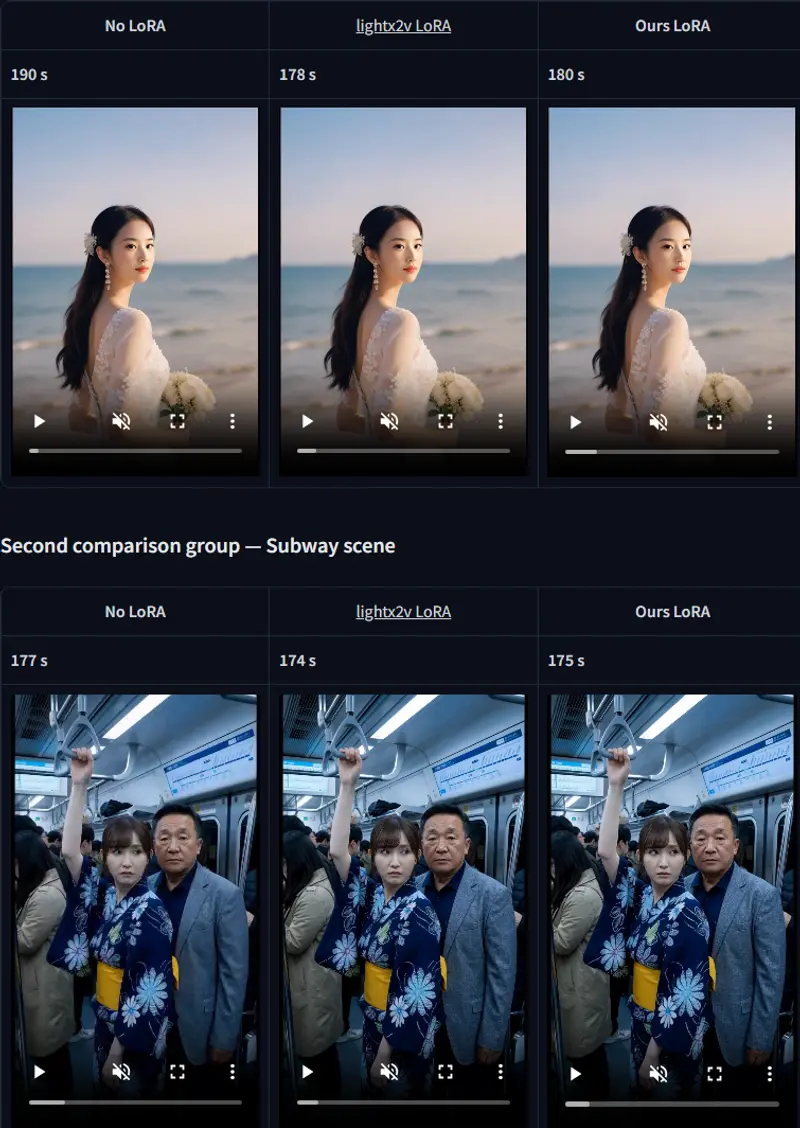
质量方面,自蒸馏以基础模型为唯一教师,在同 seed 下展现更平衡的能力、更好的相机控制、时序一致性及材质细节。但跨 GPU 数量或注意力后端时,仅视觉相似(PSNR ≈27–34 dB);NVIDIA Sol-Attn 稀疏注意力为可选近似(PSNR ≈23 dB),启用前需验证输出。
官方 HyperFlow 未原生支持 ComfyUI,开发者 drbaph 提供两种转换版本:
节点依赖版(推荐)
custom_node_hyperflow_8step_v1.0_comfyui.safetensors(3.67 GiB,完整双时间条件)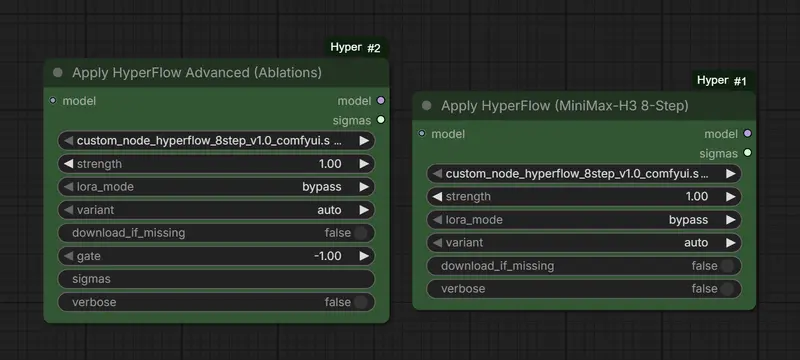
独立 LoRA 版(无需插件)
minimax_h3_hyperflow_8step_v1.0_comfyui_bf16.safetensors 等四种变体(含剪枝/resize 版本)推荐手动 sigma 序列(9 点定义 8 区间):1.0, 0.9939, 0.9843, 0.9661, 0.9231, 0.8349, 0.6969, 0.4688, 0.0
注意:非剪枝文件配完整基础模型,剪枝文件配对应曲线形式基础;原始 diffusers 布局文件会被 ComfyUI 节点拒绝。
load_hyperflow_lora;ComfyUI 节点版需安装自定义节点,独立版可用原生加载器但牺牲精度。--baseline 对比自有提示词。HyperFlow 代表了少步采样在视频生成领域的工程化落地:它不追求通用性,而是在特定模型与工作流上做到极致优化。对于 MiniMax-H3 用户而言,这是目前兼顾速度与质量的最优解;但对其他模型或场景,仍需回归基础管线评估。