H3-Latent-Upscaler-2x
在处理 MiniMax H3 视频时,传统的放大流程是“VAE 解码 → 像素缩放 → VAE 重编码”,这不仅耗时,还会引入额外的画质损失。H3-Latent-Upscaler-2x 提供了一种纯隐空间的解决方案,它能直接将干净的视频隐空间映射到 2 倍大的空间网格上,全程不触碰像素域。
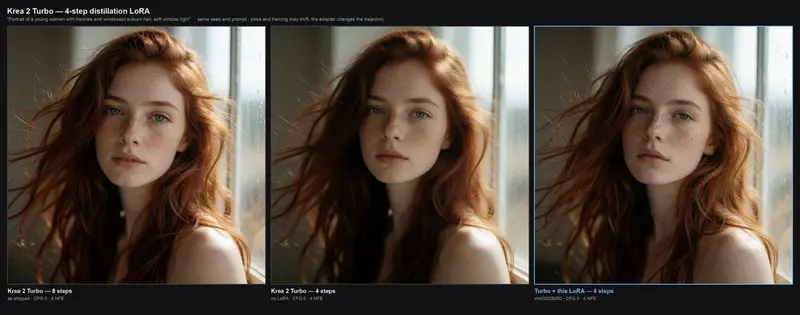
社区开发者 akhaliq 推出了 pDMD 2-NFE LoRA。该方案通过引入概率分布蒸馏匹配(pDMD)技术,将原本固定为 6 步的去噪过程压缩至 2 次去噪评估(NFE),在保持原生 4096×4096(16 MP)分辨率的同时,显著提升了推理速度。
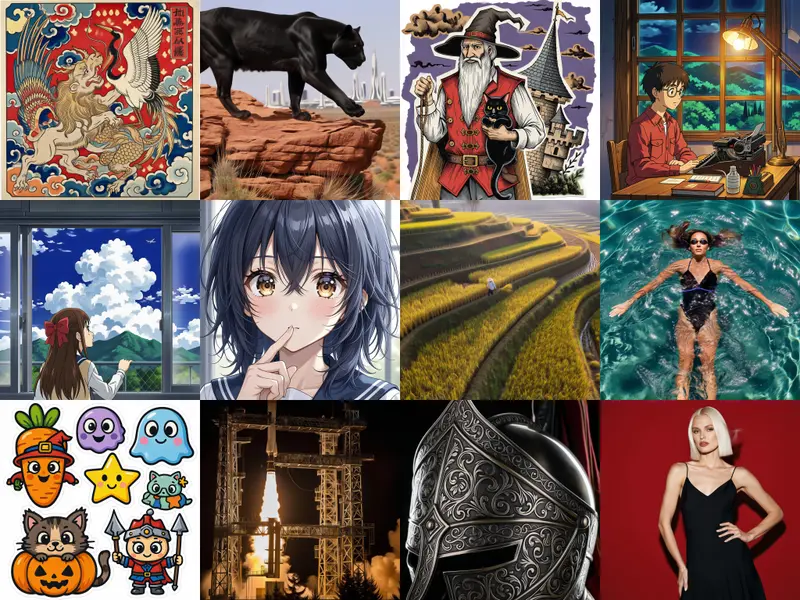
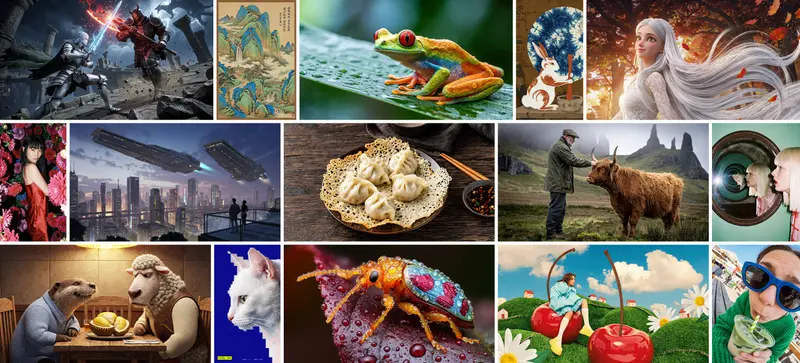
针对 MiniMaxAI 发布的 33.1B 参数图像 Transformer 模型 MiniMax-H3-Image,社区开发者 akhaliq 推出了 pDMD 2-NFE LoRA。该方案通过引入概率分布蒸馏匹配(pDMD)技术,将原本固定为 6 步的去噪过程压缩至 2 次去噪评估(NFE),在保持原生 4096×4096(16 MP)分辨率的同时,显著提升了推理速度。
官方 MiniMax-H3-Image 检查点经过步数蒸馏,其调度器被硬编码为固定的 6 步 PDD 流程。若强行减少步数,模型仍处于去噪中途,导致图像模糊、对比度低且细节缺失。
pDMD 2-NFE LoRA(基于 arXiv 2609.35768)通过以下方式解决这一问题:
在单块 NVIDIA H200 GPU(bf16, FA3)环境下,生成一张 4096×4096 图像的性能表现如下:
| 模式 | 步骤/评估次数 | 耗时 (秒) | 相对速度 | 备注 |
|---|---|---|---|---|
| 官方原生 | 6 步 PDD | ~25.1s | 1.0x | 固定调度,无法减少步数 |
| pDMD 2-Step | 2 NFE | ~17.4s | 1.4x | 构图完整,细节清晰 |
| 2-Step + IC Refine | 2 + 8 步精炼 | ~50.0s | 0.5x | 包含上下文内精炼,质量最高 |
注:在交互尺寸(如 2048×2048)下,配合 FP8 量化与 Triton 构建,2 步生成加轻量级细节通道仅需约 4.6 秒,优于官方 Space 的 7 秒。
该方案已在最新 ComfyUI master (2026-11-10) 上完成端到端验证,支持两种主要部署路径。
使用 minimax_h3_image_pdmd_2step_bf16.safetensors(40 GB),该文件已将 pDMD LoRA 预合并至 Comfy-Org 剪枝版的 bf16 检查点中。
ComfyUI/models/diffusion_models/。适用于已拥有 Comfy-Org 基础检查点的用户,或需要使用 int8_convrot/w4a8 量化权重的场景。
minimax_h3_pdmd_2nfe_comfyui.safetensors (2 GB) 并放置于 ComfyUI/models/loras。为了在 2 步生成的基础上进一步提升微细节(如毛皮、岩石纹理、文字清晰度),可采用“草稿+重新生成”的细节通道方案。
使用官方 Transformer 的第二副本,携带 HyperFlow 8 步 + LMS Sharp + IC LoRA。
对于不使用 ComfyUI 的开发者,可通过 diffusers 库直接加载。
lora_model_0.safetensors(diffusers 布局键)。MiniMaxH3Transformer3DModel,可通过 from_pretrained 加载本仓库预转换的 transformer/ 目录,避免即时转换开销。# 伪代码示例
transformer = MiniMaxH3Transformer3DModel.from_pretrained(...)
transformer.load_lora_weights("lora_model_0.safetensors")
transformer.merge_lora()
scheduler.set_shift(12.0)scheduler.set_timesteps(3) (N 次评估对应 N+1 个网格点)sigmas=scheduler.sigmasMiniMax-H3-Image 对长而完整的视觉描述响应最佳。
h3-image-prompt-writing 技能或 MiniMax-H3-Image-PE 本地扩展短提示词。