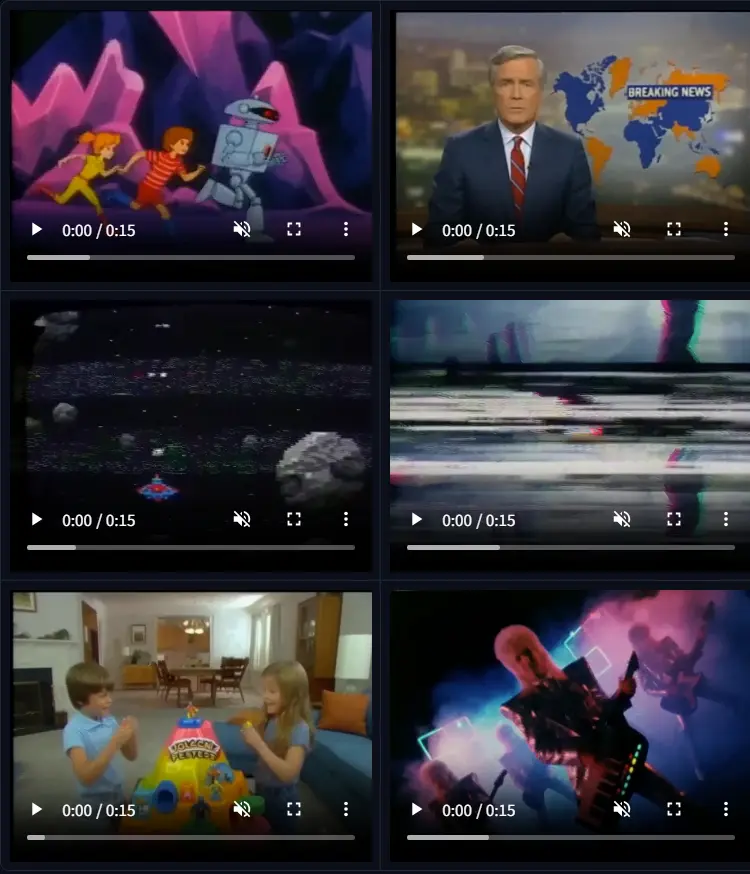
Viggle-Animate
Viggle‑Animate 主打一套特殊的视频角色替换方案:只需要把源视频里某一帧画面,在图像编辑器中修改重绘目标角色,就可以把这个新角色完整扩散到整条视频片段。源视频原本的运动轨迹、相机运镜、时间线全部保留不变。
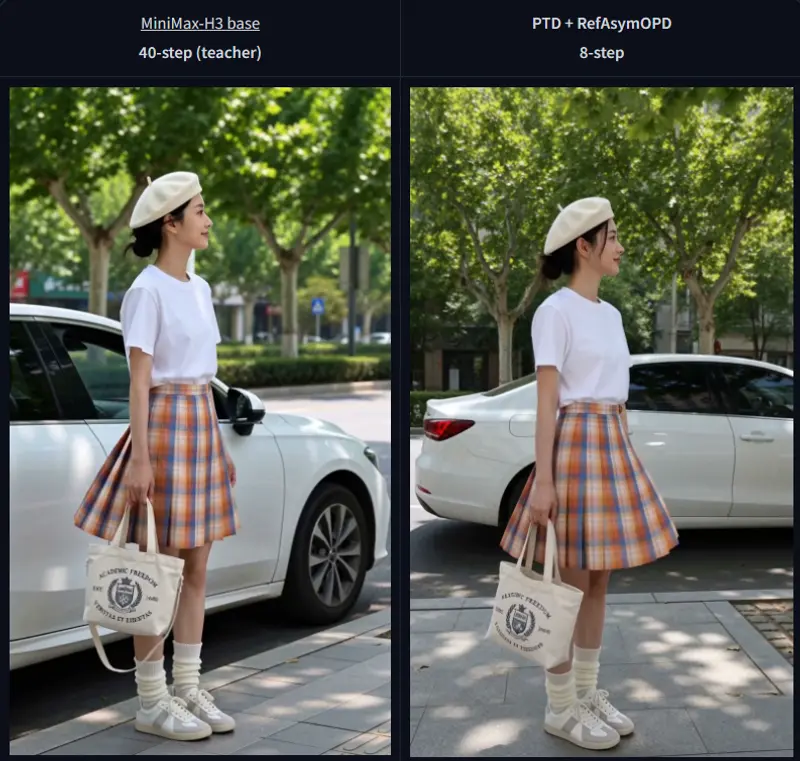
MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。
ClipProj 是一个概念验证项目,通过学习到的线性投影矩阵,使 Qwen3-VL-4B(2560维)能够生成与 MiniMax H3 原生 Qwen3-VL-32B 文本编码器相同的条件控制张量 [seq, 5120]。实测VRAM占用从15.7GB降至5.2GB,无需修改扩散模型、VAE或采样器。核心原理是两模型共享151936令牌分词器,同一提示词产生相同位置令牌,故可用岭回归学习隐藏状态间逐位置映射(无梯度/无轮次/无学习率)。在2000提示词/288k令牌上校准的矩阵达跨提示CKA 0.92、测试余弦0.712、R² 0.507;八倍数据仅提升1.8%余弦,表明线性投影已达上限。
为什么线性投影可行?
性能实测数据
| 校准集 | 令牌数 | CKA | 余弦相似度 | R² | 解读 |
|---|---|---|---|---|---|
| 200 prompts | 37,361 | 0.95 | 0.699 | 0.490 | 小样本已可用 |
| 2000 prompts | 288,608 | 0.92 | 0.712 | 0.507 | +8x数据仅+1.8%余弦 |
| 身份对照 | – | – | ~0 | ~0 | W=0时prompt被忽略 |
| bf16→fp8迁移 | – | Δcos=0.0023 | – | – | 单矩阵覆盖所有4B变体 |
⚠️ 余弦0.71 ≠ 生成质量差:DiT对条件噪声容忍度高;简单prompt、结构化多镜头、fl2va首尾帧均表现良好。但线性投影已达理论上限,进一步提升需MLP非线性映射。
对照实验验证有效性
| 矩阵 | 输出(”a red ball on a wood table”) | ‖W‖ | 结论 |
|---|---|---|---|
h3_control_zero.pt | 乡村风景(prompt完全忽略) | 0 | 基线:无条件信号 |
h3_control_identity.pt | 火焰中金物(不可用) | 50.6 | 原始4B激活无效 |
h3_qwen3vl_4b_tap24.pt | 木桌红球 ✅ | 52.4 | 学习矩阵有效,能量相当 |
若身份对照效果尚可,则学习矩阵无价值——本项目已通过此检验。
必需组件
.pt文件无用)ComfyUI/models/clip_projections/h3_qwen3vl_4b_tap24.pt(推荐,2000 prompt校准)h3_qwen3vl_4b_tap24_200prompts.pt(对比用)Comfy-Org/MiniMax-H3Comfy-Org/Krea-2/text_encoders/qwen3vl_4b_fp8_scaled.safetensors工作流接入
Load Clip Projection (h3_qwen3vl_4b_tap24.pt)
        ↓
Qwen3-VL-4B Encoder → Projected Conditioning → H3 Sampler
节点自动处理归一化:cond = ((h - μ_in)/σ_in) @ W * σ_out + μ_out
替代方案考量
| 需求 | ClipProj适用性 | 更好选择 |
|---|---|---|
| 低显存H3 | ✅ 核心优势 | INT8量化32B(~8GB) |
| 具名引用保真 | ❌ 致命缺陷 | 完整32B编码器 |
| ref2va支持 | ❌ 不支持 | 原生H3工作流 |
| 商业安全 | ❌ 法律风险 | 官方授权方案 |
| 研究探索 | ✅ 理想场景 | – |