MiniMax-H3-Image-VAE
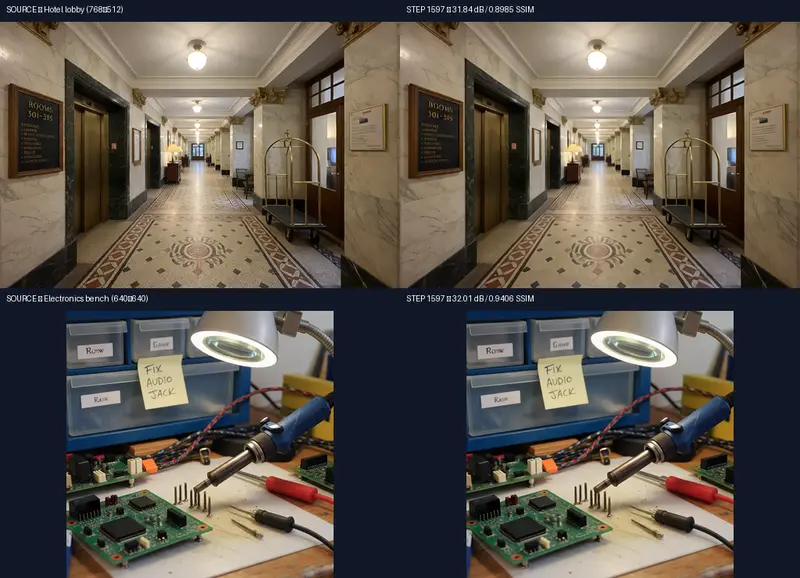
MiniMax H3 的默认 VAE 是为视频设计的,处理单张图像时往往需要凑够时间维度,流程比较繁琐。MiniMax H3 single-image VAE 是一个实验性的专用检查点,它能直接把单个时间步(T=1)的 H3 隐空间解码成一张完整的图片。
阿里系呜里科技(Wuli)推出MiniMax-H3-Turbo,基于MiniMax-H3模型做加速优化,把音视频生成压缩至最少4步即可完成。项目提供4步、6步、8步三套变体,开发者可以在速度与生成效果之间灵活取舍。
阿里系呜里科技(Wuli)推出MiniMax-H3-Turbo,基于MiniMax-H3模型做加速优化,把音视频生成压缩至最少4步即可完成。项目提供4步、6步、8步三套变体,开发者可以在速度与生成效果之间灵活取舍。
整套模型原生支持文本生成视频、首尾帧图引导生成两种模式,视频画面与音频同步输出,不需要单独导出音频文件。三个变体在权重结构上存在区别:4步版本采用轻量化LoRA适配器,内置融合后的视频、音频输出投影层;6步与8步版本则是完整Diffusers格式Transformer权重。项目采用MiniMax-H3社区许可协议分发。
官方提供三类预训练权重:
4步变体只存放适配器,首次运行会自动拉取MiniMax-H3基础模型组件。最终输出文件为封装H.264视频与AAC音频的MP4,不会单独生成WAV音频文件。
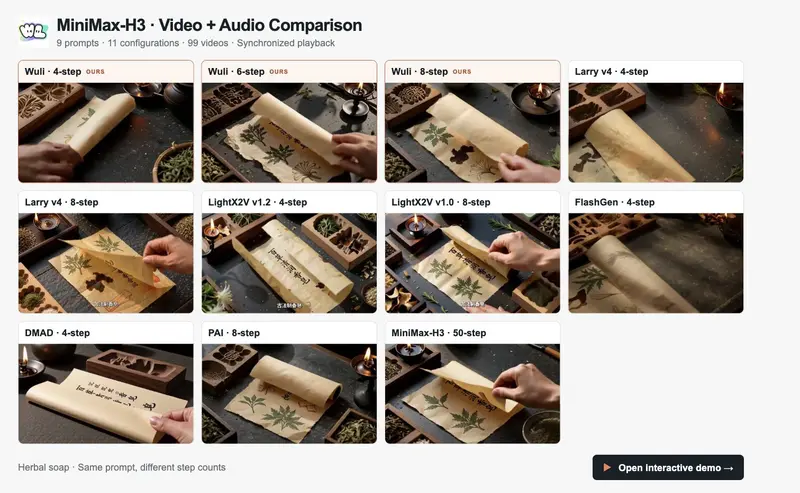
项目团队将这套MiniMax-H3-Turbo,与Larry v4、LightX2V、FlashGen、DMAD、PAI以及原版50步MiniMax-H3做横向对比。
评测集合包含9组提示词、11种模型配置,一共生成99条视频样例。配套演示页面支持同步播放、步数筛选、并排对照,可直接开启音频查看差异。
项目配套开发专属ComfyUI节点包,本地环境可直接调用模型生成音视频并打包为MP4。
环境需要CUDA加速的PyTorch。将节点仓库克隆至ComfyUI自定义节点目录,再安装依赖。
通用版本命令:
cd /path/to/ComfyUI/custom_nodes
git clone https://github.com/wuli-art/MiniMax-H3-Turbo-ComfyUI.git
cd MiniMax-H3-Turbo-ComfyUI
python -m pip install -r requirements.txt
Windows便携版使用嵌入式Python执行:
.\python_embeded\python.exe -m pip install -r .\ComfyUI\custom_nodes\MiniMax-H3-Turbo-ComfyUI\requirements.txt
安装完成后重启ComfyUI。依赖版本要求diffusers==0.40.0、transformers>=4.57.0、peft>=0.17.0,升级旧环境需要重新执行依赖安装。
下载对应工作流文件,直接拖拽进ComfyUI界面。
| 模型变体 | 工作流文件 | 参数调整说明 |
|---|---|---|
| 4步 | t2va_4step.json | steps固定为4 |
| 6步 | t2va_8step.json | 加载后修改steps参数为6 |
| 8步 | t2va_8step.json | steps固定为8 |
默认参数:seed=42,帧数124,分辨率768×1344。
输入提示词,选定采样步数。model_root留空自动下载权重,components_root保持MiniMaxAI/MiniMax-H3。
纯文本生成视频时,断开首帧、末帧输入接口,直接运行工作流。首次启动会自动下载Turbo权重与基础模型组件,成品24fps MP4自动存入ComfyUI输出文件夹。
首尾帧图引导模式,使用fl2va_4step.json或fl2va_8step.json工作流。图像加载节点分别接入first_frame与last_frame;6步版本依旧复用8步工作流,仅修改步数参数。