Viggle-Animate

130 00

Viggle‑Animate 主打一套特殊的视频角色替换方案:只需要把源视频里某一帧画面,在图像编辑器中修改重绘目标角色,就可以把这个新角色完整扩散到整条视频片段。源视频原本的运动轨迹、相机运镜、时间线全部保留不变。
作者
Viggle
基础模型
MiniMax-H3
Viggle-Animate

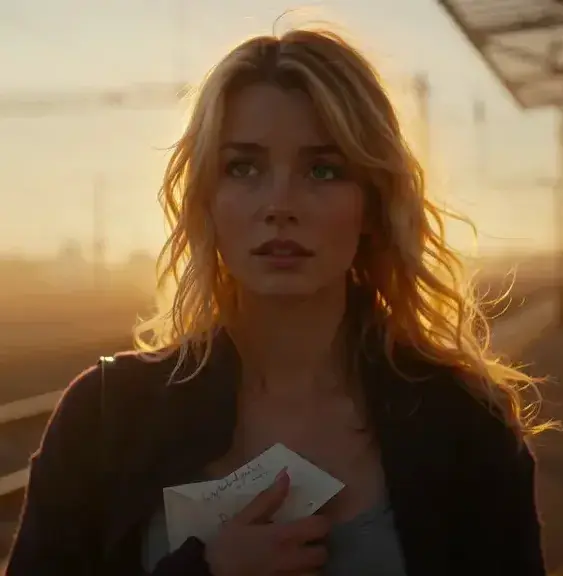
Viggle-Animate 是一款视频角色替换模型,它摒弃了传统的姿态估计、分割掩码和人脸跟踪等中间环节。用户只需在图像编辑器中重绘视频中的任意一帧,模型即可将该编辑精准传播至整个镜头,同时完美保留原始的运动、相机轨迹和时间线。

Viggle-Animate

作为 MiniMax-H3 ref2va Transformer 的 331 亿参数全量微调版本,并通过 DMD 联合蒸馏压缩至仅需 3 次前向传递,Viggle-Animate 在单张 B200 GPU 上渲染 124 帧仅需 26 秒,比 Wan2.2-Animate-14B 快 6.1 倍。

核心优势:极简输入,极致性能

  • 零脚手架依赖:
    • 无中间模型:视频阶段不运行姿态估计器、分割器、人脸跟踪器或文本编码器。
    • 两输入即全部:仅需“驱动视频”+“一帧重绘图”。外观来自重绘帧,几何来自驱动视频,无需额外的对齐或身份编码。
  • 极速推理:
    • 3 次前向传递:通过联合蒸馏(高噪声端学习替换逻辑,低噪声端保留纹理细节),将采样步数从常规的 20-30 步压缩至 3 步。
    • 26 秒/镜头:在 480×832 分辨率、24fps 下,单次渲染耗时仅 26 秒(其中采样仅 13.6 秒)。
  • 动态保真度:
    • 在快速运动(甩头、踢腿、跳跃)场景下表现最强。由于参考帧本身已包含正确的姿态、光照和取景,模型无需重新对齐,避免了传统方法在高速运动下的涂抹与错位。
  • 超越人类的泛化能力:
    • 因循环中无任何“人类”假设组件,它能动画化任何你能绘制的内容:动物(耳朵/鳍状肢自动绑定)、非人形物体(客机机翼绑定手臂)、风格化角色(粘土人)甚至多角色场景。

技术原理:联合蒸馏与全量微调

Viggle-Animate 并非简单的 LoRA 叠加,而是深度定制的产物:

  1. 全量微调 (Full Fine-tuning):基于 MiniMax-H3 ref2va Transformer (33.1B) 进行角色替换目标的全量微调,确保替换逻辑的准确性。
  2. DMD2 联合蒸馏:
    • 高噪声教师:使用微调后的模型监督高噪声端,学习“如何正确替换”。
    • 低噪声教师:使用原始 MiniMax-H3 监督低噪声端,保留“高质量纹理与细节”。
    • 结果:学生模型同时继承了精准的替换能力和优秀的画质,且仅需 3 步即可完成生成。
  3. 固定嵌入条件:文本编码器被移除,取而代之的是一个随权重附带的冻结嵌入 (assets/fixed_prompt.txt),对每次渲染保持一致,进一步降低开销。

性能对比:Viggle-Animate vs Wan2.2-Animate-14B

指标Viggle-AnimateWan2.2-Animate-14B提升
总渲染时间26 秒160 秒6.1x 更快
采样时间13.6 秒140 秒10.3x 更快
前向传递次数34013.3x 更少
预处理需求无需生成姿态/人脸/掩码/背景轨迹零额外开销
参数量33.1 B17.3 B更大容量,更高效率

注:Wan 的 160 秒未包含其预处理通道耗时,实际差距可能更大。

⚠️ 局限性说明

尽管表现卓越,Viggle-Animate 仍有明确边界:

  • 继承图像编辑限制:模型不会添加重绘帧中不存在的内容。若重绘与视频几何冲突,视频姿态优先(如乐高小人仔会恢复人体解剖结构)。
  • 口型同步较弱:特写镜头下口型与语音同步存在滞后,这是训练数据限制而非结构性问题。
  • 复杂交互挑战:多角色紧密交互或频繁切镜场景质量会下降。

仓库结构

  • transformer/:33.1B 参数全量微调底座(bf16, 14 分片)。
  • lora/:秩 128 蒸馏增量(2.5 GB),覆盖 302 个线性层。必须加载在微调后的 Transformer 上,加载到原始模型无效。
相关图书

MiniMax-H3-Image-VAE

MiniMax-H3-Image-VAE

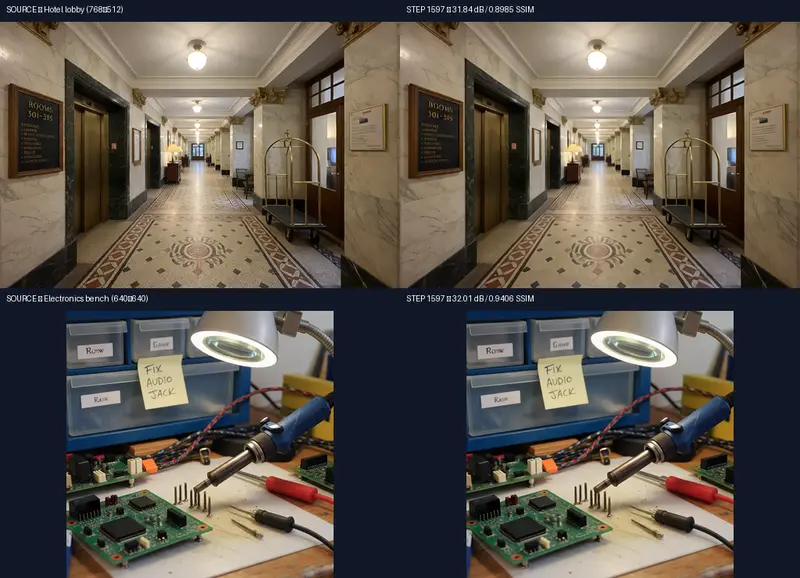
MiniMax H3 的默认 VAE 是为视频设计的,处理单张图像时往往需要凑够时间维度,流程比较繁琐。MiniMax H3 single-image VAE 是一个实验性的专用检查点,它能直接把单个时间步(T=1)的 H3 隐空间解码成一张完整的图片。
H3-Latent-Upscaler-2x

H3-Latent-Upscaler-2x

在处理 MiniMax H3 视频时,传统的放大流程是“VAE 解码 → 像素缩放 → VAE 重编码”,这不仅耗时,还会引入额外的画质损失。H3-Latent-Upscaler-2x 提供了一种纯隐空间的解决方案,它能直接将干净的视频隐空间映射到 2 倍大的空间网格上,全程不触碰像素域。
MiniMax H3 X2 Detail VAE

MiniMax H3 X2 Detail VAE

MiniMax H3 X2 Detail VAE 是一款二合一VAE模型包,配套ComfyUI自定义节点、现成工作流与技术文档。同一个safetensors权重文件,可以切换两种完全独立的工作模式,分别用于视频潜变量2倍解码,或是参考图前置细节增强。
ClipProj-MiniMax-H3

ClipProj-MiniMax-H3

MiniMax H3 的视频生成能力很强,但它的文本编码器(Qwen3-VL-32B)是个“显存杀手”,光这一项就要吃掉 15.7 GB 显存。ClipProj 提供了一个巧妙的解决方案:通过一个学习到的线性投影矩阵,让只有 40 亿参数的 Qwen3-VL-4B 也能产出符合 H3 要求的条件控制张量。