AReA(自适应感受野注意力)是多伦多大学提出的推理阶段外挂增强技术,无需对基础模型重新训练,面向基于扩散Transformer(DiT)架构的高清图像生成,解决原生模型直接生成远超训练分辨率大图时两大痛点:算力成本暴涨、画面结构崩坏(物体扭曲、肢体破碎、物体重复)。
- 项目主页:https://rajabi2001.github.io/area
- GitHub:https://github.com/KooroshRH/AReA
- Demo:https://huggingface.co/spaces/kooroshrh/AReA
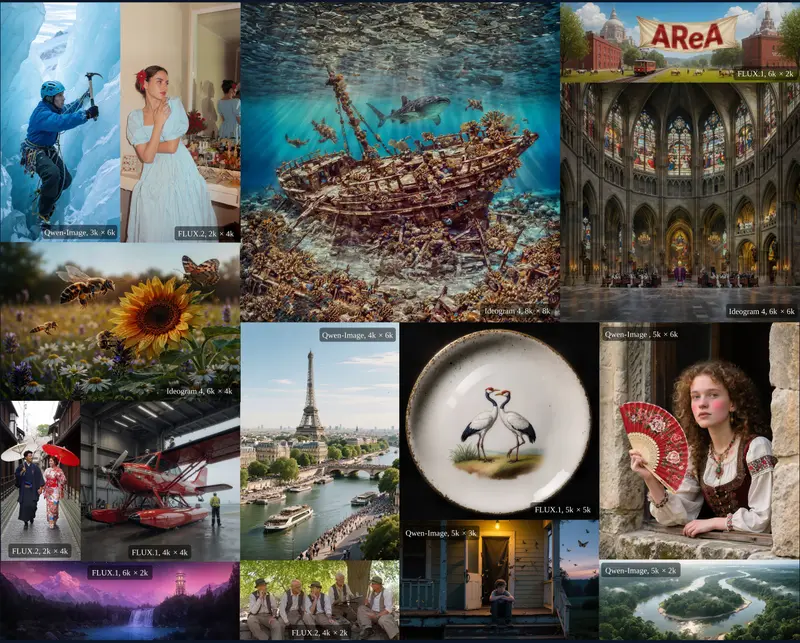
它遵循AI扩散降噪的内在规律,分两阶段动态调整模型感受野:生成前期做跨尺度粗粒度全局注意力,稳住整体构图;后期切换自适应窗口注意力聚焦局部细节,窗口大小还会根据画面纹理复杂度动态变化。搭配缓冲带、窗口随机偏移、跨窗口关键点参考等机制,缓解分块生成带来的接缝、物体重复问题,可对接FLUX.1、Qwen‑Image,当前主要支持FLUX.1,在6144×6144大图场景相比原生全局注意力最高提速3.2倍。
核心功能
- 零训练,即插即用:不改动预训练模型权重,属于推理增强方案,原生支持生成数千像素大图,支持竖屏、宽屏等非正方形比例。
- 两阶段自适应感受野:前期跨尺度降采样全局观察锁定构图;后期逐步收缩窗口,专注局部纹理。依据噪声等级自动判断阶段切换,而非固定步数。
- 内容感知动态分块:平滑低细节区域使用更小计算窗口节省算力;复杂纹理、物体边缘保留更大窗口,防止细节丢失。
- 多重机制修复分块缺陷:窗口边缘缓冲带消除拼接缝隙、窗口位置每轮随机偏移避免固定瑕疵、少量跨窗口参考关键点抑制物体重复复制。
- 兼容主流DiT图像模型:FLUX系列、Qwen‑Image均可接入,不依赖位置编码外推,规避位置外推带来的画面碎片问题。
局限:仅推理增强,无法根除基础模型原生缺陷;极端超高分辨率仍存在小概率瑕疵;不能提升基础模型本身的底层能力,手部畸形、文字错乱等老问题依旧存在。
技术原理
第一阶段:跨尺度粗粒度注意力(构图阶段)
保留原图所有查询token,对参考图像token做分块合并降采样,用区块代表点来代表大片区域。模型依然可以读取全局布局,但参与计算的参考token数量大幅减少,控制算力开销。
文本提示token不参与合并,保证提示词指令完整生效。生成过程中逐步降低合并程度,平滑过渡到下一阶段。
第二阶段:自适应窗口精细注意力(细节打磨阶段)
全局构图稳定后,切换到局部窗口模式。窗口尺寸随生成轮次逐步收缩;同时根据画面内容动态调整窗口大小。
配套三项防瑕疵设计:
- 窗口边缘设置缓冲区域,相邻区块互相读取少量信息,消除拼接缝;
- 窗口位置每轮随机偏移,避免固定坐标反复出现拼接痕迹;
- 选取少量全局关键特征作为跨窗口参考,降低同一物体在多个区块重复生成的现象。
窗口重叠区域做加权融合,输出特征送入解码器生成图像。
阶段切换逻辑
不硬编码固定步数,依靠图像噪声等级判断切换时机:噪声高、构图未成型时维持全局粗粒度阶段;噪声下降,整体布局稳定后转入局部窗口精细化阶段。
实验评测
以FLUX.1、Qwen‑Image为基底,在多分辨率、多种宽高比下,和UltraImage、DyPE、SigMa、SEGA等同类零训练高清方案对比:
- 画质表现:在美学、提示词对齐、物体完整度指标上处于第一梯队,大幅降低大图场景物体撕裂、部件重复;人工盲测中用户更偏好AReA生成结果。
- 加速效果:分辨率越高加速收益越明显;6144×6144下FLUX.1最高提速3.2倍,Qwen‑Image提速2.9倍,中等分辨率同样稳定加速。
- 消融实验验证各模块必要性
- 去掉第一阶段直接局部窗口:全局构图彻底崩坏;
- 去掉第二阶段全程降采样:全局构图正常,但画面缺乏精细纹理、整体偏模糊;
- 移除动态窗口、缓冲带、跨窗口关键点,会分别出现细节丢失、接缝、物体重复。
- 区块合并选用区块中心代表点,效果优于均值、随机采样方案。
- 切换时机影响:切换过早,构图不稳就进入局部模式,结构容易崩坏;切换过晚,留给细节生成步数不足,纹理偏简单;存在较宽的可用阈值区间,鲁棒性较好。
© 版权声明
文章版权归作者所有,未经允许请勿转载。