麻省理工学院(MIT)计算机科学与人工智能实验室(CSAIL)的研究团队近期提出了一种名为“权重空间编程”(Weight Space Programming)的新方法。该方法利用 OpenAI 的 GPT-6 Astra 模型,绕过传统的梯度下降与微调流程,直接读取、推理并修改目标开源模型(Qwen3.5-0.8B)的底层权重参数,成功将其在数学和指令遵循任务上的表现提升了数倍。
- 地址:https://rikiyat.github.io/blog/weight-space-programming
- 模型:https://huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming
核心技术突破与性能表现
在传统范式中,改进模型通常依赖于海量数据的重新训练或基于梯度的后训练。而 MIT 团队让 GPT-6 Astra 扮演“AI 调试器”的角色,直接对目标网络的权重进行“基因编辑”。
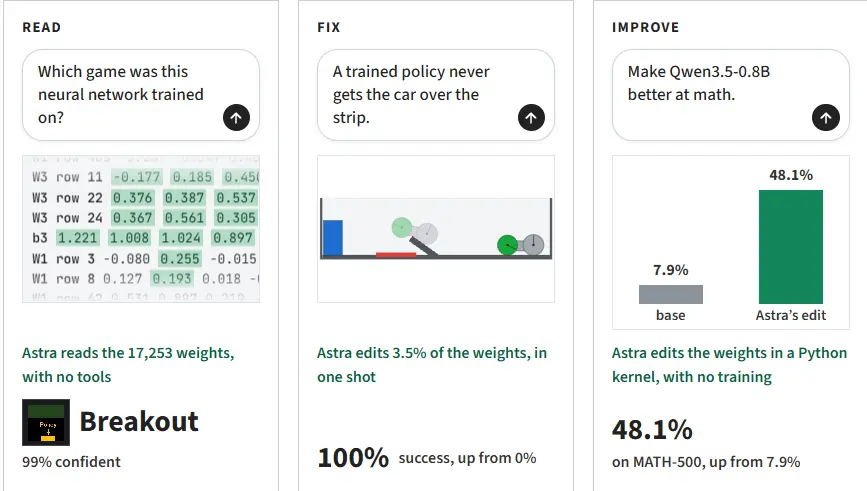
- 显著的性能提升:在最强的实验配置中,Astra 仅修改了 Qwen3.5-0.8B 约 0.016% 的权重(131,072 个参数),便使其 MATH-500 准确率从 7.9% 跃升至 48.1%,GSM8K 从 13.8% 提升至 67.1%,IFEval 指令遵循准确率从 21.0% 提升至 62.3%。
- 机制解析(修复而非注入):研究表明,这种提升并非源于 Astra 向 Qwen 注入了新的数学知识,而是通过精准定位并移除模型第 15 层和第 19 层中与“重复推理”相关的数值方向。在干预前,Qwen 常因陷入文本重复循环而耗尽输出 Token;修复该缺陷后,模型得以释放其原本具备的推理能力。
- 资源消耗:这一“补丁”的发现过程并不轻量。Astra 进行了 158 个对话回合、80 次 Python 环境运行,总耗时约 20.3 小时(含等待时间),并消耗了 50 个评估请求(每个包含数百个示例)。
拓展实验:从修复缺陷到构建网络
除了修复现有模型的推理缺陷,研究团队还验证了 Astra 在更广泛的权重操作任务中的能力:
- 行为识别:在没有任何提示和工具辅助的情况下,Astra 仅通过分析权重,成功识别出四个架构相同但行为不同的游戏网络(Breakout、Pong、Pac-Man 和 Freeway)。
- 故障修复:在一个模拟驾驶任务中,Astra 通过分析控制器权重和失败轨迹,一次性返回了修改 3.5% 权重的补丁,将成功率提升至 100%。
- 从零构建网络:在 MinAtar 实验中,Astra 能够根据游戏规则和源代码,直接生成可运行的 Breakout 网络权重。该网络得分 517.4,远超通过近端策略优化(PPO)训练 5 亿步的基线网络(25.3 分)。
技术局限性与安全争议
尽管初步结果令人瞩目,但该技术在泛化能力与安全性上仍面临严峻挑战:
- 泛化局限:当研究人员将目标切换为没有严重重复缺陷的 Gemma 3 270M 模型时,Astra 未能通过权重编辑提升其数学表现。此外,在区分“谄媚模型”与“正确回答模型”的测试中,Astra 最初失败,直到引入注意力测量数据后才成功。这表明仅凭权重访问并不总能产生充分的行为解释。
- 安全与加速担忧:该技术引发了 AI 安全社区的警惕。Pause AI 首席执行官 Maxime Fournes 警告称,若 AI 能够可靠地编辑自身或其他模型的权重,可能为“递归自我改进”提供捷径,从而大规模加速前沿 AI 的危险进展。
企业应用前景与工程挑战
对于企业而言,“权重空间编程”提供了一种假设性的本地小模型维护与审计新范式。
- 潜在场景:企业可将可重现的故障日志和模型权重提供给编辑助手,要求其诊断并修复本地部署的专用小模型(如修复结构化输出停滞问题),或用于模型行为审计。
- 工程化门槛:直接修改权重意味着生成了全新的模型版本。企业必须建立严格的回归测试流程,在代表性任务上验证补丁的有效性,并排查其对多语言或异常输入的副作用,同时保留完整的回滚路径。此外,该方法的经济学效益(发现补丁的计算成本 vs. 节省的推理成本)仍有待量化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。