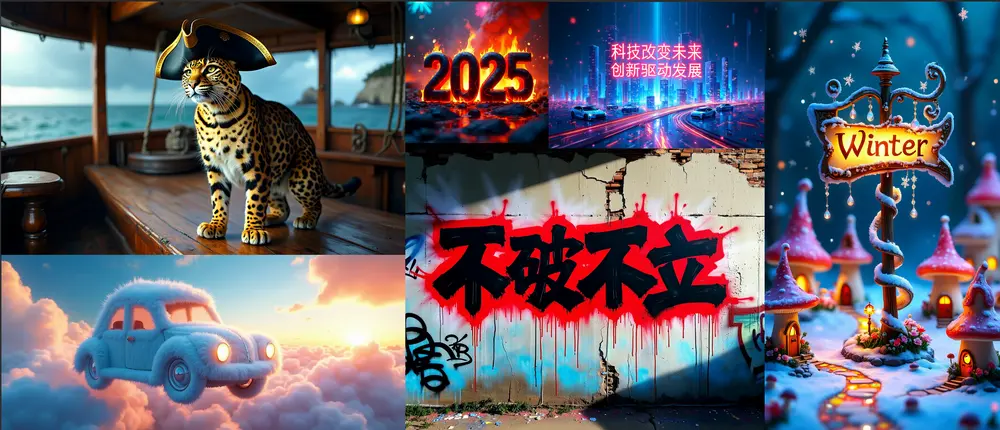
由南京大学、腾讯优图等机构联合提出的 L2P (Latent-to-Pixel) 技术,为高分辨率图像生成提供了一条全新的低成本路径。作为一种高效的迁移范式,L2P 能够将预训练隐空间扩散模型(LDM)的知识无缝迁移到像素空间,仅需 8 张 GPU 和 零真实数据,即可实现高质量、端到端的像素级生成,并原生支持 4K 超高分辨率输出。
- 项目主页:https://nju-pcalab.github.io/projects/L2P
- GitHub:https://github.com/TencentYoutuResearch/T2I-L2P
- 模型:https://huggingface.co/zhen-nan/L2P
基于此技术,开发团队还推出了 L2P-z-image,展示了该范式在主流模型上的强大适用性。
核心痛点:为何需要 L2P?
当前图像生成领域面临两大困境:
- 隐空间模型(LDM)的局限:依赖 VAE 进行压缩和解码,不仅丢失高频细节,且 VAE 显存占用随分辨率平方增长,导致无法原生支持 4K 等超高分辨率生成。
- 像素空间模型的高门槛:从头训练像素扩散模型需要数百张高端显卡和数十亿数据,成本极高,且存在冷启动困难、语义理解能力弱等问题。
L2P 的目标正是以极低算力、零真实数据成本,将 LDM 丰富的语义先验迁移到像素空间,去掉 VAE、保留语义能力、解锁原生 4K。
技术原理:高效迁移的四步走
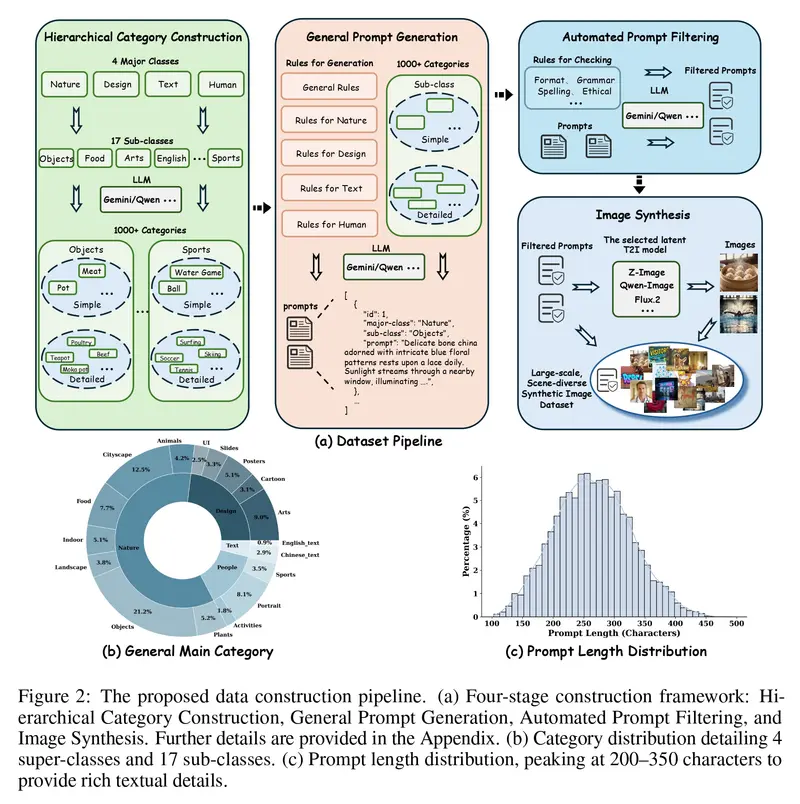
L2P 的核心思路是复用 LDM 的 DiT 主干,仅训练浅层网络学习“隐空间→像素空间”的转换,并利用 LDM 生成的合成图像作为唯一训练语料。
1. 零成本合成数据集构建
- 层级类别设计:定义自然、设计、人物、文本等 4 大组、17 子类、1000+ 细分类别。
- LLM 生成提示词:利用大语言模型生成 200–350 字符的长文本提示词,确保描述丰富。
- 自动化过滤与合成:经过格式、语法及安全校验后,使用源 LDM 生成高质量图像。这种“自产自销”的数据分布平滑,无需采集任何真实图片。
2. 网络架构改造:抛弃 VAE,大 Patch 化
- 直接像素输入:不再经过 VAE编码,而是将 RGB 像素图通过 16×16 大 Patch 进行 Token 化,保持序列长度与原 LDM 一致,确保计算效率。
- 冻结主干,微调浅层:冻结 DiT 中间所有层,保留 LDM 强大的语义先验;仅训练输入投影层、DiT 首尾少量浅层以及新增的 Detailer Head(轻量 U-Net,负责恢复高频细节)。
3. 原生 4K 生成优化
- Patch 自适应扩展:在 4K 分辨率下,将 Patch 尺寸从 16×16 扩至 64×64,有效控制序列长度,避免显存爆炸。
- 增强噪声偏移(Noise Shift):提升噪声强度,破坏 4K 像素的局部相关性,强制模型学习全局结构而非琐碎局部重建。
- 性能飞跃:相比传统 LDM,L2P 在 4K 推理时延降低 97.67%,峰值显存降低 38.81%。
实验结果:小算力撬动大性能
以 Z-Image 为源模型,仅用 8 张 GPU 和 20k 合成数据进行训练,L2P 取得了令人瞩目的成果:
1. 1K 分辨率表现
- DPG-Bench:得分 86.00,甚至超过了源模型 Z-Image-turbo(84.86)。
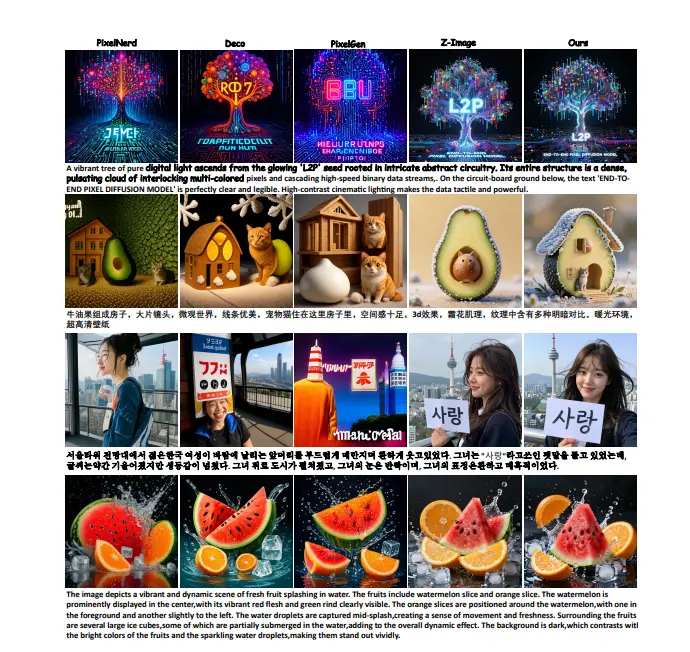
- GenEval:达到源模型 93.6% 的性能,且在所有像素扩散模型中排名第一,多样性远优于 PixelGen 等竞品。
2. 4K 超高分表现
- 画质最优:FID 和 FID-patch 指标均为最低,无过度平滑或伪影,细节锐利。
- 能力解锁:源 LDM 无法直接生成 4K,而 L2P 完美解锁了这一能力,且在图文对齐(CLIP Score)和多样性(IS)上领先 SOTA。
3. 高效性验证
- 数据效率:仅 20k 数据即达到性能饱和,继续增加数据无明显增益。
- 训练策略:仅训练浅层(5 层)效果最佳,全量微调反而破坏预训练先导致效果下降。
优势总结
- 极致低成本:8 张 GPU 即可完成训练,无需昂贵的大规模集群。
- 零数据依赖:完全基于合成数据,规避了版权和采集成本问题。
- 原生 4K/8K 支持:彻底摆脱 VAE 内存瓶颈,实现真正的高分辨率端到端生成。
- 架构通用性强:可适配 FLUX、SD3、Z-Image 等主流 LDM 架构,无需修改主干。
- 推理高效:大幅降低高分辨率生成的显存占用和延迟。
局限性
尽管表现卓越,L2P 仍存在一些局限:
- 上限受限于源模型生成能力无法超越源 LDM 的知识边界。
- 缺乏像素专属优化:尚未引入像素空间特有的感知损失或物理约束。
未来工作方向包括融合少量真实数据以突破源模型上限、设计像素空间专用损失函数,以及将该范式拓展至视频和 3D 生成领域。
© 版权声明
文章版权归作者所有,未经允许请勿转载。