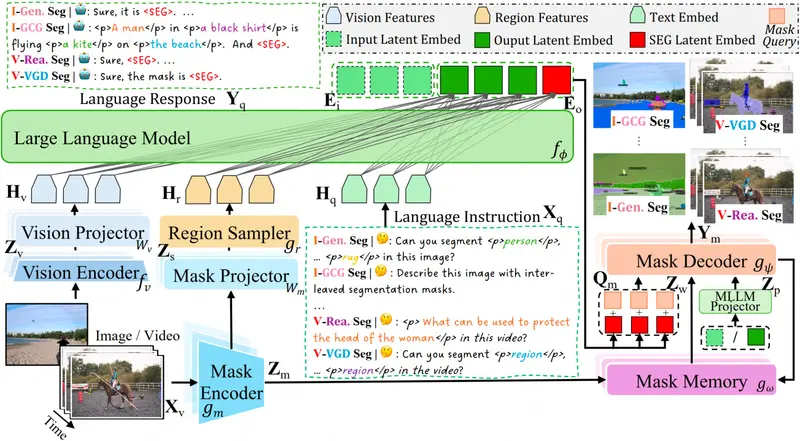
X2SAM:中山大学发布统一图像-视频分割 MLLM,一句话精准圈出任意物体,支持对话式交互与稳定追踪在多模态大语言模型(MLLM)飞速发展的今天,AI 已经能流畅地“看图说话”,但在像素级精准感知——即准确圈出画面中的特定物体——方面仍显笨拙。与此同时,像 SAM(Segment Anything ...图像模型# X2SAM# 图像-视频分割模型6个月前2980